

Opt out dall'addestramento AI in robots.txt di Google: cosa cambia con la nuova regola
Risposta breve
Il 30 ottobre 2026 Google ha annunciato che sta lavorando con altre aziende di intelligenza artificiale a un segnale condiviso in robots.txt. Permetterebbe ai proprietari di siti di fare opt out dall'addestramento AI in un unico punto, invece di elencare ogni crawler AI separatamente. Il controllo è solo proposto, non è ancora attivo e non è stata confermata una data di rilascio. Fino al suo lancio, le regole esistenti in robots.txt per crawler come Google-Extended e GPTBot continuano a funzionare allo stesso modo.
Un proprietario di sito legge un titolo su Google che permette ai siti di fare opt out dall'addestramento AI tramite robots.txt.
Apre il file robots.txt, pronto ad aggiungere la nuova riga.
Non c'è ancora nulla da aggiungere.
Ecco la differenza tra il titolo e l'annuncio vero e proprio. Google ha detto di stare lavorando a un segnale opt out addestramento AI robots.txt Google, sviluppato insieme ad altre aziende di AI, ma non è ancora disponibile e non esiste alcuna nuova direttiva pubblicata da usare oggi.
Ecco cosa ha annunciato Google il 30 ottobre 2026, cosa funziona già adesso per controllare i crawler AI e cosa verificare sul proprio sito finché la proposta resta una proposta.
Cosa ha annunciato Google il 30 ottobre 2026
Il 30 ottobre 2026 Google ha detto di stare sviluppando un segnale condiviso che i proprietari di siti potrebbero aggiungere al file robots.txt per fare opt out dall'uso dei propri contenuti per addestrare i modelli di AI.
L'annuncio descriveva il tutto come una proposta in sviluppo, non come una funzione attivata quel giorno. Google l'ha presentata come un primo passo, un lavoro che sta portando avanti con altre aziende che gestiscono crawler AI, più che come una specifica definitiva pronta per la pubblicazione.
Questa distinzione conta per chiunque aggiorni un file robots.txt questa settimana. Il 30 ottobre non è cambiato nulla nel funzionamento di robots.txt. Non esiste alcun nuovo token da aggiungere e nessuna regola esistente si comporta diversamente per effetto dell'annuncio.
L'idea di fondo della proposta
Stando alla descrizione, l'idea è una singola direttiva che più aziende di AI riconoscerebbero come «non usare questi contenuti per addestrare modelli di AI». Il proprietario del sito la aggiungerebbe una volta sola, in un unico file, invece di mantenere una regola separata per ogni crawler AI che potrebbe leggere il sito.
È un'idea sostanzialmente diversa dal bloccare un crawler del tutto. Oggi bloccare un crawler perché non scarichi una pagina è una decisione separata dal dire a un'azienda di non usare per l'addestramento contenuti già scaricati. La proposta punta al secondo caso: un modo condiviso per esprimere una preferenza sull'addestramento, non un sostituto dei permessi di scansione già esistenti.
Perché Google parla di un progetto collettivo e non solo di Google
L'annuncio di Google ha ripetutamente presentato lo sforzo come trasversale all'intero settore, e non come qualcosa che Google definirebbe da sola aspettandosi che gli altri la seguano. Un segnale funziona solo se le aziende che leggono i file robots.txt concordano su cosa significhi, quindi Google ha detto di essersi confrontata con altre aziende che gestiscono crawler AI sull'adozione dello stesso approccio.
Anche questo è una necessità pratica. Robots.txt funziona da decenni perché i crawler del web concordano, in modo informale, nel leggerlo e rispettarlo allo stesso modo. Un opt out dall'addestramento che fosse rispettato da una sola azienda direbbe poco al proprietario di un sito su cosa succede ai suoi contenuti altrove.
Perché un segnale condiviso invece di regole separate per ogni crawler
Oggi un proprietario di sito che vuole esprimere una preferenza a più crawler AI deve farlo un user agent alla volta.
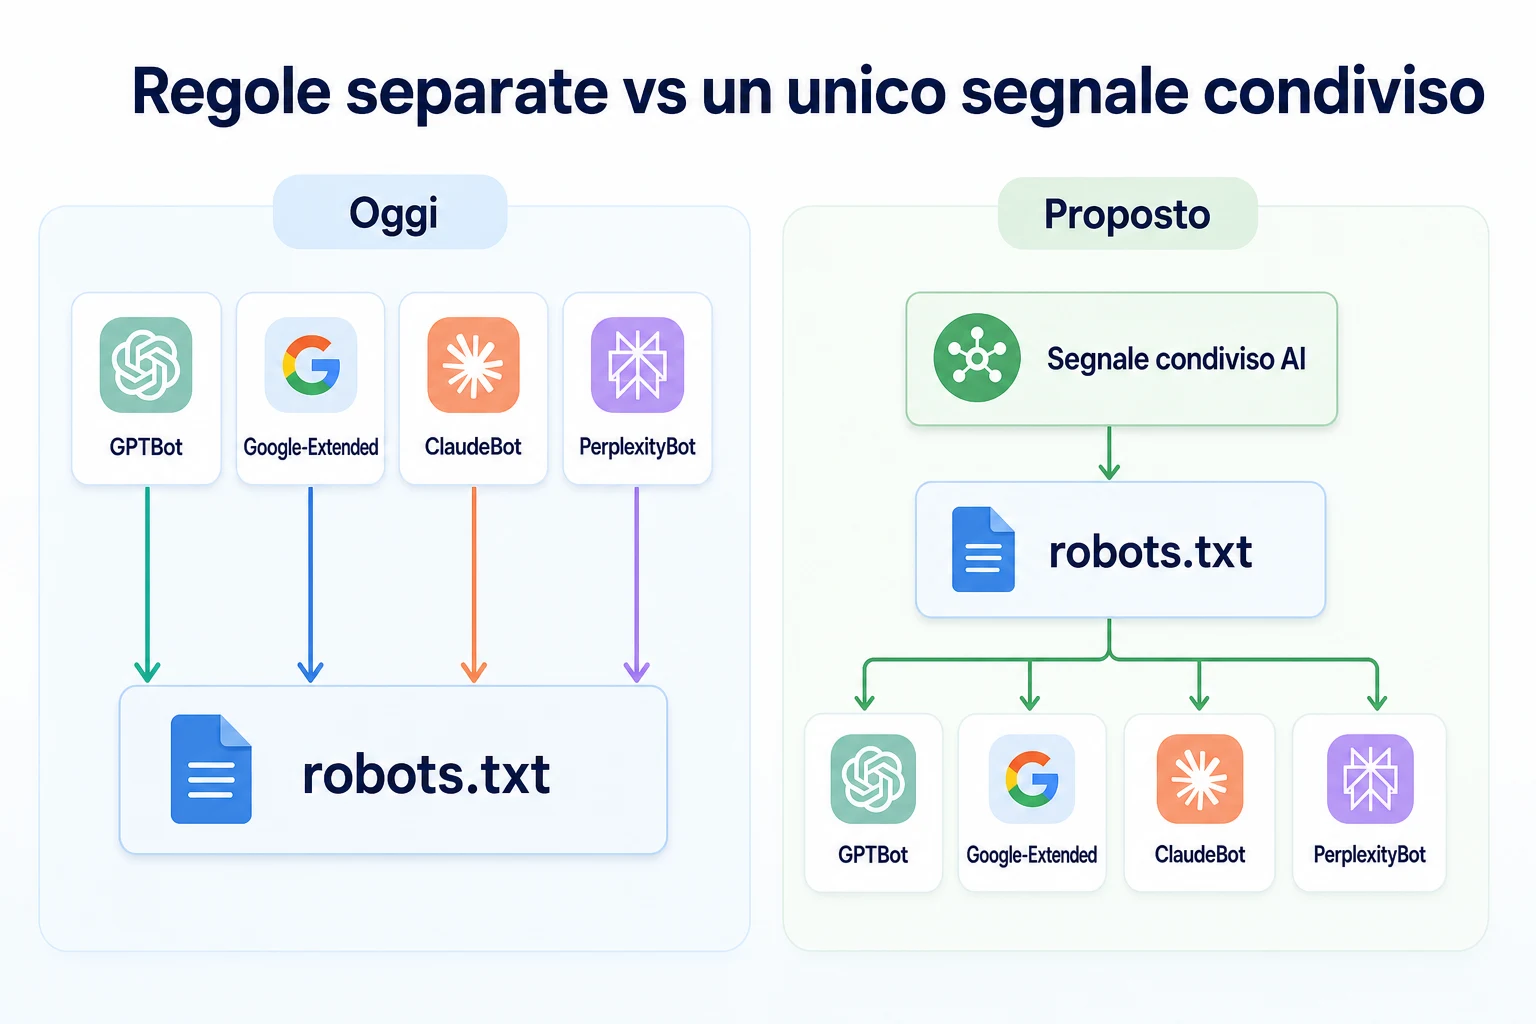
L'attuale mosaico di regole per crawler
Ogni azienda di AI che scansiona il web per l'addestramento o per il recupero in tempo reale pubblica un proprio crawler, identificato da un proprio token user agent in robots.txt. Bloccarne uno non blocca gli altri. Una regola scritta per il token di un crawler non ha effetto sul bot di un'altra azienda, anche se l'intenzione dietro entrambe le regole è la stessa. La nostra guida agli esempi di user agent spiega quali token appartengono a quali crawler e come distinguerli in un file robots.txt.
Per un proprietario di sito che vuole fare opt out dall'addestramento AI in generale, questo significa elencare per nome ogni crawler di addestramento AI noto e rivedere l'elenco ogni volta che ne compare uno nuovo. Al momento non esiste una riga unica che li copra tutti.
Cosa cambierebbe in pratica un segnale condiviso
Se la proposta arrivasse nella forma descritta, il proprietario di un sito scriverebbe una sola direttiva pensata per segnalare una preferenza sull'addestramento a ogni azienda che accettasse di rispettarla, invece di ripetere la stessa intenzione in un elenco sempre più lungo di token separati.
Questo semplificherebbe la manutenzione, ma non eliminerebbe la necessità di capire cosa viene effettivamente scansionato. Un segnale condiviso per l'addestramento, per come è descritto, sarebbe letto solo dalle aziende che scelgono di rispettarlo. Un crawler che non riconosce o non rispetta la direttiva la ignorerebbe, come qualsiasi crawler può scegliere di ignorare una regola di robots.txt che non riconosce oggi.
Quali fornitori di AI hanno espresso sostegno
L'annuncio di Google ha citato alcune altre aziende che, a suo dire, sono coinvolte nelle prime discussioni sulla proposta. Vale la pena essere precisi su cosa significhi e cosa no.
Cosa è stato confermato finora
Google ha descritto lo sforzo come un confronto con altre aziende di AI che gestiscono crawler, non come un accordo firmato già in vigore. Essere citati in quel confronto non equivale a una pubblicazione, da parte di un'azienda, di un impegno proprio a rispettare una specifica direttiva una volta che esisterà.
A questo punto la conferma più affidabile della posizione di un'azienda è la sua stessa documentazione, pubblicata sul proprio sito. L'annuncio di Google è il posto giusto per capire cosa propone Google. Non sostituisce una dichiarazione separata di un fornitore di AI su come intende leggere o rispettare il segnale.
Cosa resta poco chiaro sulla partecipazione
Sulla base di quanto è pubblico, diversi aspetti non sono ancora definiti. Non si sa se tutte le aziende citate nelle prime discussioni adotteranno la specifica finale una volta pubblicata, se tutte la rispetteranno allo stesso modo e se aziende non menzionate potranno aderire in seguito.
Non è nemmeno chiaro se la partecipazione sarebbe uniforme. Un'azienda potrebbe, in linea di principio, accettare di riconoscere il segnale per alcuni dei propri prodotti o crawler e non per altri, come le aziende di AI già tracciano linee diverse tra un crawler usato per l'addestramento e uno usato per il recupero in tempo reale quando qualcuno fa una domanda. Nulla di tutto questo è stato ancora spiegato nel dettaglio.
Il rilascio previsto: cosa è confermato e cosa no
L'annuncio di Google non includeva una data di lancio. Descriveva la proposta come un lavoro ancora in corso, con un periodo di feedback o di test davanti, piuttosto che un rilascio immediato.
Cosa dice Google che succederà dopo
Google ha detto che intende continuare a perfezionare la proposta con le altre aziende coinvolte prima di pubblicare una specifica finale che i proprietari di siti possano effettivamente implementare. La sintassi della direttiva non è ancora stata pubblicata. Quindi non c'è un nome confermato per la nuova riga, non c'è un formato confermato e non c'è una risposta confermata su come interagirebbe con le regole Allow e Disallow già presenti in un file robots.txt.
Finché la specifica non sarà pubblicata, qualunque cosa venga scritta sul preciso testo della nuova direttiva sarebbe una supposizione, e conviene trattare ogni supposizione del genere, da qualunque fonte arrivi, con cautela finché Google non la documenterà direttamente.
Perché non c'è ancora alcuna nuova direttiva da aggiungere
È la parte più importante da ripetere con chiarezza: oggi non c'è nulla di nuovo da aggiungere a un file robots.txt a causa di questo annuncio. Le regole esistenti per Google-Extended, GPTBot, ClaudeBot e gli altri crawler AI citati per nome funzionano esattamente come prima del 30 ottobre 2026. Un proprietario di sito che voglia esprimere oggi una preferenza sull'addestramento AI deve ancora farlo nel modo in cui si è sempre fatto, crawler per crawler, usando i token che esistono già.
Il resto di questa guida riguarda questi controlli esistenti, perché sono gli unici che oggi producono davvero effetti su un sito online.
Come funzionerebbe il controllo proposto
Google non ha ancora pubblicato la sintassi esatta della nuova direttiva, quindi nulla di quanto segue descrive un formato confermato. Quello che segue si basa solo su come Google ha descritto la proposta, e va letto come una linea generale e non come una specifica da copiare.
Dove si collocherebbe nel file robots.txt
Robots.txt ha già una struttura ben documentata: una riga con lo user agent, seguita dalle regole Allow e Disallow che si applicano a quello user agent. L'introduzione di Google a robots.txt spiega come funziona questa struttura e cosa è pensata per controllare. Un segnale condiviso per l'addestramento, così come descritto, si collocherebbe nello stesso formato di file invece di sostituirlo. La forma più probabile, in base a come Google ha inquadrato l'idea, è una nuova tipologia di direttiva riconosciuta tra i blocchi dei singoli user agent, piuttosto che un file separato o un'impostazione fuori da robots.txt.
Questo è importante perché significa che un opt out dall'addestramento AI in robots.txt, una volta pubblicato, probabilmente vivrebbe accanto alle regole Allow e Disallow che un sito già possiede, e non in un posto nuovo che i proprietari dovrebbero andare a cercare.
In cosa si differenzia da una regola Disallow
Una regola Disallow dice a un crawler di non scaricare affatto una pagina. È un'istruzione di scansione: il crawler richiede la pagina oppure non la richiede.
Un opt out dall'addestramento, per come l'ha descritto Google, è un tipo di istruzione diverso. Si applicherebbe a contenuti che un crawler può ancora essere autorizzato a scaricare, e dichiarerebbe invece come quei contenuti possono essere usati in seguito. È una differenza significativa. Un'azienda potrebbe, in linea di principio, continuare a scansionare una pagina per uno scopo diverso, come verificare che la pagina esista o indicizzarla per un prodotto separato dall'addestramento, pur rispettando la richiesta di non usare quel contenuto come dato di addestramento.
Finché la specifica finale non sarà pubblica, non è confermato se il nuovo segnale affiancherà una regola Disallow, in alcuni casi ne sostituirà la necessità, o funzionerà in modo indipendente dai permessi di scansione. La documentazione di Google su come funziona robots.txt è il miglior riferimento attuale per le regole che esistono oggi, e conviene ricontrollarla quando Google la aggiornerà con la nuova direttiva.
I controlli sui crawler che esistono già oggi
Nessuna delle incertezze sopra dovrebbe frenare il proprietario di un sito dall'usare i controlli già documentati e già funzionanti. Si applicano adesso, indipendentemente da quando arriverà il segnale condiviso.
Google-Extended e l'addestramento AI di Google
Google pubblica già un controllo separato per i crawler chiamato Google-Extended, dedicato all'addestramento AI e ai prodotti Google correlati, distinto dal Googlebot stesso. La documentazione di Google su Google-Extended spiega cosa blocca e cosa non influisce. Vietare Google-Extended in robots.txt non rimuove un sito dalla Ricerca Google. Influisce solo sul fatto che quei contenuti vengano usati per i prodotti specifici governati da Google-Extended.
Altri token dei crawler AI da conoscere
Altre aziende di AI pubblicano i propri token per i crawler nello stesso modo, ciascuno con un nome e uno scopo documentato. GPTBot, ClaudeBot e PerplexityBot sono tra quelli più comunemente visti, e ognuno si comporta indipendentemente dagli altri. Bloccarne uno non ha effetto sul fatto che gli altri continuino a scansionare un sito. Il Controllo crawler AI gratuito di RepGet verifica un sito su diversi di questi contemporaneamente, un modo più rapido per capire cosa è attualmente consentito rispetto a controllare ogni token a mano.
llms.txt come convenzione separata, non la stessa cosa
Un'idea correlata ma diversa è llms.txt, una convenzione descritta su llmstxt.org per fornire ai sistemi AI un riassunto chiaro dei contenuti di un sito in un unico file. Vale la pena essere chiari: llms.txt non è lo stesso meccanismo di robots.txt, e non è nemmeno il segnale di addestramento proposto da Google. È una convenzione informale che alcuni siti pubblicano per rendere i loro contenuti più facili da leggere e riassumere per un sistema AI, non un permesso di scansione né un opt out dall'addestramento.
Nome del crawler | Azienda a cui appartiene | Cosa influisce davvero il blocco |
|---|---|---|
Googlebot | Se le pagine compaiono nei risultati della Ricerca Google | |
Google-Extended | Se i contenuti vengono usati per l'addestramento AI e funzioni correlate, separatamente dalla Ricerca | |
GPTBot | OpenAI | Se i contenuti vengono scansionati per l'addestramento AI di quell'azienda, documentato sul suo sito |
ClaudeBot | Anthropic | Se i contenuti vengono scansionati per l'addestramento AI di quell'azienda, documentato sul suo sito |
PerplexityBot | Perplexity | Se i contenuti vengono scansionati per i prodotti AI di quell'azienda, documentato sul suo sito |
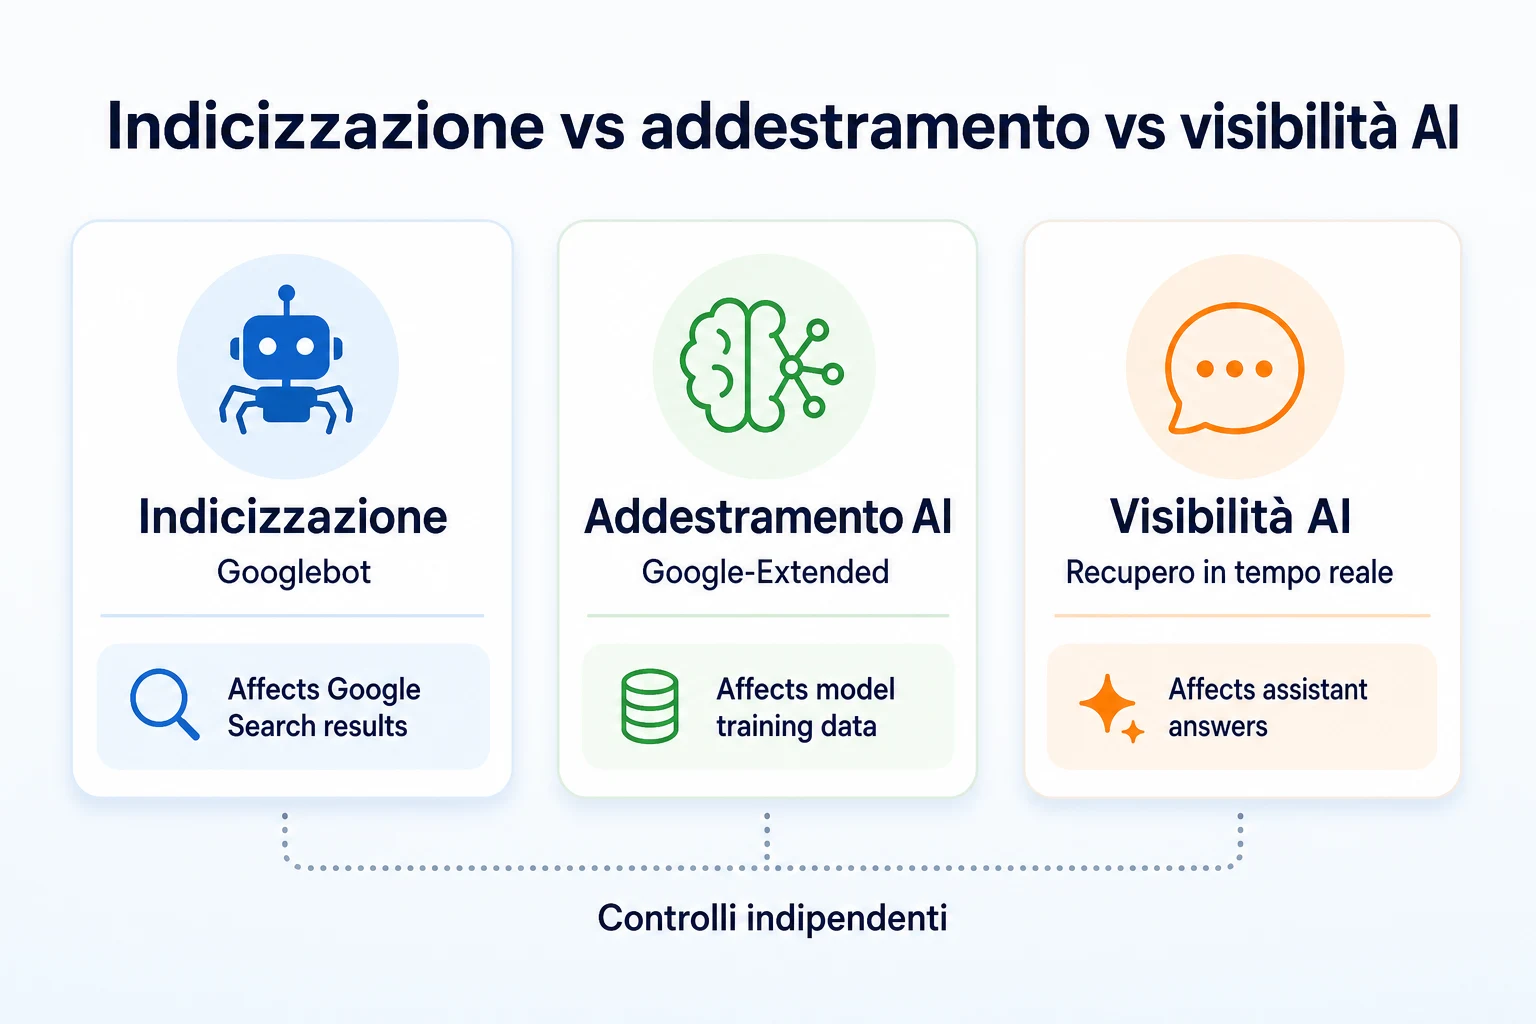
Addestramento AI, indicizzazione nella Ricerca e visibilità AI: tre cose diverse
Gran parte della confusione su questo annuncio nasce dal trattare questi tre aspetti come una cosa sola. Non lo sono, e si controllano separatamente.
Indicizzazione nella Ricerca: Googlebot
L'indicizzazione nella Ricerca è gestita da Googlebot. È ciò che determina se una pagina può comparire come risultato nella Ricerca Google. Bloccare Googlebot rimuove un sito dai risultati di ricerca. Non ha nulla a che fare con l'addestramento AI, perché Googlebot e Google-Extended sono crawler separati con scopi documentati distinti.
Addestramento AI: Google-Extended e token simili
L'addestramento AI è un processo separato, regolato da token come Google-Extended e dagli altri crawler elencati sopra. Questi controllano se i contenuti vengono usati per addestrare un modello, non se quei contenuti compaiono nei risultati di ricerca. Un sito può bloccare Google-Extended e comparire normalmente nella Ricerca Google, perché si tratta di impostazioni indipendenti.
Visibilità AI: cosa succede al momento della domanda
La visibilità AI è di nuovo diversa. È ciò che accade quando qualcuno pone una domanda a un assistente AI e l'assistente recupera o cita informazioni per rispondere, spesso nel momento in cui la domanda viene posta e non da un modello addestrato mesi prima. Bloccare un crawler di addestramento non cambia necessariamente se una pagina può ancora essere letta in tempo reale per questo scopo, perché alcuni assistenti recuperano informazioni separatamente da come sono stati addestrati. La nostra guida su come essere menzionati in ChatGPT approfondisce questa distinzione, incluso il motivo per cui nessun fornitore garantisce che una pagina specifica compaia in una risposta specifica.
Concetto | Meccanismo o crawler coinvolto | Cosa cambia bloccarlo o consentirlo |
|---|---|---|
Indicizzazione nella Ricerca | Googlebot | Se le pagine compaiono nei risultati della Ricerca Google |
Addestramento AI | Google-Extended e token simili | Se i contenuti vengono usati per addestrare modelli AI |
Visibilità AI | Recupero in tempo reale nel momento in cui viene posta una domanda | Se i contenuti possono ancora essere citati nella risposta di un assistente, indipendentemente dalle impostazioni di addestramento |
Un esempio pratico: verificare cosa consente oggi un sito
Immaginiamo una piccola società di commercialisti che ha configurato il proprio file robots.txt due anni fa e non l'ha più toccato. Questo esempio è illustrativo.
Il titolare legge dell'annuncio di Google e decide di controllare cosa dice effettivamente il file prima di presumere che serva un cambiamento. Apre il file direttamente all'indirizzo radice del sito e lo legge riga per riga.
Cosa mostrava davvero il file del sito di esempio
Il file blocca Google-Extended, aggiunto a un certo punto dopo aver letto consigli sull'addestramento AI. Non dice nulla su GPTBot, ClaudeBot o PerplexityBot. Non esiste alcuna regola per nessuno dei tre, il che significa che nessuno di questi è attualmente limitato nella scansione del sito per qualsiasi scopo essi la usino.
Passando lo stesso file nel Controllo robots.txt gratuito di RepGet si conferma la stessa cosa: un verdetto chiaro su Google-Extended e un verdetto aperto sugli altri, senza alcuna regola scritta per loro in un senso o nell'altro. Quella lacuna non era intenzionale. Era semplicemente ciò che il titolare aveva letto due anni prima, quando Google-Extended era l'unico token per crawler AI a ricevere molta attenzione.
Nulla in questo esempio richiede di aspettare la nuova proposta di Google. La lacuna che rivela è qualcosa che si può correggere oggi, usando token già documentati e già funzionanti, che è l'argomento della checklist che segue.
Una checklist di 20 minuti per preparare il tuo sito
Nulla di tutto questo richiede di aspettare che Google pubblichi qualcosa. Una revisione breve adesso significa non dover correre ai ripari quando il nuovo segnale sarà davvero disponibile.
Passaggio | Tempo | Strumento o azione da usare |
|---|---|---|
Apri il file robots.txt attuale e leggi ogni riga | 5 minuti | Visita il file direttamente all'indirizzo principale del tuo sito |
Verifica quali crawler AI sono bloccati, consentiti o non menzionati affatto | 5 minuti | Il AI Crawler Checker gratuito di RepGet |
Definisci una politica semplice: bloccare i crawler di addestramento AI, consentirli oppure rimandare la decisione | 5 minuti | Una breve nota scritta, anche una sola riga in un documento condiviso |
Verifica se un file llms.txt esiste o se vale la pena aggiungerlo | 3 minuti | Il llms.txt Generator gratuito di RepGet |
Imposta un promemoria per rivedere robots.txt quando Google pubblicherà le specifiche definitive | 2 minuti | Una nota nel calendario, dato che non è ancora stata confermata alcuna data |
Venti minuti bastano per trasformare un'ipotesi in una decisione concreta. La maggior parte dei titolari di siti non controlla il proprio file robots.txt da quando è stato configurato per la prima volta, e la differenza tra ciò che dice e ciò che loro credono che dica di solito è piccola, ma vale la pena colmarla prima di aggiungere qualcosa di nuovo.
Errori comuni da evitare per i titolari di siti
Alcuni equivoci ricorrono abbastanza spesso su questo tema da meritare di essere nominati direttamente, separatamente dalla checklist qui sopra.
Errore | Cosa comporta | Come risolverlo |
|---|---|---|
Confondere Google-Extended con Googlebot | Bloccare il token sbagliato e influire per errore sulla visibilità nella Ricerca, oppure pensare che un blocco dell'addestramento copra già la Ricerca | Trattali come due regole separate con scopi separati, e consulta la documentazione ufficiale di Google se non sei sicuro di quale token faccia cosa |
Dare per scontato che l'opt out dall'addestramento AI rimuova una pagina dalle risposte degli assistenti AI | Una falsa sicurezza secondo cui bloccare l'addestramento risolve del tutto la questione della visibilità AI | Ricorda che il recupero in tempo reale al momento della domanda è un meccanismo separato dall'addestramento, e non necessariamente è influenzato allo stesso modo |
Aspettare la proposta di Google non ancora rilasciata prima di fare qualsiasi cosa | Mesi senza alcuna politica per i crawler, anche se i controlli funzionanti esistono già | Usa i token documentati disponibili oggi, e rivedi il file quando il nuovo segnale sarà disponibile |
Considerare llms.txt come se fosse la stessa cosa del segnale di addestramento proposto | Pubblicare un file che non esprime affatto una preferenza sull'addestramento e aspettarsi che lo faccia | Tieni separate le due cose: llms.txt è una convenzione per il riepilogo dei contenuti, non un permesso di crawling o di addestramento |
Il schema di fondo di quasi tutti questi errori è lo stesso che ha causato la confusione in partenza: trattare una proposta ancora in sviluppo come se fosse già una funzione operativa. Non lo è, e leggere questo articolo non cambia nulla.
Dove si inserisce RepGet
RepGet non stabilisce la politica di addestramento AI per un sito, e non monitora la proposta non ancora rilasciata di Google per conto di un'attività. Non c'è ancora nulla da configurare, quindi non c'è nulla che RepGet o qualsiasi altro strumento possa attivare in anticipo.
Ciò con cui RepGet può aiutare è vedere cosa dice davvero il file robots.txt di un sito in questo momento, anziché ciò che il titolare presume che dica. Il suo AI Crawler Checker gratuito verifica un sito con crawler come GPTBot, ClaudeBot e PerplexityBot insieme, e il suo Robots.txt Checker gratuito fornisce un giudizio su ogni regola già presente nel file. Il suo audit del sito web gratuito va ancora oltre, scansionando l'intero sito e assegnando un punteggio SEO da 0 a 100 con i problemi tecnici da verificare, inclusi i problemi di accesso dei crawler che non hanno nulla a che fare con l'AI. Non serve un account né una carta di credito.
RepGet non garantisce un posizionamento, che un opt out dall'addestramento venga rispettato da una specifica azienda di AI, né una menzione nelle risposte di qualsiasi assistente AI. Gli strumenti gratuiti qui sopra mostrano ciò che un sito consente attualmente. La decisione su cosa consentire spetta ancora al titolare del sito.
In sintesi
L'annuncio di Google del 30 ottobre 2026 descrive un segnale condiviso in robots.txt per l'opt out dall'addestramento AI, sviluppato insieme ad altre aziende che gestiscono crawler AI. È una proposta, non una funzione rilasciata. Non è stata pubblicata alcuna sintassi, non è confermata alcuna data di lancio, e non c'è nessuna nuova riga da aggiungere a un file robots.txt a causa del solo annuncio.
Ciò che non è cambiato è tutto ciò che funzionava già prima del 30 ottobre. Google-Extended, GPTBot, ClaudeBot e PerplexityBot sono tutti crawler documentati con i propri token, e un titolare di sito può impostare oggi una politica chiara per ciascuno di essi. Indicizzazione nella Ricerca, addestramento AI e visibilità AI restano tre cose separate, controllate in modo separato, e nessuna singola impostazione le copre tutte e tre insieme. La mossa pratica adesso è usare i controlli che esistono, verificare ciò che dice davvero il file di un sito anziché darlo per scontato, e tenere d'occhio la documentazione successiva di Google prima di modificare altro.
Scopri per prima cosa di cosa ha bisogno il tuo sito
Esegui un audit gratuito del sito web con RepGet per vedere come appaiono oggi le regole per i crawler e i contenuti del tuo sito. Non serve un account né una carta di credito.
Domande frequenti
L'opt out dall'addestramento AI di Google in robots.txt è già attivo?
No. Google ha annunciato che sta sviluppando il segnale con altre aziende di intelligenza artificiale il 30 ottobre 2026, ma non è stata pubblicata alcuna sintassi, specifica o data di lancio, quindi non c'è ancora nulla da aggiungere a un file robots.txt.
Come posso bloccare oggi i crawler di addestramento AI sul mio sito?
Aggiungi regole Disallow per i singoli token dei crawler che vuoi limitare, come Google-Extended, GPTBot, ClaudeBot o PerplexityBot, perché ciascuno funziona in modo indipendente e per ora nessuna regola condivisa li copre tutti.
Qual è la differenza tra Google-Extended e Googlebot?
Googlebot gestisce la comparsa di una pagina nei risultati di Google Search. Google-Extended è un crawler separato e documentato che regola l'addestramento AI e le funzioni collegate, e bloccarne uno non ha effetti sull'altro.
Fare opt out dall'addestramento AI rimuove il mio sito dalle risposte di ChatGPT o Gemini?
Non necessariamente. Molti assistenti AI recuperano le informazioni in tempo reale al momento della domanda, separatamente dall'addestramento, quindi un opt out dall'addestramento non cambia automaticamente ciò che compare in una specifica risposta.
Quali aziende di intelligenza artificiale supportano il segnale proposto da Google per robots.txt?
Google ha detto di essere in contatto con altre aziende che gestiscono crawler AI, ma ha descritto questo come un confronto iniziale e non come un accordo confermato, quindi verifica la documentazione di ogni azienda per conoscere la sua posizione effettiva.
Bloccare i crawler di addestramento AI danneggia il mio posizionamento su Google Search?
No. Bloccare un crawler specifico per l'addestramento come Google-Extended non influisce su Googlebot né sull'indicizzazione in Search, perché si tratta di due controlli separati e documentati in modo indipendente.
Che cos'è llms.txt e coincide con la nuova proposta di Google?
No. llms.txt è una convenzione informale per riassumere i contenuti di un sito affinché i sistemi AI possano leggerli, descritta su llmstxt.org. Non è un permesso di scansione né un opt out dall'addestramento come il segnale proposto da Google.
Quando sarà davvero disponibile il nuovo controllo sull'addestramento AI?
Google non ha indicato una data. L'annuncio descriveva un lavoro in corso con altre aziende e una specifica ancora in fase di definizione, senza una tempistica confermata su quando i proprietari di siti potranno effettivamente applicarlo.