

Google KI-Training Widerspruch per robots.txt: Was die neue Regel bedeutet
Kurze Antwort
Am 30. Oktober 2026 hat Google angekündigt, zusammen mit anderen KI-Unternehmen an einem gemeinsamen robots.txt-Signal zu arbeiten. Damit könnten Websitebetreiber dem KI-Training an einer zentralen Stelle widersprechen, statt jeden KI-Crawler einzeln aufzulisten. Die Steuerung ist ein Vorschlag und noch nicht aktiv, ein Starttermin ist nicht bestätigt. Bestehende robots.txt-Regeln für Crawler wie Google-Extended und GPTBot funktionieren bis zur Einführung unverändert weiter.
Ein Website-Betreiber liest eine Schlagzeile, wonach Google Websites erlaubt, sich per robots.txt vom KI-Training abzumelden.
Er öffnet seine robots.txt-Datei, bereit, die neue Zeile hinzuzufügen.
Es gibt noch keine Zeile, die man hinzufügen könnte.
Das ist die Lücke zwischen der Schlagzeile und der eigentlichen Ankündigung. Google hat gesagt, dass es an einem Google KI-Training Widerspruch robots.txt-Signal arbeitet, das gemeinsam mit anderen KI-Unternehmen entwickelt wird. Es ist aber noch nicht veröffentlicht, und es gibt heute keine neue Anweisung, die Sie verwenden könnten.
Hier erfahren Sie, was Google am 30. Oktober 2026 tatsächlich angekündigt hat, was bereits heute zur Steuerung von KI-Crawlern funktioniert und was Sie auf Ihrer eigenen Website prüfen sollten, solange der Vorschlag noch ein Vorschlag ist.
Was Google am 30. Oktober 2026 angekündigt hat
Am 30. Oktober 2026 hat Google gesagt, dass es ein gemeinsames Signal entwickelt, das Website-Betreiber in ihre robots.txt-Datei eintragen könnten, um zu widersprechen, dass ihre Inhalte zum Training von KI-Modellen verwendet werden.
Die Ankündigung beschrieb dies als Vorschlag in Entwicklung und nicht als Funktion, die an diesem Tag in Betrieb ging. Google stellte es als ersten Schritt dar, an dem es zusammen mit anderen Unternehmen arbeitet, die KI-Crawler betreiben, und nicht als fertige Spezifikation, die schon veröffentlicht werden kann.
Dieser Unterschied ist für alle wichtig, die diese Woche eine robots.txt-Datei aktualisieren. Am 30. Oktober hat sich an der Funktionsweise der robots.txt nichts geändert. Es gibt kein neues Token, das man hinzufügen könnte, und keine bestehende Regel verhält sich wegen der Ankündigung anders.
Die Kernidee hinter dem Vorschlag
Der beschriebene Gedanke ist eine einzige Anweisung, die mehrere KI-Unternehmen als Aufforderung erkennen würden, diese Inhalte nicht zum Training von KI-Modellen zu verwenden. Ein Website-Betreiber würde sie einmal in einer einzigen Datei eintragen, statt für jeden KI-Crawler, der die Website lesen könnte, eine eigene Regel zu pflegen.
Das ist eine deutlich andere Idee als das vollständige Sperren eines Crawlers. Heute ist das Sperren eines Crawlers, damit er eine Seite überhaupt abruft, eine andere Entscheidung als die Bitte an ein Unternehmen, bereits abgerufene Inhalte nicht für das Training zu verwenden. Der Vorschlag zielt auf den zweiten Fall: einen gemeinsamen Weg, eine Trainingspräferenz auszudrücken, und keinen Ersatz für bestehende Crawl-Berechtigungen.
Warum Google das gemeinsam angeht und nicht allein
Google hat die Initiative in seiner Ankündigung immer wieder als branchenübergreifend dargestellt und nicht als etwas, das es allein festlegt und das andere dann übernehmen sollen. Ein Signal funktioniert nur, wenn sich die Unternehmen, die robots.txt-Dateien lesen, darauf einigen, was es bedeutet. Deshalb hat Google gesagt, dass es mit anderen Unternehmen spricht, die KI-Crawler betreiben, über eine Übernahme desselben Ansatzes.
Das ist auch praktisch notwendig. Die robots.txt funktioniert seit Jahrzehnten, weil sich Crawler im Netz stillschweigend darauf einigen, sie gleich zu lesen und zu respektieren. Ein Widerspruch gegen das KI-Training, den nur ein einziges Unternehmen beachtet, würde einem Website-Betreiber wenig darüber sagen, was mit seinen Inhalten überall sonst geschieht.
Warum ein gemeinsames Signal statt einzelner Regeln pro Crawler
Wer gegenüber mehreren KI-Crawlern eine Präferenz ausdrücken möchte, muss das heute für jeden User-Agent einzeln tun.
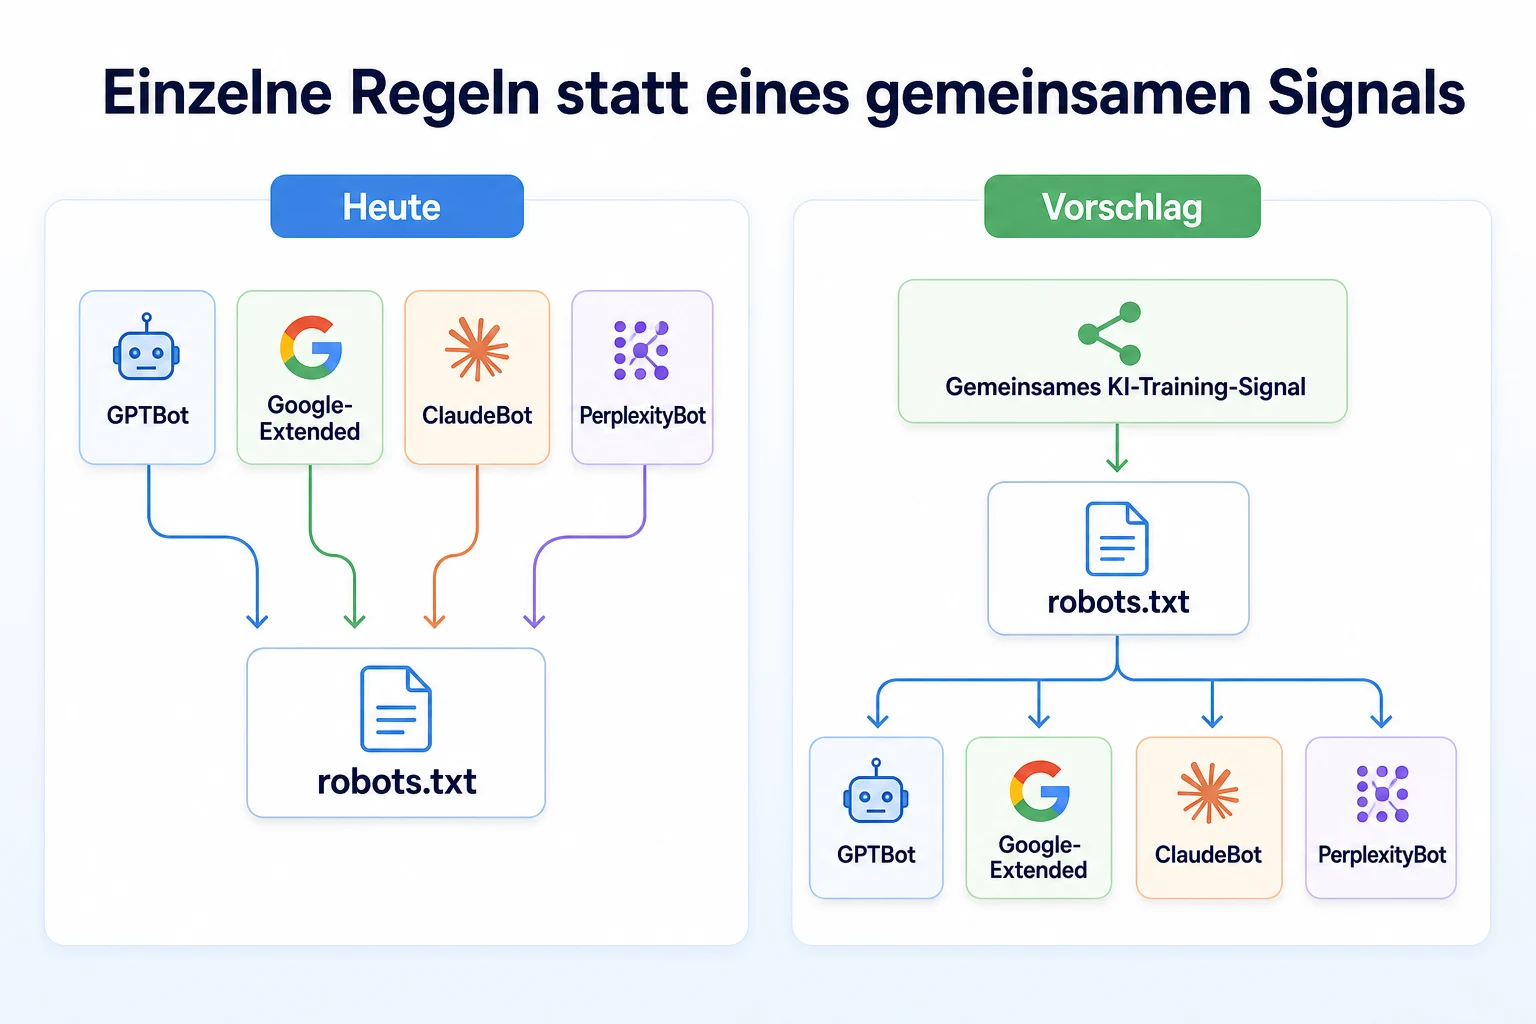
Das heutige Flickwerk einzelner Regeln pro Crawler
Jedes KI-Unternehmen, das das Netz für das Training oder für den Abruf in Echtzeit durchsucht, betreibt seinen eigenen Crawler, der in der robots.txt über ein eigenes User-Agent-Token erkannt wird. Eine Sperre für den einen blockiert den anderen nicht. Eine Regel für das Token eines Crawlers hat keine Wirkung auf den Bot eines anderen Unternehmens, auch wenn beide Regeln dieselbe Absicht verfolgen. Unser Leitfaden zu User-Agent-Beispielen zeigt, welche Tokens zu welchen Crawlern gehören und wie Sie sie in einer robots.txt-Datei voneinander unterscheiden.
Wenn Sie breit gegen das KI-Training widersprechen möchten, bedeutet das, jeden bekannten KI-Trainings-Crawler namentlich aufzulisten und die Liste zu überarbeiten, sobald ein neuer auftaucht. Es gibt derzeit keine einzelne Zeile, die sie alle auf einmal abdeckt.
Was ein gemeinsames Signal in der Praxis ändern würde
Würde der Vorschlag wie beschrieben umgesetzt, könnten Sie eine einzige Anweisung schreiben, die jedem Unternehmen eine Trainingspräferenz signalisiert, das sich verpflichtet hat, sie zu beachten. Sie müssten dieselbe Absicht nicht mehr für eine wachsende Liste einzelner Tokens wiederholen.
Das würde die Pflege vereinfachen, aber die Notwendigkeit nicht beseitigen, zu verstehen, was tatsächlich gecrawlt wird. Ein gemeinsames Trainingssignal, so wie es beschrieben ist, würde nur von Unternehmen gelesen, die es beachten wollen. Ein Crawler, der die Anweisung nicht erkennt oder nicht respektiert, würde sie einfach ignorieren, so wie jeder Crawler heute eine robots.txt-Regel ignorieren kann, die er nicht kennt.
Welche KI-Anbieter Unterstützung signalisiert haben
In Googles Ankündigung wurden einige weitere Unternehmen genannt, die laut Google an den frühen Gesprächen über den Vorschlag beteiligt sind. Es lohnt sich, genau zu sein, was das bedeutet und was nicht.
Was bisher bestätigt ist
Google beschreibt die Initiative als Austausch mit anderen KI-Unternehmen, die Crawler betreiben, und nicht als bereits geschlossene Vereinbarung. Dass ein Unternehmen in diesem Austausch genannt wird, ist nicht dasselbe wie eine eigene Verpflichtung, eine bestimmte Anweisung zu beachten, sobald sie existiert.
Die verlässlichste Bestätigung für die Haltung eines Unternehmens ist derzeit dessen eigene, auf der eigenen Website veröffentlichte Dokumentation. Googles Ankündigung zeigt, was Google vorschlägt. Sie ersetzt aber nicht die eigene Erklärung eines KI-Anbieters, wie er das Signal lesen oder respektieren will.
Was bei der Teilnahme noch offen ist
Nach dem, was öffentlich ist, sind mehrere Fragen noch nicht geklärt. Ob alle genannten Unternehmen die endgültige Spezifikation übernehmen, sobald sie veröffentlicht ist, ob alle sie gleich beachten werden und ob später auch Unternehmen dazukommen, die bisher nicht erwähnt wurden, ist offen.
Auch ist nicht klar, ob die Teilnahme einheitlich wäre. Ein Unternehmen könnte grundsätzlich zusagen, das Signal für einige seiner Produkte oder Crawler anzuerkennen, für andere aber nicht, ähnlich wie KI-Unternehmen heute schon zwischen einem Crawler für das Training und einem Crawler für den Abruf in dem Moment unterscheiden, in dem jemand eine Frage stellt. Dazu wurde bisher nichts im Detail ausgeführt.
Der geplante Rollout: Was bestätigt ist und was nicht
Googles Ankündigung nannte kein Startdatum. Sie beschrieb den Vorschlag als etwas, das noch ausgearbeitet wird, mit einer Phase für Rückmeldungen oder Tests vor einer, aber nicht sofortigen, Veröffentlichung.
Was Google als Nächstes sagt
Google hat gesagt, dass es den Vorschlag zusammen mit den beteiligten Unternehmen weiter verfeinern will, bevor es eine endgültige Spezifikation veröffentlicht, die Website-Betreiber tatsächlich umsetzen können. Die Syntax der Anweisung selbst wurde noch nicht veröffentlicht. Es gibt also weder einen bestätigten Namen für die neue Zeile noch ein bestätigtes Format und keine bestätigte Antwort darauf, wie sie mit den bestehenden Allow- und Disallow-Regeln in einer robots.txt-Datei zusammenwirkt.
Bis diese Spezifikation veröffentlicht ist, wären alle Aussagen über den genauen Wortlaut der neuen Anweisung Vermutungen. Solche Vermutungen sollten Sie, egal aus welcher Quelle, mit Vorsicht behandeln, bis Google sie direkt dokumentiert.
Warum es noch keine neue Regel zum Eintragen gibt
Das ist der Teil, den man am deutlichsten wiederholen sollte: Wegen dieser Ankündigung gibt es heute nichts Neues, das Sie in eine robots.txt-Datei eintragen könnten. Die bestehenden Regeln für Google-Extended, GPTBot, ClaudeBot und andere genannte KI-Crawler funktionieren genau so wie vor dem 30. Oktober 2026. Wer heute eine Präferenz zum KI-Training ausdrücken will, muss dies weiterhin wie bisher tun, Crawler für Crawler, mit den bereits bestehenden Tokens.
Der Rest dieses Leitfadens behandelt diese bestehenden Steuerungsmöglichkeiten, denn nur sie wirken auf einer Live-Website tatsächlich schon heute.
So würde die vorgeschlagene Steuerung funktionieren
Google hat die genaue Syntax für die neue Anweisung noch nicht veröffentlicht, daher beschreibt nichts hier ein bestätigtes Format. Was folgt, basiert nur darauf, wie Google den Vorschlag beschrieben hat. Es lohnt sich, das als allgemeine Form zu lesen und nicht als Spezifikation zum Nachbauen.
Wo sie in der robots.txt stehen würde
Die robots.txt hat bereits einen gut dokumentierten Aufbau: eine Zeile mit dem User-Agent, gefolgt von Allow- und Disallow-Regeln, die für diesen User-Agent gelten. Googles eigene Einführung in die robots.txt erklärt, wie dieser Aufbau funktioniert und wofür er gedacht ist. Ein gemeinsames Trainingssignal würde, wie beschrieben, im selben Dateiformat stehen und dieses nicht ersetzen. Die wahrscheinlichste Form, basierend darauf, wie Google die Idee dargestellt hat, ist eine neue Art von Anweisung, die über User-Agent-Blöcke hinweg erkannt wird, statt einer separaten Datei oder einer Einstellung außerhalb der robots.txt.
Das ist wichtig, denn es bedeutet, dass ein Widerspruch gegen KI-Training, sobald er veröffentlicht ist, wahrscheinlich neben den Allow- und Disallow-Regeln stehen würde, die eine Website bereits hat. Er läge nicht an einem neuen Ort, den Eigentümer erst suchen müssten.
Worin er sich von einer Disallow-Regel unterscheidet
Eine Disallow-Regel weist einen Crawler an, eine Seite gar nicht erst abzurufen. Sie ist eine Anweisung zum Crawling: Der Crawler fragt die Seite entweder ab oder er tut es nicht.
Ein Widerspruch gegen KI-Training, so wie Google ihn beschrieben hat, ist eine andere Art von Anweisung. Er würde für Inhalte gelten, die ein Crawler möglicherweise weiterhin abrufen darf, und stattdessen aussagen, wofür diese Inhalte danach verwendet werden dürfen. Das ist ein bedeutender Unterschied. Ein Unternehmen könnte im Prinzip weiterhin eine Seite crawlen, um einem anderen Zweck zu dienen, etwa um zu prüfen, ob eine Seite existiert, oder um sie für ein Produkt außerhalb des Trainings zu indexieren. Dennoch könnte es einer Bitte nachkommen, diese Inhalte nicht als Trainingsdaten zu nutzen.
Solange die finale Spezifikation nicht öffentlich ist, ist nicht bestätigt, ob das neue Signal neben einer Disallow-Regel stehen würde, in manchen Fällen eine solche ersetzen würde oder unabhängig von den Crawling-Berechtigungen funktioniert. Googles Dokumentation zur Funktionsweise der robots.txt ist die beste aktuelle Referenz für die Regeln, die es heute schon gibt. Es lohnt sich, dort nachzusehen, sobald Google sie um die neue Anweisung ergänzt.
Die Crawler-Steuerungen, die es heute bereits gibt
Keine der oben genannten Unsicherheiten sollte einen Website-Betreiber davon abhalten, die bereits dokumentierten und bereits funktionierenden Steuerungen zu nutzen. Diese gelten jetzt, unabhängig davon, wann das gemeinsame Signal erscheint.
Google-Extended und Googles KI-Training
Google veröffentlicht bereits eine eigene Crawler-Steuerung namens Google-Extended, speziell für KI-Training und verwandte Google-Produkte, getrennt vom Googlebot selbst. Googles eigene Dokumentation zu Google-Extended erklärt, was das Blockieren bewirkt und was nicht. Eine Disallow-Regel für Google-Extended in der robots.txt entfernt eine Website nicht aus der Google-Suche. Sie betrifft nur, ob Inhalte für die konkreten Produkte verwendet werden, die Google-Extended steuert.
Weitere KI-Crawler-Kennungen, die sich lohnt zu kennen
Andere KI-Unternehmen veröffentlichen ihre eigenen Crawler-Kennungen auf dieselbe Weise, jeweils mit eigenem Namen und eigenem dokumentierten Zweck. GPTBot, ClaudeBot und PerplexityBot gehören zu den häufiger anzutreffenden und arbeiten jeweils unabhängig voneinander. Das Blockieren einer Kennung hat keinen Einfluss darauf, ob die anderen weiterhin eine Website crawlen. Mit dem kostenlosen KI-Crawler-Checker von RepGet lässt sich eine Website gleich gegen mehrere davon prüfen. Das ist schneller, als jede Kennung einzeln zu kontrollieren, um zu sehen, was derzeit erlaubt ist.
llms.txt als eigenständige Konvention, nicht dasselbe
Eine verwandte, aber andere Idee ist llms.txt, eine Konvention, die unter llmstxt.org beschrieben wird. Sie soll KI-Systemen eine klare Zusammenfassung des Inhalts einer Website in einer einzigen Datei bereitstellen. Es ist wichtig klarzustellen, dass llms.txt nicht derselbe Mechanismus wie die robots.txt ist und auch nicht dasselbe wie das vorgeschlagene Trainingssignal von Google. Es handelt sich um eine informelle Konvention, die manche Websites veröffentlichen, damit ihre Inhalte für ein KI-System leichter zu lesen und zusammenzufassen sind. Sie ist keine Crawling-Berechtigung und kein Widerspruch gegen KI-Training.
Crawler-Name | Unternehmen, zu dem er gehört | Was das Blockieren tatsächlich betrifft |
|---|---|---|
Googlebot | Ob Seiten in den Google-Suchergebnissen erscheinen | |
Google-Extended | Ob Inhalte für KI-Training und verwandte Funktionen verwendet werden, getrennt von der Suche | |
GPTBot | OpenAI | Ob Inhalte für das KI-Training dieses Unternehmens gecrawlt werden, dokumentiert auf dessen eigener Website |
ClaudeBot | Anthropic | Ob Inhalte für das KI-Training dieses Unternehmens gecrawlt werden, dokumentiert auf dessen eigener Website |
PerplexityBot | Perplexity | Ob Inhalte für die KI-Produkte dieses Unternehmens gecrawlt werden, dokumentiert auf dessen eigener Website |
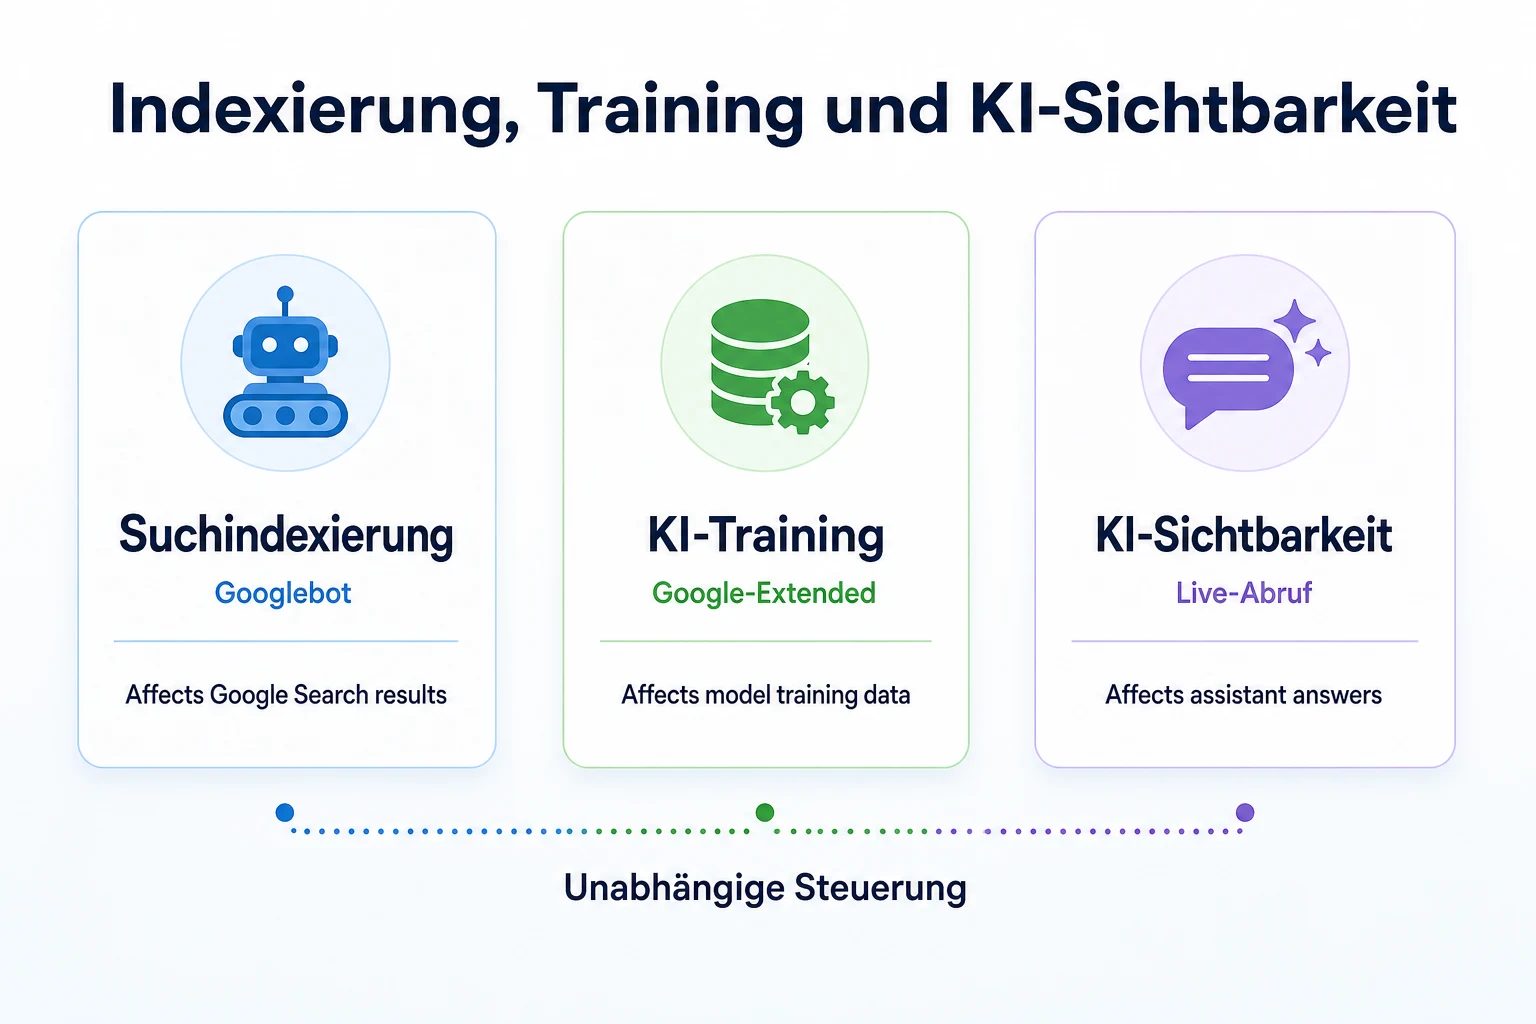
KI-Training, Suchindexierung und KI-Sichtbarkeit: drei verschiedene Dinge
Viel Verwirrung um diese Ankündigung entsteht, weil diese drei als ein einziges Thema behandelt werden. Das sind sie nicht, und sie werden getrennt gesteuert.
Suchindexierung: Googlebot
Die Suchindexierung übernimmt der Googlebot. Er entscheidet, ob eine Seite als Ergebnis in der Google-Suche erscheinen kann. Das Blockieren des Googlebots entfernt eine Website aus den Suchergebnissen. Es hat nichts mit KI-Training zu tun, denn Googlebot und Google-Extended sind getrennte Crawler mit getrennt dokumentierten Zwecken.
KI-Training: Google-Extended und ähnliche Kennungen
KI-Training ist ein separater Vorgang, gesteuert durch Kennungen wie Google-Extended und die anderen oben aufgeführten Crawler. Diese bestimmen, ob Inhalte zum Training eines Modells verwendet werden, nicht, ob diese Inhalte in den Suchergebnissen erscheinen. Eine Website kann Google-Extended blockieren und in der Google-Suche trotzdem normal ranken, weil beide unabhängige Einstellungen sind.
KI-Sichtbarkeit: was zum Zeitpunkt der Anfrage passiert
KI-Sichtbarkeit ist wieder etwas anderes. Sie betrifft, was passiert, wenn jemand einen KI-Assistenten eine Frage stellt und der Assistent Informationen abruft oder darauf verweist, um sie zu beantworten. Das geschieht oft in dem Moment, in dem die Frage gestellt wird, und nicht aus einem Modell, das Monate zuvor trainiert wurde. Das Blockieren eines Trainings-Crawlers ändert nicht unbedingt, ob eine Seite dafür weiterhin live gelesen werden kann, denn manche Assistenten rufen Informationen unabhängig davon ab, wie sie trainiert wurden. Unser Leitfaden, wie man in ChatGPT erwähnt wird, erklärt diesen Unterschied ausführlicher. Er zeigt auch, warum kein Anbieter garantiert, dass eine bestimmte Seite in einer bestimmten Antwort erscheint.
Konzept | Beteiligter Mechanismus oder Crawler | Was Blockieren oder Erlauben verändert |
|---|---|---|
Suchindexierung | Googlebot | Ob Seiten in den Google-Suchergebnissen erscheinen |
KI-Training | Google-Extended und ähnliche Crawler-Kennungen | Ob Inhalte zum Training von KI-Modellen verwendet werden |
KI-Sichtbarkeit | Live-Abruf zum Zeitpunkt, an dem eine Frage gestellt wird | Ob Inhalte weiterhin in der Antwort eines Assistenten genannt werden können, unabhängig von den Trainingseinstellungen |
Ein Beispiel: prüfen, was eine Website derzeit erlaubt
Stellen Sie sich eine kleine Steuerberatung vor, die ihre robots.txt-Datei vor zwei Jahren eingerichtet und seitdem nicht mehr angefasst hat. Dieses Beispiel dient zur Veranschaulichung.
Der Inhaber liest von Googles Ankündigung und beschließt, vor der Annahme, dass etwas geändert werden muss, zuerst zu prüfen, was die Datei tatsächlich sagt. Er öffnet die Datei direkt unter der Stammadresse der Website und liest sie Zeile für Zeile durch.
Was die Datei der Beispiel-Website tatsächlich zeigte
Die Datei blockiert Google-Extended, das irgendwann nach der Lektüre von Ratschlägen zum KI-Training hinzugefügt wurde. Zu GPTBot, ClaudeBot oder PerplexityBot sagt sie überhaupt nichts. Für keinen dieser drei existiert eine Regel. Das bedeutet, dass keiner von ihnen derzeit daran gehindert wird, die Website für den Zweck zu crawlen, für den er crawlt.
Wird dieselbe Datei durch den kostenlosen Robots.txt-Checker von RepGet geschickt, bestätigt sich dasselbe: ein eindeutiges Urteil zu Google-Extended und ein offenes Urteil zu den anderen, ohne dass für sie in die eine oder andere Richtung eine Regel geschrieben wurde. Diese Lücke war nicht beabsichtigt. Sie entstand schlicht aus dem, was der Inhaber vor zwei Jahren gelesen hatte, als Google-Extended die einzige KI-Crawler-Kennung war, die große Aufmerksamkeit bekam.
Dieses Beispiel erfordert nicht, auf Googles neuen Vorschlag zu warten. Die Lücke, die es aufdeckt, lässt sich schon heute beheben, mit Kennungen, die bereits dokumentiert sind und bereits funktionieren. Darum geht es in der Checkliste, die folgt.
Eine 20-minütige Checkliste zur Vorbereitung Ihrer Website
Dafür müssen Sie nicht warten, bis Google etwas veröffentlicht. Eine kurze Prüfung jetzt bedeutet, dass nichts mehr in letzter Minute erledigt werden muss, wenn das neue Signal tatsächlich kommt.
Schritt | Zeit | Tool oder Aktion |
|---|---|---|
Öffnen Sie Ihre aktuelle robots.txt Datei und lesen Sie jede Zeile | 5 Minuten | Rufen Sie die Datei direkt über die Stammadresse Ihrer Website auf |
Prüfen Sie, welche KI-Crawler blockiert, erlaubt oder gar nicht erwähnt sind | 5 Minuten | Der kostenlose AI Crawler Checker von RepGet |
Legen Sie eine klare Richtlinie fest: KI-Trainings-Crawler blockieren, erlauben oder die Entscheidung auf später verschieben | 5 Minuten | Eine kurze schriftliche Notiz, auch nur eine Zeile in einem gemeinsamen Dokument |
Prüfen Sie, ob eine llms.txt Datei existiert oder sich lohnt, sie hinzuzufügen | 3 Minuten | Der kostenlose llms.txt Generator von RepGet |
Setzen Sie eine Erinnerung, die robots.txt erneut zu prüfen, sobald Google die endgültige Spezifikation veröffentlicht | 2 Minuten | Eine Kalendernotiz, da noch kein Termin bestätigt ist |
Zwanzig Minuten reichen, um aus einer Annahme eine echte Entscheidung zu machen. Die meisten Websitebetreiber haben ihre robots.txt Datei seit der Einrichtung nicht mehr angesehen. Die Abweichung zwischen dem, was sie sagt, und dem, was man glaubt, dass sie sagt, ist meist klein, lohnt sich aber, bevor man etwas Neues darauf aufbaut.
Häufige Fehler, die Websitebetreiber vermeiden sollten
Bei diesem Thema tauchen einige Verwechslungen so häufig auf, dass es sich lohnt, sie gesondert von der Checkliste oben direkt anzusprechen.
Fehler | Was er bewirkt | So beheben Sie ihn |
|---|---|---|
Google-Extended mit Googlebot verwechseln | Das falsche Token wird blockiert, und die Sichtbarkeit in der Suche leidet unbeabsichtigt, oder man nimmt an, dass eine Sperre fürs Training auch die Suche abdeckt | Behandeln Sie beide als zwei getrennte Regeln mit zwei getrennten Zwecken, und prüfen Sie die Dokumentation von Google, wenn Sie unsicher sind, welches Token was bewirkt |
Annehmen, ein Widerspruch gegen KI-Training entferne eine Seite aus den Antworten von KI-Assistenten | Ein falsches Sicherheitsgefühl, dass das Blockieren des Trainings die Frage der KI-Sichtbarkeit vollständig klärt | Denken Sie daran, dass die Live-Abfrage zur Abfragezeit ein eigener Mechanismus ist, getrennt vom Training, und nicht unbedingt auf die gleiche Weise betroffen ist |
Auf den noch nicht veröffentlichten Vorschlag von Google warten, bevor man etwas unternimmt | Monatelang keine Crawler-Richtlinie überhaupt, obwohl funktionierende Steuerungen bereits existieren | Nutzen Sie die dokumentierten Tokens, die heute verfügbar sind, und prüfen Sie die Datei erneut, sobald das neue Signal veröffentlicht wird |
llms.txt mit dem vorgeschlagenen Trainingssignal gleichsetzen | Eine Datei veröffentlichen, die keine Trainingspräferenz tatsächlich ausdrückt, und erwarten, dass sie das tut | Halten Sie beides getrennt: llms.txt ist eine Konvention zur Inhaltszusammenfassung, keine Erlaubnis zum Crawling oder Training |
Dem Muster hinter den meisten dieser Fehler liegt dasselbe zugrunde, das die Verwirrung überhaupt erst verursacht hat: Ein Vorschlag, der sich noch in Entwicklung befindet, wird behandelt, als wäre er bereits eine funktionierende Funktion. Das ist er nicht, und daran ändert auch das Lesen dieses Artikels nichts.
Wo RepGet ins Bild passt
RepGet legt keine KI-Trainingsrichtlinie für eine Website fest, und es verfolgt auch nicht im Auftrag eines Unternehmens den unveröffentlichten Vorschlag von Google. Es gibt noch nichts zu konfigurieren, deshalb kann RepGet oder ein anderes Tool auch nichts vorab aktivieren.
Wobei RepGet hilft, ist herauszufinden, was die robots.txt Datei einer Website tatsächlich jetzt sagt, statt dessen, was ein Betreiber annimmt. Der kostenlose AI Crawler Checker prüft eine Website gemeinsam auf Crawler wie GPTBot, ClaudeBot und PerplexityBot, und der kostenlose Robots.txt Checker bewertet jede bereits in der Datei enthaltene Regel. Das kostenlose Website-Audit geht noch weiter: Es durchsucht die gesamte Website und vergibt einen SEO-Wert von 0 bis 100 sowie technische Probleme, die sich zu prüfen lohnen, einschließlich Crawler-Zugriffsproblemen, die gar nichts mit KI zu tun haben. Es ist kein Konto und keine Kreditkarte erforderlich.
RepGet garantiert weder ein Ranking, noch dass ein Widerspruch gegen KI-Training von einem bestimmten KI-Unternehmen respektiert wird, noch eine Erwähnung in den Antworten eines KI-Assistenten. Die kostenlosen Tools oben zeigen, was eine Website derzeit erlaubt. Die Entscheidung, was erlaubt wird, liegt weiterhin bei Ihnen als Websitebetreiber.
Das Wichtigste in Kürze
Die Ankündigung von Google vom 30. Oktober 2026 beschreibt ein gemeinsames robots.txt Signal für den Widerspruch gegen KI-Training, entwickelt zusammen mit anderen Unternehmen, die KI-Crawler betreiben. Es ist ein Vorschlag, keine ausgelieferte Funktion. Es wurde noch keine Syntax veröffentlicht, kein Starttermin ist bestätigt, und allein wegen der Ankündigung muss keine neue Zeile in einer robots.txt Datei ergänzt werden.
Unverändert gilt alles, was schon vor dem 30. Oktober funktioniert hat. Google-Extended, GPTBot, ClaudeBot und PerplexityBot sind dokumentierte Crawler mit eigenen Tokens, und Sie können heute für jeden von ihnen eine klare Richtlinie festlegen. Indexierung in der Suche, KI-Training und KI-Sichtbarkeit sind drei getrennte Dinge, die separat gesteuert werden, und keine einzelne Einstellung deckt alle drei gleichzeitig ab. Der praktische Schritt jetzt ist, die vorhandenen Steuerungen zu nutzen, zu prüfen, was die Datei einer Website tatsächlich sagt, statt es anzunehmen, und auf die weitere Dokumentation von Google zu achten, bevor Sie etwas weiter ändern.
Finden Sie zuerst heraus, was Ihre Website braucht
Führen Sie mit RepGet ein kostenloses Website-Audit durch, um zu sehen, wie die Crawler-Regeln und Inhalte Ihrer Website heute tatsächlich aussehen. Es ist kein Konto und keine Kreditkarte erforderlich.
Häufige Fragen
Ist Googles Widerspruch gegen KI-Training in robots.txt schon aktiv?
Nein. Google hat am 30. Oktober 2026 angekündigt, das Signal zusammen mit anderen KI-Unternehmen zu entwickeln. Eine Syntax, eine Spezifikation oder ein Starttermin wurde aber nicht veröffentlicht. Sie können Ihrer robots.txt-Datei deshalb noch nichts Neues hinzufügen.
Wie blockiere ich KI-Trainingscrawler heute auf meiner Website?
Fügen Sie Disallow-Regeln für die einzelnen Crawler-Kennungen hinzu, die Sie einschränken möchten, zum Beispiel Google-Extended, GPTBot, ClaudeBot oder PerplexityBot. Jede Kennung funktioniert unabhängig, und bisher deckt keine gemeinsame Regel alle ab.
Was ist der Unterschied zwischen Google-Extended und Googlebot?
Googlebot entscheidet, ob eine Seite in den Google-Suchergebnissen erscheint. Google-Extended ist ein eigener, dokumentierter Crawler für KI-Training und verwandte Funktionen. Wenn Sie einen der beiden blockieren, hat das keine Auswirkung auf den anderen.
Verschwindet meine Website aus ChatGPT- oder Gemini-Antworten, wenn ich dem KI-Training widerspreche?
Nicht unbedingt. Viele KI-Assistenten rufen Informationen live ab, sobald eine Frage gestellt wird, und das ist vom Training getrennt. Ein Widerspruch gegen das Training ändert deshalb nicht automatisch, was in einer bestimmten Antwort erscheint.
Welche KI-Unternehmen unterstützen Googles vorgeschlagenes robots.txt-Signal?
Google sagt, dass es mit anderen Unternehmen spricht, die KI-Crawler betreiben. Das bezeichnet Google jedoch als frühe Gespräche und nicht als bestätigte Vereinbarung. Prüfen Sie deshalb die Dokumentation des jeweiligen Unternehmens, um dessen tatsächliche Haltung zu erfahren.
Schadet das Blockieren von KI-Trainingscrawlern meinen Rankings in der Google-Suche?
Nein. Das Blockieren eines trainingsspezifischen Crawlers wie Google-Extended hat keinen Einfluss auf Googlebot oder die Indexierung in der Suche. Beide sind getrennte, unabhängig dokumentierte Steuerungen.
Was ist llms.txt und ist es dasselbe wie Googles neuer Vorschlag?
Nein. llms.txt ist eine informelle Konvention, mit der Inhalte einer Website für KI-Systeme zusammengefasst werden. Sie ist unter llmstxt.org beschrieben. Es handelt sich nicht um eine Crawling-Erlaubnis oder einen Widerspruch gegen das Training wie das Signal, das Google vorgeschlagen hat.
Wann wird die neue KI-Trainingssteuerung tatsächlich verfügbar sein?
Google hat kein Datum genannt. In der Ankündigung ging es um laufende Arbeiten mit anderen Unternehmen und eine Spezifikation, die noch verfeinert wird. Ein bestätigter Zeitplan, wann Websitebetreiber sie umsetzen können, existiert nicht.