

Exclusión del entrenamiento de IA de Google en robots.txt: qué significa la nueva regla
Respuesta corta
El 30 de octubre de 2026, Google anunció que está trabajando con otras empresas de IA en una señal compartida en robots.txt que permitiría a los propietarios de sitios web excluir el entrenamiento de IA desde un solo lugar, en lugar de enumerar cada rastreador de IA por separado. El control está propuesto, no activo, y no se ha confirmado ninguna fecha de lanzamiento. Las reglas actuales de robots.txt para rastreadores como Google-Extended y GPTBot seguirán funcionando igual hasta que se lance.
Un propietario de un sitio lee un titular sobre Google y la posibilidad de que los sitios web se excluyan del entrenamiento de IA a través de robots.txt.
Abre su archivo robots.txt, listo para añadir la nueva línea.
Todavía no hay ninguna que añadir.
Esa es la diferencia entre el titular y el anuncio real. Google dijo que está trabajando en una señal para excluir el entrenamiento de IA de Google en robots.txt, desarrollada junto con otras empresas de IA, pero todavía no se ha lanzado y no hay ninguna nueva directiva publicada que se pueda usar hoy.
Esto es lo que Google anunció realmente el 30 de octubre de 2026, lo que ya funciona hoy para controlar los rastreadores de IA y lo que conviene revisar en su propio sitio mientras la propuesta siga siendo una propuesta.
Lo que Google anunció el 30 de octubre de 2026
El 30 de octubre de 2026, Google dijo que está desarrollando una señal compartida que los propietarios de sitios podrían añadir a su archivo robots.txt para excluirse del uso de su contenido en el entrenamiento de modelos de IA.
El anuncio describió esto como una propuesta en desarrollo, no como una función que entró en funcionamiento ese día. Google lo presentó como un primer paso, algo en lo que trabaja con otras empresas que operan rastreadores de IA, en lugar de una especificación terminada lista para publicar.
Esa distinción importa para cualquiera que actualice un archivo robots.txt esta semana. El 30 de octubre no cambió el funcionamiento de robots.txt. No existe ningún token nuevo que añadir, y ninguna regla existente se comporta de forma distinta por el anuncio.
La idea central de la propuesta
Según se describe, la idea es una única directiva que varias empresas de IA reconocerían como significado «no uses este contenido para entrenar modelos de IA». Un propietario la añadiría una vez, en un solo archivo, en lugar de mantener una regla separada para cada rastreador de IA que pudiera leer el sitio.
Es una idea bastante distinta de bloquear un rastreador por completo. Hoy, impedir que un rastreador acceda a una página es una decisión separada de pedir a una empresa que no use para entrenar el contenido que ya obtuvo. La propuesta apunta al segundo caso: una forma compartida de expresar una preferencia de entrenamiento, no un sustituto de los permisos de rastreo existentes.
Por qué Google lo presenta como un esfuerzo colectivo y no solo de Google
El anuncio de Google presentó el esfuerzo varias veces como algo de toda la industria, y no como algo que Google definiría por su cuenta esperando que los demás lo siguieran. Una señal solo funciona si las empresas que leen los archivos robots.txt se ponen de acuerdo sobre su significado, así que Google dijo que ha hablado con otras empresas que operan rastreadores de IA sobre adoptar el mismo enfoque.
Este planteamiento también es una necesidad práctica. Robots.txt lleva décadas funcionando porque los rastreadores de toda la web acuerdan, de forma informal, leerlo y respetarlo del mismo modo. Una exclusión del entrenamiento que solo respetara una empresa diría muy poco a un propietario sobre lo que ocurre con su contenido en el resto de lugares.
Por qué una señal compartida en lugar de reglas separadas por rastreador
Hoy, un propietario que quiera expresar una preferencia a varios rastreadores de IA tiene que hacerlo un user agent cada vez.
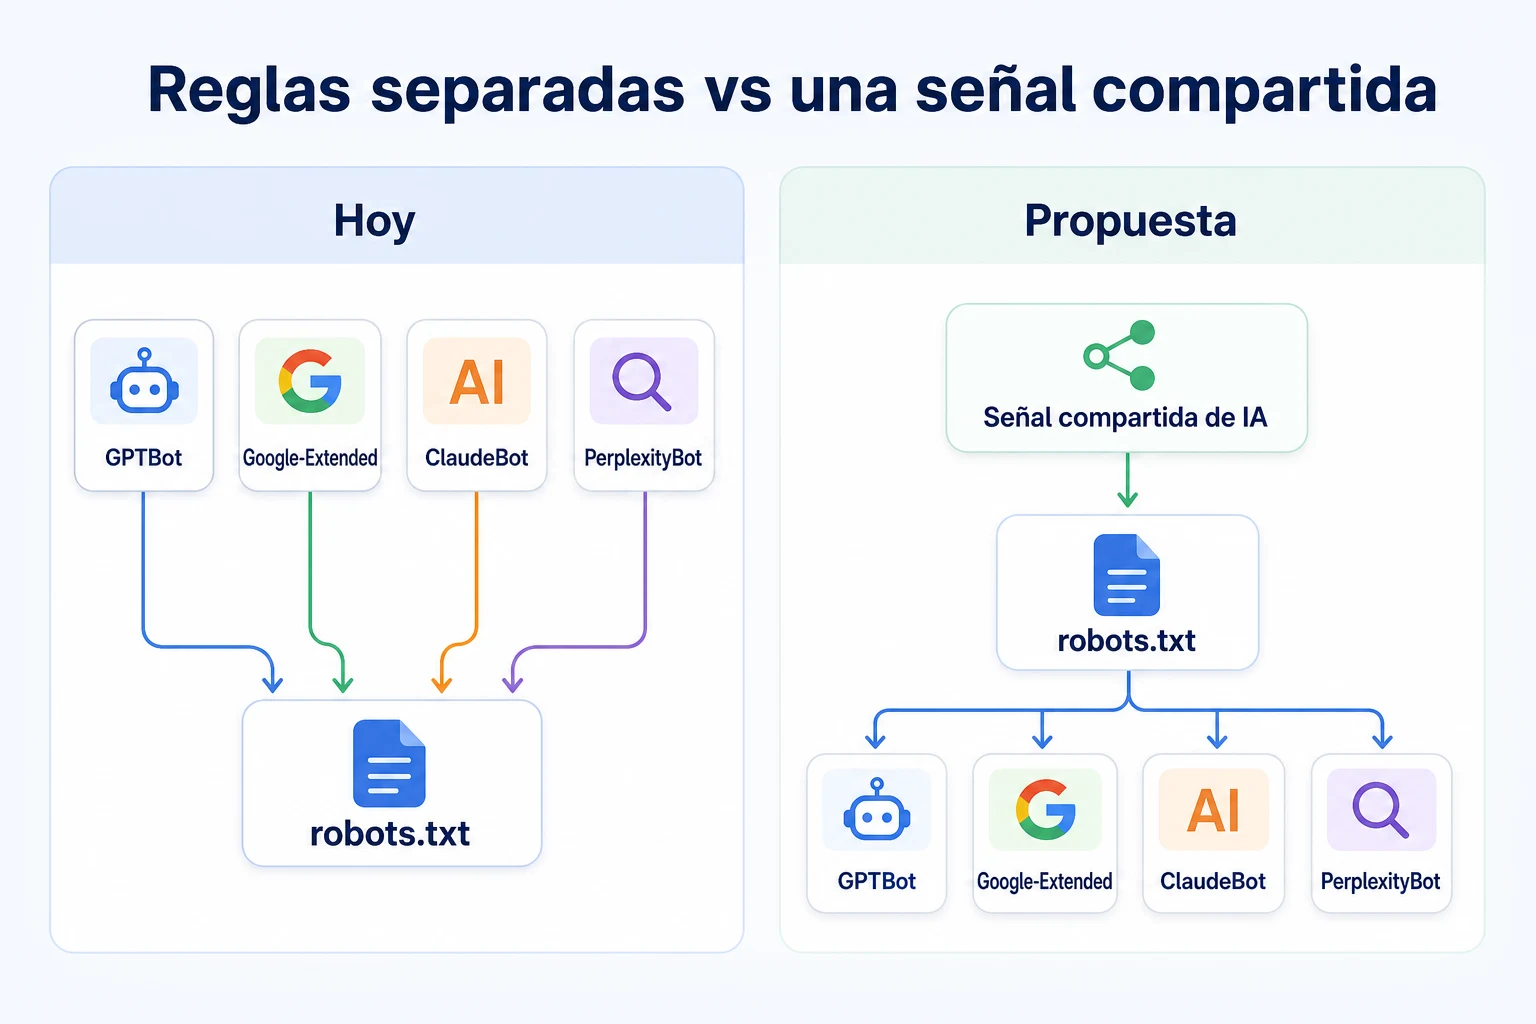
El actual mosaico de reglas por rastreador
Cada empresa de IA que rastrea la web para entrenar modelos o para recuperar contenido en vivo publica su propio rastreador, identificado por su propio token de user agent en robots.txt. Bloquear uno no bloquea otro. Una regla escrita para el token de un rastreador no tiene efecto sobre el bot de otra empresa, aunque la intención de ambas reglas sea la misma. Nuestra guía de ejemplos de user agent explica qué tokens pertenecen a cada rastreador y cómo distinguirlos en un archivo robots.txt.
Para un propietario que quiera excluirse del entrenamiento de IA de forma amplia, eso significa enumerar por nombre cada rastreador de entrenamiento de IA conocido y revisar la lista cada vez que aparezca uno nuevo. Hoy no existe una sola línea que cubra todos a la vez.
Qué cambiaría en la práctica una señal compartida
Si la propuesta se lanza tal como se describe, un propietario escribiría una única directiva destinada a señalar una preferencia de entrenamiento a cada empresa que acepte respetarla, en lugar de repetir la misma intención en una lista creciente de tokens separados.
Eso simplificaría el mantenimiento, pero no eliminaría la necesidad de entender qué se está rastreando realmente. Tal como se describe, una señal compartida de entrenamiento solo la leerían las empresas que decidan respetarla. Un rastreador que no reconozca ni respete la directiva simplemente la ignoraría, igual que cualquier rastreador puede ignorar hoy una regla de robots.txt que no reconoce.
Qué proveedores de IA han mostrado su apoyo
El anuncio de Google nombró a varias otras empresas que, según dijo, participan en las primeras conversaciones sobre la propuesta. Conviene ser precisos sobre lo que eso significa y lo que no.
Lo que se ha confirmado hasta ahora
Google describió el esfuerzo como una conversación con otras empresas de IA que operan rastreadores, y no como un acuerdo firmado ya vigente. Ser mencionado en esa conversación no es lo mismo que una empresa publique su propio compromiso de respetar una directiva concreta cuando exista.
En esta etapa, la confirmación más fiable de la postura de cualquier empresa es su propia documentación, publicada en su propio sitio. El anuncio de Google es el lugar adecuado para saber qué propone Google. No sustituye a que un proveedor de IA indique por separado, con sus propios términos, cómo planea leer o respetar la señal.
Lo que aún no está claro sobre la participación
Varias cosas no están resueltas, según lo que es público. Si todas las empresas mencionadas en las primeras conversaciones adoptarán la especificación final cuando se publique, si todas la respetarán de la misma manera, y si empresas que no se mencionan podrían adoptarla más adelante, son preguntas abiertas.
Tampoco está claro todavía si la participación sería uniforme. Una empresa podría, en principio, aceptar reconocer la señal para algunos de sus productos o rastreadores pero no para otros, igual que las empresas de IA ya trazan líneas distintas entre un rastreador usado para entrenamiento y otro usado para recuperación en vivo cuando alguien hace una pregunta. Nada de eso se ha detallado todavía.
El despliegue previsto: qué está confirmado y qué no
El anuncio de Google no incluyó una fecha de lanzamiento. Describió la propuesta como algo todavía en elaboración, con un periodo de comentarios o pruebas por delante en lugar de un lanzamiento inmediato.
Lo que Google dice que viene después
Google ha dicho que planea seguir perfeccionando la propuesta con las demás empresas implicadas antes de publicar una especificación final que los propietarios de sitios puedan implementar. Todavía no se ha publicado la sintaxis de la directiva. Eso significa que no hay un nombre confirmado para la nueva línea, ni un formato confirmado, ni una respuesta confirmada sobre cómo interactuaría con las reglas Allow y Disallow existentes en un archivo robots.txt.
Hasta que se publique esa especificación, cualquier texto sobre la redacción exacta de la nueva directiva sería una suposición, y conviene tratar cualquier suposición de ese tipo, venga de donde venga, con cautela hasta que Google la documente directamente.
Por qué todavía no hay una nueva directiva que añadir
Esta es la parte que más conviene repetir con claridad: hoy no hay nada nuevo que añadir a un archivo robots.txt por culpa de este anuncio. Las reglas existentes para Google-Extended, GPTBot, ClaudeBot y otros rastreadores de IA mencionados funcionan exactamente igual que antes del 30 de octubre de 2026. Un propietario que quiera expresar hoy una preferencia sobre el entrenamiento de IA sigue teniendo que hacerlo como siempre, rastreador por rastreador, usando los tokens que ya existen.
El resto de esta guía trata esos controles de rastreadores de IA en robots.txt, ya que son los únicos que realmente hacen algo en un sitio en funcionamiento hoy.
Cómo funcionaría el control propuesto
Google todavía no ha publicado la sintaxis exacta de la nueva directiva, así que nada de lo que sigue describe un formato confirmado. Lo que viene a continuación se basa solo en la forma en que Google describió la propuesta, y conviene leerlo como una idea general y no como una especificación que copiar.
Dónde se ubicaría dentro de robots.txt
Robots.txt ya tiene una estructura bien documentada: una línea de agente de usuario, seguida de reglas Allow y Disallow que se aplican a ese agente. La introducción de Google a robots.txt explica cómo funciona esa estructura y para qué está diseñada. Una señal compartida de entrenamiento, tal como se ha descrito, se ubicaría dentro del mismo formato de archivo en lugar de reemplazarlo. Según cómo Google planteó la idea, lo más probable es que sea un nuevo tipo de directiva reconocida en los bloques de todos los agentes de usuario, y no un archivo aparte ni un ajuste fuera de robots.txt.
Esto importa porque significa que una forma de excluir entrenamiento de IA, una vez publicada, probablemente viviría junto a las reglas Allow y Disallow que ya tenga un sitio, y no en un lugar nuevo que los propietarios tendrían que buscar.
En qué se diferencia de una regla Disallow
Una regla Disallow le indica a un rastreador que no acceda a una página. Es una instrucción de rastreo: el rastreador solicita la página o no la solicita.
Una exclusión del entrenamiento de IA, tal como la describió Google, es un tipo de instrucción distinto. Se aplicaría a contenido que un rastreador todavía podría tener permitido obtener, y diría algo sobre para qué puede usarse ese contenido después. Es una diferencia importante. Una empresa podría, en principio, seguir rastreando una página para cumplir otro propósito, como comprobar si la página existe o indexarla para un producto distinto del entrenamiento, y aun así respetar una solicitud de no usar ese contenido como datos de entrenamiento.
Hasta que la especificación final sea pública, no está confirmado si la nueva señal coexistiría con una regla Disallow, reemplazaría la necesidad de una en algunos casos o funcionaría de forma independiente de los permisos de rastreo. La documentación de Google sobre cómo funciona robots.txt es la mejor referencia actual para las reglas que existen hoy, y conviene volver a consultarla cuando Google actualice el documento con la nueva directiva.
Los controles de rastreo que ya existen hoy
La incertidumbre anterior no debería impedir que un propietario de sitio use los controles que ya están documentados y funcionan. Se aplican ahora mismo, sin importar cuándo llegue la señal compartida.
Google-Extended y el entrenamiento de IA de Google
Google ya publica un control de rastreo aparte llamado Google-Extended, destinado específicamente al entrenamiento de IA y a productos relacionados de Google, y distinto de Googlebot. La documentación de Google sobre Google-Extended explica qué afecta y qué no afecta bloquearlo. Bloquear Google-Extended en robots.txt no elimina un sitio de la Búsqueda de Google. Solo afecta a si ese contenido se usa para los productos concretos que gobierna Google-Extended.
Otros tokens de rastreadores de IA que conviene conocer
Otras empresas de IA publican sus propios tokens de rastreo de la misma manera, cada uno con su nombre y su propósito documentado. GPTBot, ClaudeBot y PerplexityBot son de los que más se ven, y cada uno funciona de forma independiente de los demás. Bloquear uno no afecta a si los otros siguen rastreando un sitio. El AI Crawler Checker gratuito de RepGet analiza un sitio frente a varios de estos a la vez, lo que es una forma más rápida de ver qué está permitido actualmente que revisar cada token a mano.
llms.txt como convención separada, no como lo mismo
Una idea relacionada pero distinta es llms.txt, una convención descrita en llmstxt.org para ofrecer a los sistemas de IA un resumen claro del contenido de un sitio en un único archivo. Conviene dejar claro que llms.txt no es el mismo mecanismo que robots.txt, y tampoco es la misma cosa que la señal de entrenamiento propuesta por Google. Es una convención informal que algunos sitios publican para que su contenido sea más fácil de leer y resumir para un sistema de IA, no un permiso de rastreo ni una exclusión del entrenamiento de IA.
Nombre del rastreador | Empresa a la que pertenece | Lo que bloquearlo afecta realmente |
|---|---|---|
Googlebot | Si las páginas aparecen en los resultados de la Búsqueda de Google | |
Google-Extended | Si el contenido se usa para el entrenamiento de IA y funciones relacionadas, separado de la Búsqueda | |
GPTBot | OpenAI | Si el contenido se rastrea para el entrenamiento de IA de esa empresa, documentado en su propio sitio |
ClaudeBot | Anthropic | Si el contenido se rastrea para el entrenamiento de IA de esa empresa, documentado en su propio sitio |
PerplexityBot | Perplexity | Si el contenido se rastrea para los productos de IA de esa empresa, documentado en su propio sitio |
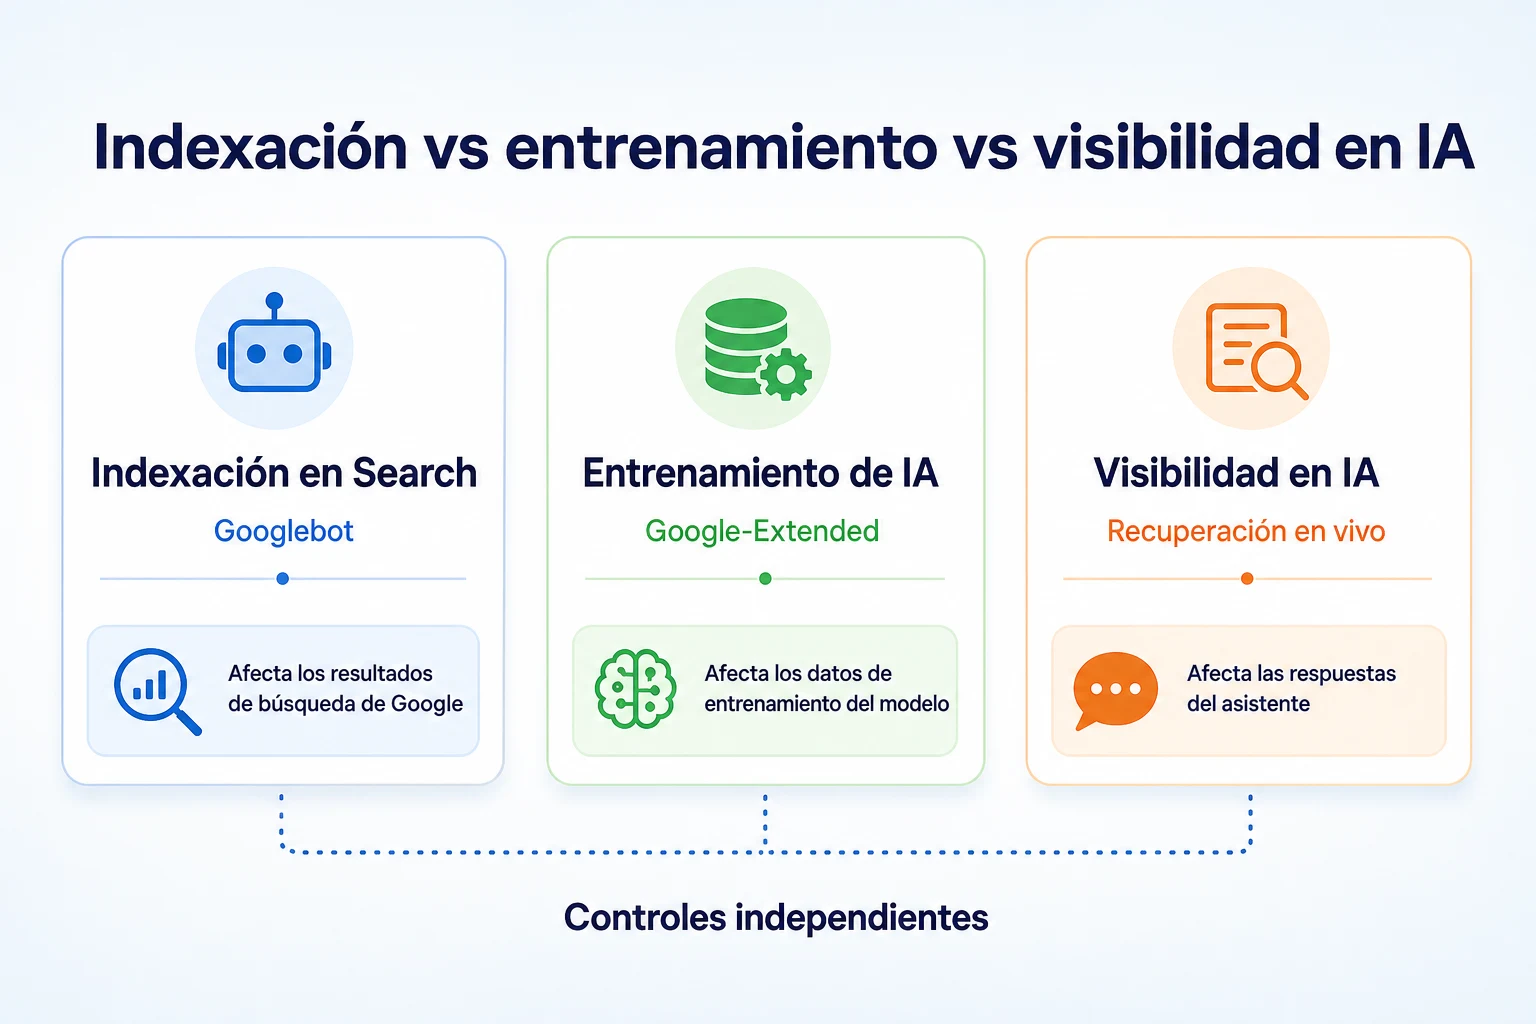
Entrenamiento de IA frente a indexación en búsqueda frente a visibilidad en IA: tres cosas distintas
Gran parte de la confusión sobre este anuncio viene de tratar estas tres cosas como una sola. No lo son, y se controlan por separado.
Indexación en búsqueda: Googlebot
La indexación en búsqueda la gestiona Googlebot. Es lo que determina si una página puede aparecer como resultado en la Búsqueda de Google. Bloquear Googlebot elimina un sitio de los resultados de búsqueda. No tiene nada que ver con el entrenamiento de IA, ya que Googlebot y Google-Extended son rastreadores separados con propósitos documentados distintos.
Entrenamiento de IA: Google-Extended y tokens similares
El entrenamiento de IA es un proceso aparte, regido por tokens como Google-Extended y los demás rastreadores mencionados arriba. Estos controlan si el contenido se usa para entrenar un modelo, no si ese contenido aparece en los resultados de búsqueda. Un sitio puede bloquear Google-Extended y seguir posicionándose con normalidad en la Búsqueda de Google, porque son dos ajustes independientes.
Visibilidad en IA: qué ocurre en el momento de la consulta
La visibilidad en IA es otra cosa. Es lo que sucede cuando alguien le hace una pregunta a un asistente de IA y este recupera o menciona información para responderla, a menudo en el momento en que se formula la pregunta y no a partir de un modelo entrenado meses antes. Bloquear un rastreador de entrenamiento no necesariamente cambia si una página puede seguir leyéndose en tiempo real para este fin, ya que algunos asistentes recuperan información por separado de cómo fueron entrenados. Nuestra guía sobre cómo conseguir que te mencionen en ChatGPT explica esta distinción con más detalle, incluido por qué ningún proveedor garantiza que una página concreta aparezca en una respuesta concreta.
Concepto | Mecanismo o rastreador implicado | Qué cambia bloquearlo o permitirlo |
|---|---|---|
Indexación en búsqueda | Googlebot | Si las páginas aparecen en los resultados de la Búsqueda de Google |
Entrenamiento de IA | Google-Extended y tokens de rastreo similares | Si el contenido se usa para entrenar modelos de IA |
Visibilidad en IA | Recuperación en tiempo real en el momento en que se formula una pregunta | Si el contenido puede seguir citándose en la respuesta de un asistente, con independencia de los ajustes de entrenamiento |
Un ejemplo práctico: comprobar qué permite hoy un sitio
Imagina un pequeño despacho de contabilidad que configuró su archivo robots.txt hace dos años y no lo ha tocado desde entonces. Este ejemplo es ilustrativo.
El propietario lee el anuncio de Google y decide revisar qué dice realmente el archivo antes de asumir que hay que cambiar algo. Abre el archivo directamente en la raíz de su sitio y lo lee línea por línea.
Lo que mostró el archivo del sitio de ejemplo
El archivo bloquea Google-Extended, añadido en algún momento después de leer consejos sobre el entrenamiento de IA. No dice nada sobre GPTBot, ClaudeBot ni PerplexityBot. No existe ninguna regla para ninguno de ellos, lo que significa que ninguno de esos tres tiene restricciones actuales para rastrear el sitio con el propósito que sea que persiguen.
Pasar el mismo archivo por el Robots.txt Checker gratuito de RepGet confirma lo mismo: un veredicto claro sobre Google-Extended y un veredicto abierto sobre los demás, sin ninguna regla escrita para ellos en ningún sentido. Esa brecha no fue intencionada. Simplemente era lo que el propietario había leído hace dos años, cuando Google-Extended era el único token de rastreador de IA que recibía mucha atención.
Nada de este ejemplo exige esperar a la nueva propuesta de Google. La brecha que revela se puede corregir hoy, usando tokens que ya están documentados y funcionan, que es el tema de la lista de verificación que sigue.
Lista de verificación de 20 minutos para preparar tu sitio
Nada de esto requiere esperar a que Google publique algo. Una revisión breve ahora significa que no quedará nada de última hora cuando la nueva señal se publique de verdad.
Paso | Tiempo | Herramienta o acción a usar |
|---|---|---|
Abre tu archivo robots.txt actual y lee cada línea | 5 minutos | Visita el archivo directamente en la dirección raíz de tu sitio |
Revisa qué rastreadores de IA están bloqueados, permitidos o no se mencionan en absoluto | 5 minutos | El Comprobador de rastreadores de IA gratuito de RepGet |
Decide una política clara: bloquear los rastreadores de entrenamiento de IA, permitirlos o dejar la decisión para más adelante | 5 minutos | Una nota escrita breve, aunque sea una línea en un documento compartido |
Revisa si existe un archivo llms.txt o si merece la pena añadirlo | 3 minutos | El Generador de llms.txt gratuito de RepGet |
Pon un recordatorio para revisar robots.txt cuando Google publique la especificación final | 2 minutos | Una nota en el calendario, ya que todavía no se ha confirmado ninguna fecha |
Veinte minutos bastan para convertir una suposición en una decisión real. La mayoría de los propietarios de sitios no han revisado su archivo robots.txt desde que lo configuraron por primera vez, y la diferencia entre lo que dice y lo que creen que dice suele ser pequeña, pero conviene corregirla antes de añadir nada nuevo encima.
Errores comunes que los propietarios de sitios deben evitar
Algunas confusiones surgen con frecuencia en este tema, así que vale la pena nombrarlas directamente, por separado de la lista de verificación anterior.
Error | Qué provoca | Cómo corregirlo |
|---|---|---|
Confundir Google-Extended con Googlebot | Bloquear el token equivocado y afectar sin querer la visibilidad en la Búsqueda, o asumir que un bloqueo del entrenamiento ya cubre la Búsqueda | Trátalos como dos reglas separadas con propósitos distintos, y consulta la documentación oficial de Google si no estás seguro de qué token hace cada cosa |
Suponer que excluirse del entrenamiento de IA elimina una página de las respuestas de los asistentes de IA | Una falsa sensación de que bloquear el entrenamiento resuelve por completo la cuestión de la visibilidad en IA | Recuerda que la recuperación en tiempo real al momento de la consulta es un mecanismo distinto del entrenamiento, y no necesariamente se ve afectada de la misma manera |
Esperar a la propuesta de Google sin publicar nada antes | Meses sin ninguna política para rastreadores, aunque ya existan controles que funcionan | Usa los tokens documentados disponibles hoy, y revisa el archivo cuando la nueva señal se publique |
Tratar llms.txt como si fuera lo mismo que la señal propuesta para el entrenamiento | Publicar un archivo que en realidad no expresa una preferencia de entrenamiento y esperar que lo haga | Mantén los dos separados: llms.txt es una convención de resumen de contenido, no un permiso de rastreo ni de entrenamiento |
El patrón que hay detrás de la mayoría de estos errores es el mismo que causó la confusión en primer lugar: tratar una propuesta todavía en desarrollo como si ya fuera una función operativa. No lo es, y leer este artículo no cambia eso.
Dónde encaja RepGet
RepGet no establece la política de entrenamiento de IA de un sitio, y tampoco hace seguimiento de la propuesta no publicada de Google en nombre de un negocio. Todavía no hay nada que configurar, así que no hay nada que RepGet ni ninguna otra herramienta pueda activar de antemano.
Lo que sí hace RepGet es mostrar lo que el archivo robots.txt de un sitio dice realmente ahora, en lugar de lo que el propietario supone que dice. Su Comprobador de rastreadores de IA gratuito prueba un sitio frente a rastreadores como GPTBot, ClaudeBot y PerplexityBot de forma conjunta, y su Comprobador de Robots.txt gratuito emite un veredicto sobre cada regla que ya está en el archivo, mostrando los permisos para rastreadores de IA que contiene. Su auditoría web gratuita va aún más lejos: rastrea todo el sitio y le asigna una puntuación SEO de 0 a 100 con los problemas técnicos que conviene revisar, incluidos los problemas de acceso de los rastreadores que no tienen nada que ver con la IA. Sin cuenta ni tarjeta de crédito.
RepGet no garantiza un posicionamiento, que una empresa de IA concreta respete una exclusión del entrenamiento, ni una mención en las respuestas de ningún asistente de IA. Las herramientas gratuitas de arriba muestran lo que un sitio permite actualmente. La decisión sobre qué permitir sigue siendo del propietario del sitio.
En resumen
El anuncio de Google del 30 de octubre de 2026 describe una señal compartida en robots.txt para excluir el entrenamiento de IA, desarrollada junto con otras empresas que operan rastreadores de IA. Es una propuesta, no una función lanzada. No se ha publicado ninguna sintaxis, no hay fecha de lanzamiento confirmada y no hay ninguna línea nueva que añadir a un archivo robots.txt por culpa del anuncio en sí.
Lo que no ha cambiado es todo lo que ya funcionaba antes del 30 de octubre. Google-Extended, GPTBot, ClaudeBot y PerplexityBot son rastreadores documentados con sus propios tokens, y el propietario de un sitio puede establecer hoy una política clara para cada uno. La indexación en la Búsqueda, el entrenamiento de IA y la visibilidad en IA siguen siendo tres cosas distintas, controladas por separado, y ningún ajuste único las cubre todas a la vez. Lo práctico ahora es usar los controles que existen, comprobar lo que dice realmente el archivo del sitio en lugar de suponerlo, y estar atento a la documentación de seguimiento de Google antes de cambiar nada más.
Descubre primero qué necesita tu sitio web
Haz una auditoría web gratuita con RepGet para ver cómo son hoy las reglas de rastreo y el contenido de tu sitio. Sin cuenta ni tarjeta de crédito.
Preguntas frecuentes
¿La exclusión del entrenamiento de IA de Google en robots.txt ya está activa?
No. Google anunció el 30 de octubre de 2026 que está desarrollando la señal con otras empresas de IA, pero no se ha publicado ninguna sintaxis, especificación ni fecha de lanzamiento, así que todavía no hay nada nuevo que añadir a un archivo robots.txt.
¿Cómo bloqueo hoy los rastreadores de entrenamiento de IA en mi sitio?
Añade reglas Disallow para los tokens de rastreador específicos que quieras restringir, como Google-Extended, GPTBot, ClaudeBot o PerplexityBot, ya que cada uno funciona por separado y todavía no hay una regla compartida que los cubra a todos.
¿Cuál es la diferencia entre Google-Extended y Googlebot?
Googlebot se encarga de que una página aparezca en los resultados de Google Search. Google-Extended es un rastreador independiente y documentado que regula el entrenamiento de IA y funciones relacionadas, y bloquear uno no afecta al otro.
¿Si excluyo el entrenamiento de IA, mi sitio desaparecerá de las respuestas de ChatGPT o Gemini?
No necesariamente. Muchos asistentes de IA recuperan información en tiempo real en el momento en que se hace una pregunta, separado del entrenamiento, así que excluir el entrenamiento no cambia automáticamente lo que aparece en una respuesta concreta.
¿Qué empresas de IA apoyan la señal propuesta por Google para robots.txt?
Google dijo que ha hablado con otras empresas que operan rastreadores de IA, pero lo describió como un debate inicial y no como un acuerdo confirmado, así que consulta la documentación de cada empresa para conocer su postura real.
¿Bloquear los rastreadores de entrenamiento de IA perjudica mi posicionamiento en Google Search?
No. Bloquear un rastreador específico de entrenamiento como Google-Extended no afecta a Googlebot ni a la indexación en Search, ya que son controles separados e independientes, documentados por separado.
¿Qué es llms.txt y es lo mismo que la nueva propuesta de Google?
No. llms.txt es una convención informal para resumir el contenido de un sitio para que los sistemas de IA lo lean, descrita en llmstxt.org. No es un permiso de rastreo ni una exclusión del entrenamiento como la señal que propuso Google.
¿Cuándo estará realmente disponible el nuevo control de entrenamiento de IA?
Google no ha dado una fecha. El anuncio describió un trabajo en curso con otras empresas y una especificación que todavía se está afinando, sin un calendario confirmado para que los propietarios de sitios puedan aplicarla.