

Opt-out Google entraînement IA robots.txt : ce que change la nouvelle règle
Réponse courte
Le 30 octobre 2026, Google a annoncé qu'il travaille avec d'autres entreprises d'IA sur un signal commun dans robots.txt. Il permettrait aux propriétaires de sites d'exclure l'entraînement de l'IA en un seul endroit, au lieu de lister chaque robot d'exploration IA séparément. Ce contrôle est proposé, pas actif, et aucune date de mise en service n'est confirmée. Les règles existantes pour des robots comme Google-Extended et GPTBot continuent de fonctionner de la même façon jusqu'à sa sortie.
Un propriétaire de site lit un titre annonçant que Google permettrait aux sites d'exclure leur contenu de l'entraînement IA via robots.txt.
Il ouvre son fichier robots.txt, prêt à ajouter la nouvelle ligne.
Il n'y en a pas encore à ajouter.
C'est l'écart entre le titre et l'annonce réelle. Google a indiqué qu'il travaille sur un signal opt-out Google entraînement IA robots.txt, élaboré avec d'autres entreprises qui exploitent des robots d'IA, mais il n'a pas encore été déployé, et aucune nouvelle directive n'est publiée à utiliser aujourd'hui.
Voici ce que Google a réellement annoncé le 30 octobre 2026, ce qui fonctionne déjà pour contrôler les robots d'exploration IA, et ce qu'il faut vérifier sur votre propre site tant que la proposition reste une proposition.
Ce que Google a annoncé le 30 octobre 2026
Le 30 octobre 2026, Google a indiqué qu'il développe un signal commun que les propriétaires de sites pourraient ajouter à leur fichier robots.txt pour exclure leur contenu de l'entraînement des modèles d'IA.
L'annonce présentait cela comme une proposition en cours de développement, et non comme une fonctionnalité mise en service ce jour-là. Google l'a décrite comme une étape précoce, sur laquelle il travaille avec d'autres entreprises qui exploitent des robots d'exploration IA, plutôt que comme une spécification finalisée prête à être publiée.
Cette distinction compte pour quiconque modifie un fichier robots.txt cette semaine. Rien n'a changé dans le fonctionnement de robots.txt le 30 octobre. Aucun nouveau jeton n'existe à ajouter, et aucune règle existante ne se comporte différemment à cause de l'annonce.
L'idée centrale de la proposition
L'idée, telle qu'elle est décrite, est une directive unique que plusieurs entreprises d'IA reconnaîtraient comme signifiant « ne pas utiliser ce contenu pour entraîner des modèles d'IA ». Un propriétaire de site l'ajouterait une seule fois, dans un seul fichier, au lieu de maintenir une règle distincte pour chaque robot d'exploration IA susceptible de lire le site.
C'est une idée sensiblement différente du blocage pur et simple d'un robot. Aujourd'hui, bloquer un robot pour qu'il ne récupère pas une page est une décision distincte du fait de demander à une entreprise de ne pas utiliser un contenu déjà récupéré pour l'entraînement. La proposition vise le second cas : une manière commune d'exprimer une préférence d'entraînement, et non un remplacement des autorisations d'exploration existantes.
Pourquoi Google présente cela comme collaboratif, et non propre à Google
L'annonce de Google a présenté à plusieurs reprises l'effort comme transversal à l'industrie, et non comme une norme que Google définirait seul et que les autres seraient invités à suivre. Un signal ne fonctionne que si les entreprises qui lisent les fichiers robots.txt s'accordent sur sa signification. Google a donc indiqué qu'il s'entretient avec d'autres entreprises exploitant des robots d'IA pour qu'elles adoptent la même approche.
Ce cadre répond aussi à une nécessité pratique. Robots.txt fonctionne depuis des décennies parce que les robots d'exploration du web acceptent, de manière informelle, de le lire et de le respecter de la même façon. Une exclusion de l'entraînement que une seule entreprise honorerait n'apprendrait pas grand-chose à un propriétaire de site sur ce qui arrive à son contenu ailleurs.
Pourquoi un signal commun plutôt que des règles séparées par robot
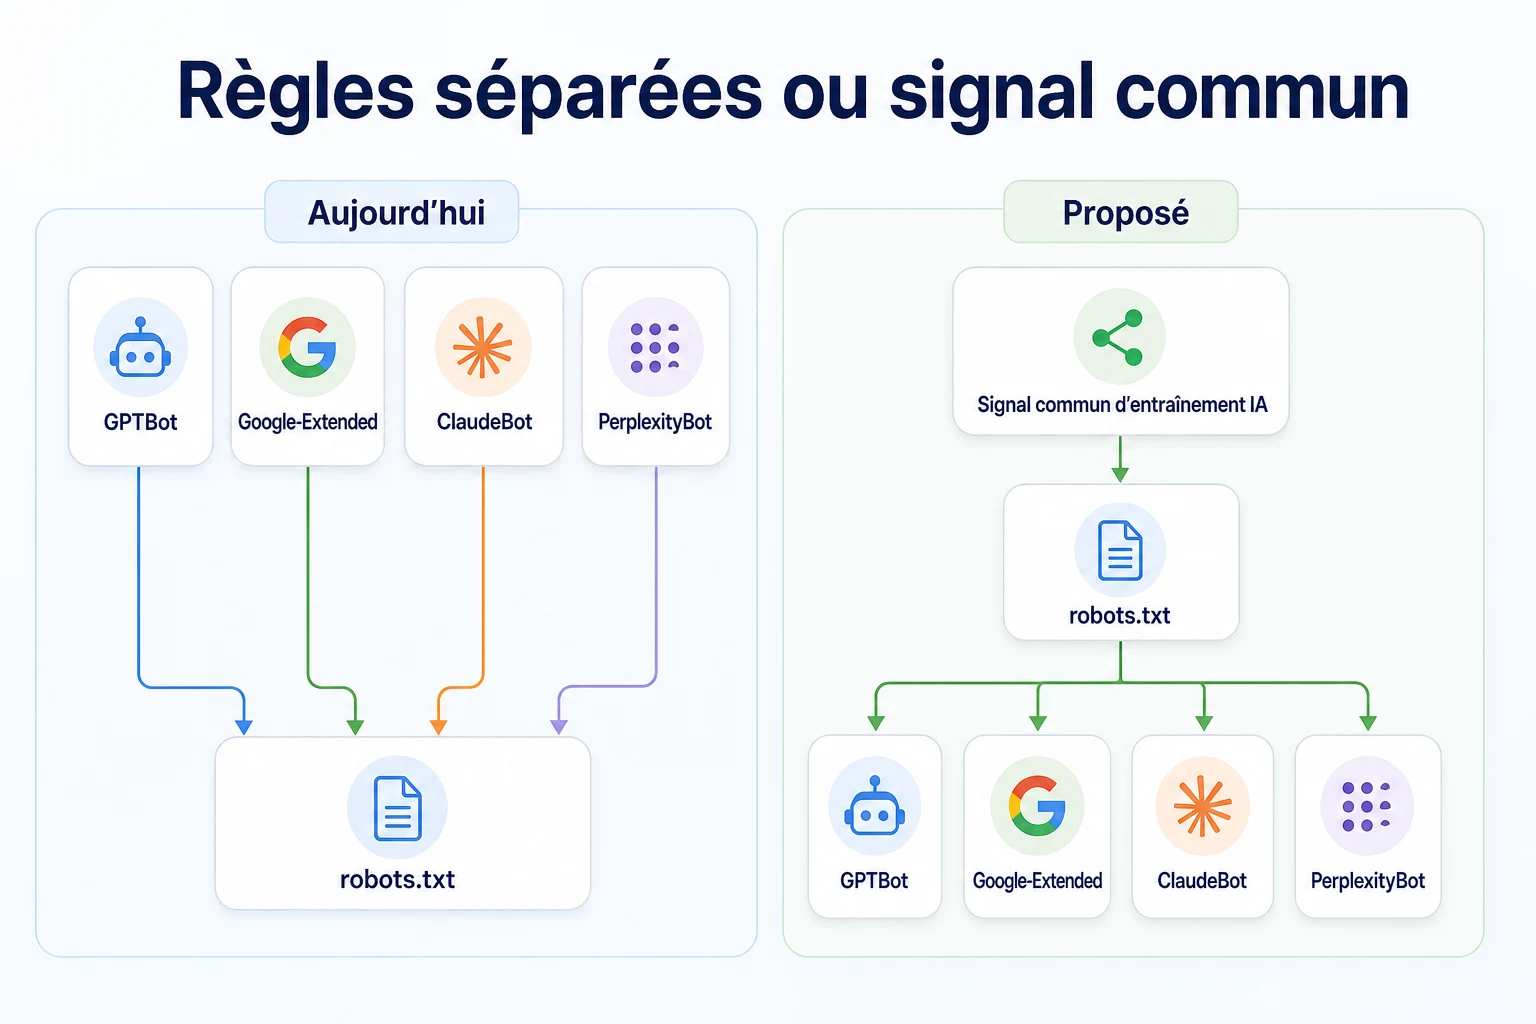
Aujourd'hui, un propriétaire de site qui veut exprimer une préférence auprès de plusieurs robots d'IA doit le faire un agent utilisateur à la fois.
Le patchwork actuel de règles par robot
Chaque entreprise d'IA qui explore le web pour l'entraînement ou pour la récupération en direct publie son propre robot, identifié par son propre jeton d'agent utilisateur dans robots.txt. Bloquer l'un ne bloque pas l'autre. Une règle écrite pour le jeton d'un robot n'a aucun effet sur le robot d'une autre entreprise, même si l'intention derrière les deux règles est la même. Notre guide sur les exemples d'agents utilisateurs explique quels jetons correspondent à quels robots d'exploration et comment les distinguer dans un fichier robots.txt.
Pour un propriétaire de site qui veut largement exclure son contenu de l'entraînement IA, cela signifie lister chaque robot d'entraînement IA connu par son nom, et revoir la liste à chaque apparition d'un nouveau. Aucune ligne unique ne couvre actuellement tous ces robots à la fois.
Ce qu'un signal commun changerait concrètement
Si la proposition est déployée comme elle est décrite, un propriétaire de site écrirait une seule directive destinée à signaler une préférence d'entraînement à chaque entreprise qui accepterait de la respecter, au lieu de répéter la même intention sur une liste croissante de jetons distincts.
Cela simplifierait la maintenance, mais n'éliminerait pas le besoin de comprendre ce qui est réellement exploré. Un signal d'entraînement commun, tel qu'il est décrit, ne serait lu que par les entreprises qui choisissent de le respecter. Un robot qui ne reconnaît pas ou ne respecte pas la directive l'ignorerait simplement, comme n'importe quel robot peut choisir d'ignorer une règle robots.txt qu'il ne reconnaît pas aujourd'hui.
Quels fournisseurs d'IA ont signalé leur soutien
L'annonce de Google a nommé quelques autres entreprises qu'il dit impliquées dans les premières discussions sur la proposition. Il est utile de préciser ce que cela signifie et ce que cela ne signifie pas.
Ce qui a été confirmé jusqu'ici
Google a décrit l'effort comme une discussion avec d'autres entreprises d'IA qui exploitent des robots d'exploration, et non comme un accord signé déjà en place. Être cité dans cette discussion n'équivaut pas à ce qu'une entreprise publie son propre engagement à respecter une directive précise, une fois celle-ci existante.
À ce stade, la confirmation la plus fiable de la position d'une entreprise est sa propre documentation, publiée sur son propre site. L'annonce de Google est le bon endroit pour savoir ce que Google propose. Elle ne remplace pas une déclaration distincte d'un fournisseur d'IA, exprimée selon ses propres termes, sur la manière dont il prévoit de lire ou de respecter le signal.
Ce qui reste flou concernant la participation
Plusieurs points ne sont pas encore tranchés, d'après ce qui est public. Il reste à savoir si chaque entreprise citée dans les premières discussions adoptera la spécification finale une fois publiée, si toutes la respecteront de la même façon, et si des entreprises non mentionnées pourraient l'adopter plus tard.
Il n'est pas non plus certain que la participation soit uniforme. Une entreprise pourrait, en principe, accepter de reconnaître le signal pour certains de ses produits ou robots et pas pour d'autres, à l'image de la façon dont les entreprises d'IA tracent déjà des lignes différentes entre un robot utilisé pour l'entraînement et un robot utilisé pour la récupération en direct, au moment où quelqu'un pose une question. Rien de cela n'a encore été détaillé.
Le déploiement prévu : ce qui est confirmé et ce qui ne l'est pas
L'annonce de Google ne comportait pas de date de lancement. Elle décrivait la proposition comme un travail encore en cours, avec une période de retours ou de tests à venir, plutôt qu'une sortie immédiate.
Ce que Google dit de la suite
Google a indiqué qu'il prévoit de continuer à affiner la proposition avec les autres entreprises concernées avant de publier une spécification finale que les propriétaires de sites pourraient réellement mettre en œuvre. La syntaxe de la directive elle-même n'a pas encore été publiée. Il n'existe donc aucun nom confirmé pour la nouvelle ligne, aucun format confirmé, et aucune réponse confirmée sur la manière exacte dont elle interagirait avec les règles Allow et Disallow existantes dans un fichier robots.txt.
Tant que cette spécification n'est pas publiée, tout ce qui est écrit sur la formulation exacte de la nouvelle directive relèverait de la supposition. Il vaut donc la peine de traiter avec prudence ce type d'estimation, quelle que soit sa source, jusqu'à ce que Google la documente directement.
Pourquoi il n'y a pas encore de nouvelle directive à ajouter
C'est le point le plus important à répéter simplement : il n'y a rien de nouveau à ajouter à un fichier robots.txt aujourd'hui en raison de cette annonce. Les règles existantes pour Google-Extended, GPTBot, ClaudeBot et les autres robots d'IA nommés fonctionnent exactement comme avant le 30 octobre 2026. Un propriétaire de site qui veut exprimer une préférence d'entraînement IA dès maintenant doit toujours procéder comme il l'a toujours fait, robot par robot, en utilisant les jetons qui existent déjà.
La suite de ce guide présente ces contrôles existants, puisqu'ils sont les seuls à produire un effet réel sur un site en ligne aujourd'hui.
Comment fonctionnerait le contrôle proposé
Google n'a pas encore publié la syntaxe exacte de la nouvelle directive, donc rien de ce qui suit ne décrit un format confirmé. Ce qui suit repose uniquement sur la manière dont Google a décrit la proposition, et il vaut mieux le lire comme une idée générale plutôt que comme une spécification à copier.
Où il s'inscrirait dans robots.txt
Le fichier robots.txt a déjà une structure bien documentée : une ligne de user agent, suivie de règles Allow et Disallow qui s'appliquent à ce user agent. L'introduction de Google à robots.txt explique comment fonctionne cette structure et ce qu'elle sert à contrôler. Un signal d'entraînement commun, tel que décrit, s'inscrirait dans ce même format de fichier plutôt que de le remplacer. La forme la plus probable, selon la manière dont Google a présenté l'idée, est une nouvelle sorte de directive reconnue à travers les blocs de user agent, plutôt qu'un fichier séparé ou un réglage placé complètement en dehors de robots.txt.
Cela compte, car une exclusion de l'entraînement IA, une fois publiée, se trouverait probablement à côté des règles Allow et Disallow qu'un site possède déjà, et non à un endroit nouveau que les propriétaires devraient chercher.
En quoi elle diffère d'une règle Disallow
Une règle Disallow indique à un robot d'exploration de ne pas récupérer une page du tout. C'est une instruction d'exploration : le robot demande la page ou il ne la demande pas.
Une exclusion de l'entraînement IA, telle que Google l'a décrite, est d'une nature différente. Elle s'appliquerait à du contenu qu'un robot d'exploration peut encore être autorisé à récupérer, et indiquerait plutôt ce à quoi ce contenu peut servir ensuite. C'est une différence importante. Une entreprise pourrait, en principe, explorer toujours une page pour un autre usage, par exemple pour vérifier qu'elle existe ou pour l'indexer dans un produit distinct de l'entraînement, tout en respectant une demande de ne pas utiliser ce contenu comme données d'entraînement.
Tant que la spécification finale n'est pas publique, on ne sait pas si le nouveau signal viendrait en complément d'une règle Disallow, remplacerait le besoin d'en avoir une dans certains cas, ou fonctionnerait indépendamment des autorisations d'exploration. La documentation de Google sur le fonctionnement de robots.txt est la meilleure référence actuelle pour les règles qui existent aujourd'hui, et il vaut la peine d'y revenir une fois que Google l'aura mise à jour avec la nouvelle directive.
Les contrôles des robots d'exploration IA robots.txt qui existent déjà aujourd'hui
Aucune des incertitudes ci-dessus ne devrait empêcher un propriétaire de site d'utiliser les contrôles déjà documentés et qui fonctionnent déjà. Ils s'appliquent dès maintenant, quelle que soit la date de sortie du signal commun.
Google-Extended et l'entraînement IA de Google
Google publie déjà un contrôle d'exploration distinct appelé Google-Extended, spécifiquement destiné à l'entraînement IA et aux produits Google associés, distinct de Googlebot lui-même. Il permet de désactiver l'entraînement de l'IA pour ces produits. La documentation de Google sur Google-Extended explique ce que son blocage affecte et ce qu'il n'affecte pas. Interdire Google-Extended dans robots.txt ne retire pas un site de la recherche Google. Cela affecte seulement l'utilisation de ce contenu pour les produits spécifiques que Google-Extended régit.
Autres jetons de robots d'exploration IA à connaître
D'autres entreprises d'IA publient leurs propres jetons de robots d'exploration de la même manière, chacun avec son nom et son usage documenté. GPTBot, ClaudeBot et PerplexityBot sont parmi les plus fréquemment rencontrés, et chacun fonctionne indépendamment des autres. Bloquer l'un n'a aucun effet sur le fait que les autres explorent encore un site. L'outil gratuit AI Crawler Checker de RepGet teste un site contre plusieurs de ces jetons à la fois, ce qui permet de voir plus vite ce qui est actuellement autorisé que de vérifier chaque jeton à la main.
llms.txt, une convention distincte et non la même chose
Une idée voisine mais différente est llms.txt, une convention décrite sur llmstxt.org pour fournir aux systèmes d'IA un résumé clair du contenu d'un site dans un seul fichier. Il faut bien préciser que llms.txt n'est pas le même mécanisme que robots.txt, et qu'il ne correspond pas non plus au futur signal d'entraînement proposé par Google. C'est une convention informelle que certains sites publient pour faciliter la lecture et la synthèse de leur contenu par un système d'IA, et non une autorisation d'exploration ni une exclusion de l'entraînement IA.
Nom du robot d'exploration | Entreprise à laquelle il appartient | Ce que son blocage affecte réellement |
|---|---|---|
Googlebot | Si les pages apparaissent dans les résultats de recherche Google | |
Google-Extended | Si le contenu sert à l'entraînement IA et aux fonctions associées, séparément de la recherche | |
GPTBot | OpenAI | Si le contenu est exploré pour l'entraînement IA de cette entreprise, documenté sur son propre site |
ClaudeBot | Anthropic | Si le contenu est exploré pour l'entraînement IA de cette entreprise, documenté sur son propre site |
PerplexityBot | Perplexity | Si le contenu est exploré pour les produits IA de cette entreprise, documenté sur son propre site |
Entraînement IA, indexation dans la recherche et visibilité IA : trois choses différentes
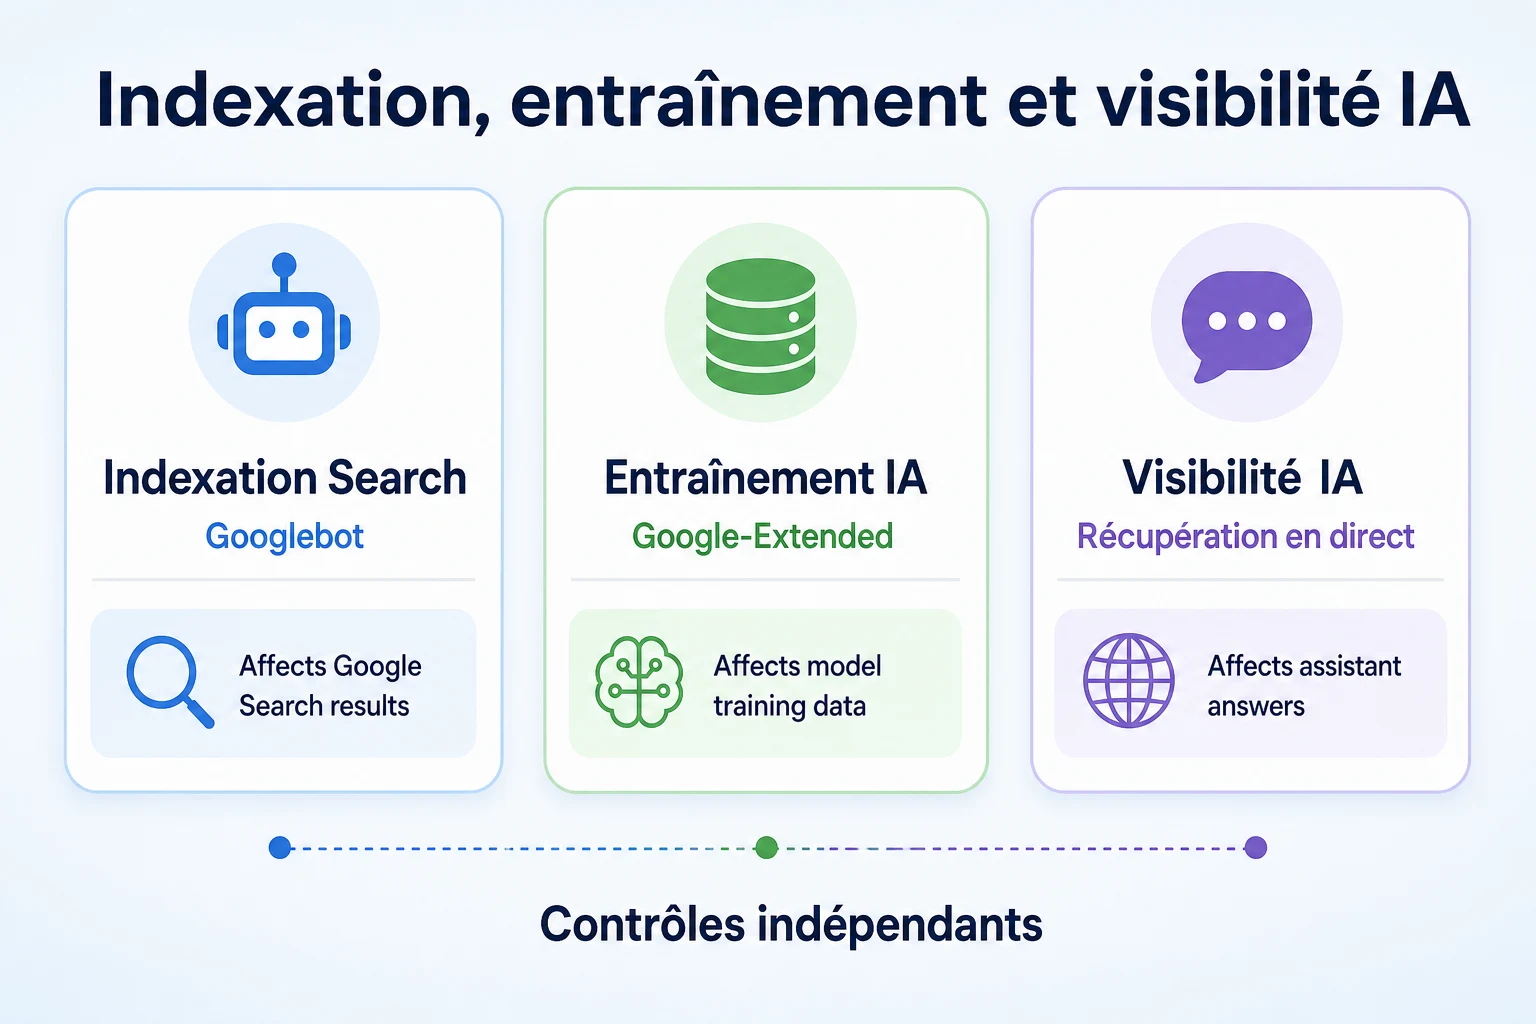
Beaucoup de confusion autour de cette annonce vient du fait de traiter ces trois éléments comme un seul. Ce n'est pas le cas, et ils se contrôlent séparément.
Indexation dans la recherche : Googlebot
L'indexation dans la recherche est gérée par Googlebot. C'est lui qui détermine si une page peut apparaître comme résultat dans la recherche Google. Bloquer Googlebot retire un site des résultats de recherche. Cela n'a rien à voir avec l'entraînement IA, puisque Googlebot et Google-Extended sont des robots d'exploration distincts, avec des usages documentés séparés.
Entraînement IA : Google-Extended et jetons similaires
L'entraînement IA est un processus distinct, régi par des jetons comme Google-Extended et les autres robots listés ci-dessus. Ils contrôlent si le contenu sert à entraîner un modèle, et non si ce contenu apparaît dans les résultats de recherche. Un site peut bloquer Google-Extended et continuer à bien se classer dans la recherche Google, car les deux sont des réglages indépendants.
Visibilité IA : ce qui se passe au moment de la requête
La visibilité IA est encore différente. C'est ce qui se passe lorsqu'une personne pose une question à un assistant IA et que celui-ci récupère ou cite des informations pour y répondre, souvent au moment où la question est posée plutôt qu'à partir d'un modèle entraîné quelques mois plus tôt. Bloquer un robot d'entraînement ne change pas forcément la possibilité qu'une page soit lue en direct à cette fin, puisque certains assistants récupèrent les informations séparément de leur entraînement. Notre guide pour être mentionné dans ChatGPT détaille cette distinction, y compris pourquoi aucun fournisseur ne garantit qu'une page précise apparaîtra dans une réponse précise.
Concept | Mécanisme ou robot d'exploration concerné | Ce que bloquer ou autoriser change |
|---|---|---|
Indexation dans la recherche | Googlebot | Si les pages apparaissent dans les résultats de recherche Google |
Entraînement IA | Google-Extended et jetons de robots similaires | Si le contenu sert à entraîner des modèles IA |
Visibilité IA | Récupération en direct au moment où une question est posée | Si le contenu peut encore être cité dans la réponse d'un assistant, indépendamment des réglages d'entraînement |
Un exemple concret : vérifier les autorisations des robots d'exploration IA
Imaginez un petit cabinet comptable qui a configuré son fichier robots.txt il y a deux ans et ne l'a plus touché depuis. Cet exemple est illustratif.
Le propriétaire lit l'annonce de Google et décide de vérifier ce que le fichier dit réellement avant de supposer qu'il faut changer quoi que ce soit. Il ouvre le fichier directement à l'adresse racine de son site et le lit ligne par ligne.
Ce que le fichier de l'exemple montrait réellement
Le fichier bloque Google-Extended, ajouté à un moment après la lecture de conseils sur l'entraînement IA. Il ne dit absolument rien sur GPTBot, ClaudeBot ou PerplexityBot. Aucune règle n'existe pour aucun d'eux, ce qui signifie qu'aucun de ces trois n'est actuellement restreint dans l'exploration du site, quel que soit l'usage pour lequel il explore.
Passer le même fichier dans le Robots.txt Checker gratuit de RepGet confirme la même chose : un verdict clair pour Google-Extended, et un verdict ouvert pour les autres, sans aucune règle écrite pour eux dans un sens ou dans l'autre. Cet écart n'était pas intentionnel. C'était simplement ce que le propriétaire avait lu il y a deux ans, à une époque où Google-Extended était le seul jeton de robot IA qui attirait vraiment l'attention.
Rien dans cet exemple n'impose d'attendre la nouvelle proposition de Google. L'écart qu'il révèle peut être corrigé dès aujourd'hui, avec des jetons déjà documentés et qui fonctionnent déjà, ce qui fait l'objet de la liste de contrôle qui suit.
Une checklist de 20 minutes pour préparer votre site
Rien de tout cela n'exige d'attendre que Google publie quoi que ce soit. Une courte vérification dès maintenant évite de devoir tout précipiter une fois que le nouveau signal sera réellement déployé.
Étape | Durée | Outil ou action à utiliser |
|---|---|---|
Ouvrez votre fichier robots.txt actuel et lisez chaque ligne | 5 minutes | Consultez directement le fichier à l'adresse racine de votre site |
Vérifiez quels robots d'exploration IA sont bloqués, autorisés ou pas mentionnés du tout | 5 minutes | Le Vérificateur de robots d'exploration IA gratuit de RepGet |
Décidez d'une politique claire : bloquer les robots d'entraînement IA, les autoriser, ou reporter la décision | 5 minutes | Une courte note écrite, même une seule ligne dans un document partagé |
Vérifiez si un fichier llms.txt existe ou mérite d'être ajouté | 3 minutes | Le Générateur llms.txt gratuit de RepGet |
Programmez un rappel pour revoir robots.txt dès que Google publiera la spécification finale | 2 minutes | Une note dans votre agenda, car aucune date n'a encore été confirmée |
Vingt minutes suffisent pour transformer une supposition en véritable décision. La plupart des propriétaires de site n'ont pas regardé leur fichier robots.txt depuis sa première configuration. L'écart entre ce qu'il dit et ce qu'ils pensent qu'il dit est généralement faible, mais il vaut la peine d'être comblé avant d'ajouter quoi que ce soit par-dessus.
Les erreurs courantes à éviter
Quelques confusions reviennent assez souvent sur ce sujet pour mériter d'être nommées directement, en dehors de la checklist ci-dessus.
Erreur | Ce que cela entraîne | Comment la corriger |
|---|---|---|
Confondre Google-Extended et Googlebot | Bloquer le mauvais jeton et affecter par accident la visibilité dans la recherche, ou supposer qu'un blocage de l'entraînement couvre déjà la recherche | Traitez-les comme deux règles distinctes ayant deux objectifs distincts, et consultez la documentation de Google si vous doutez du rôle de chaque jeton |
Supposer qu'exclure l'entraînement IA retire une page des réponses des assistants IA | Un faux sentiment que bloquer l'entraînement règle entièrement la question de la visibilité dans l'IA | Gardez à l'esprit que la récupération en temps réel au moment de la requête est un mécanisme distinct de l'entraînement, et qu'elle n'est pas forcément affectée de la même manière |
Attendre la proposition de Google non publiée avant de faire quoi que ce soit | Des mois sans aucune politique pour les robots d'exploration, alors que des contrôles efficaces existent déjà | Utilisez dès aujourd'hui les jetons documentés disponibles, et revoyez le fichier dès que le nouveau signal sera déployé |
Considérer llms.txt comme équivalent au signal d'entraînement proposé | Publier un fichier qui n'exprime pas réellement une préférence d'entraînement, et s'attendre à ce qu'il le fasse | Gardez les deux séparés : llms.txt est une convention de résumé de contenu, pas une autorisation d'exploration ou d'entraînement |
La logique qui sous-tend la plupart de ces erreurs est la même que celle qui a causé la confusion au départ : traiter une proposition encore en développement comme si elle était déjà une fonctionnalité opérationnelle. Ce n'est pas le cas, et la lecture de cet article n'y change rien.
Où se situe RepGet
RepGet ne définit pas la politique d'entraînement IA d'un site, et ne suit pas la proposition non publiée de Google pour le compte d'une entreprise. Il n'y a encore rien à configurer, donc il n'y a rien que RepGet ni aucun autre outil puisse activer à l'avance.
Ce que RepGet aide à faire, c'est voir ce que le fichier robots.txt d'un site dit réellement aujourd'hui, plutôt que ce que le propriétaire suppose qu'il dit. Son Vérificateur de robots d'exploration IA gratuit teste un site face à des robots comme GPTBot, ClaudeBot et PerplexityBot à la fois. Son Vérificateur robots.txt gratuit donne un verdict sur chaque règle déjà présente dans le fichier. Son audit de site web gratuit va encore plus loin : il explore l'ensemble du site, attribue un score SEO de 0 à 100 avec les problèmes techniques à examiner, y compris les problèmes d'accès des robots d'exploration qui n'ont rien à voir avec l'IA. Aucun compte ni carte bancaire n'est nécessaire.
RepGet ne garantit ni un classement, ni le respect d'une exclusion de l'entraînement par une entreprise d'IA en particulier, ni une mention dans les réponses d'un assistant IA. Les outils gratuits ci-dessus montrent ce qu'un site autorise actuellement. La décision sur ce qu'il faut autoriser reste celle du propriétaire du site.
L'essentiel
L'annonce de Google du 30 octobre 2026 décrit un signal robots.txt commun pour exclure l'entraînement IA, élaboré avec d'autres entreprises qui exploitent des robots d'exploration IA. Il s'agit d'une proposition, pas d'une fonctionnalité déployée. Aucune syntaxe n'a été publiée, aucune date de lancement n'est confirmée, et aucune nouvelle ligne ne doit être ajoutée à un fichier robots.txt à cause de l'annonce elle-même.
Ce qui n'a pas changé, c'est tout ce qui fonctionnait déjà avant le 30 octobre. Google-Extended, GPTBot, ClaudeBot et PerplexityBot sont tous des robots d'exploration documentés avec leurs propres jetons, et un propriétaire de site peut définir une politique claire pour chacun d'eux dès aujourd'hui. L'indexation par la recherche, l'entraînement IA et la visibilité dans l'IA restent trois choses distinctes, contrôlées séparément, et aucun réglage unique ne couvre les trois à la fois. La démarche pratique dès maintenant consiste à utiliser les contrôles des robots d'exploration IA robots.txt existants, à vérifier ce que dit réellement le fichier d'un site plutôt que de le supposer, et à surveiller la documentation de suivi de Google avant de modifier quoi que ce soit d'autre.
Découvrez d'abord ce dont votre site a besoin
Lancez un audit de site web gratuit avec RepGet pour voir à quoi ressemblent réellement aujourd'hui les règles d'exploration de votre site et son contenu. Aucun compte ni carte bancaire n'est nécessaire.
Questions fréquentes
Le opt-out Google pour l'entraînement IA dans robots.txt est-il déjà actif ?
Non. Google a annoncé le 30 octobre 2026 qu'il développe ce signal avec d'autres entreprises d'IA, mais aucune syntaxe, spécification ni date de lancement n'a été publiée. Il n'y a donc encore rien à ajouter à un fichier robots.txt.
Comment bloquer dès aujourd'hui les robots d'exploration IA d'entraînement sur mon site ?
Ajoutez des règles Disallow pour les jetons de robots spécifiques que vous voulez restreindre, comme Google-Extended, GPTBot, ClaudeBot ou PerplexityBot. Chacun fonctionne indépendamment et aucun n'est encore couvert par une règle commune.
Quelle est la différence entre Google-Extended et Googlebot ?
Googlebot gère l'apparition d'une page dans les résultats de Google Search. Google-Extended est un robot distinct et documenté qui régit l'entraînement de l'IA et les fonctionnalités associées. Bloquer l'un n'a aucun effet sur l'autre.
Exclure l'entraînement IA retire-t-il mon site des réponses de ChatGPT ou Gemini ?
Pas forcément. Beaucoup d'assistants IA récupèrent les informations en temps réel au moment où une question est posée, indépendamment de l'entraînement. Un opt-out d'entraînement ne modifie donc pas automatiquement ce qui apparaît dans une réponse précise.
Quelles entreprises d'IA soutiennent le signal robots.txt proposé par Google ?
Google indique avoir échangé avec d'autres entreprises qui exploitent des robots d'exploration IA, mais il décrit cela comme des discussions préliminaires et non comme un accord confirmé. Consultez donc la documentation de chaque entreprise pour connaître sa position réelle.
Bloquer les robots d'exploration IA d'entraînement nuit-il à mon classement Google Search ?
Non. Bloquer un robot dédié à l'entraînement, comme Google-Extended, n'affecte pas Googlebot ni l'indexation dans Search, car il s'agit de deux contrôles distincts et documentés séparément.
Qu'est-ce que llms.txt et est-ce la même chose que la nouvelle proposition de Google ?
Non. llms.txt est une convention informelle qui résume le contenu d'un site pour que les systèmes d'IA le lisent, décrite sur llmstxt.org. Ce n'est ni une autorisation d'exploration ni un opt-out d'entraînement comme le signal proposé par Google.
Quand le nouveau contrôle de l'entraînement IA sera-t-il réellement disponible ?
Google n'a pas donné de date. L'annonce décrit un travail en cours avec d'autres entreprises et une spécification encore en cours d'affinage, sans calendrier confirmé pour que les propriétaires de sites puissent le mettre en place.