

Crawler IA : comment il lit et indexe votre site web
Réponse courte
Un crawler IA est un logiciel automatisé, comme GPTBot ou ClaudeBot, qui demande vos pages, vérifie d'abord le fichier robots.txt, puis lit le HTML brut pour recueillir le texte destiné à un assistant IA. Il ne peut en général pas exécuter JavaScript comme un navigateur. Les scripts qui chargent le texte après l'ouverture de la page, les connexions obligatoires et les blocages accidentels dans robots.txt sont donc les causes les plus fréquentes d'un site que ces bots ne lisent pas.
Un propriétaire d'entreprise demande à ChatGPT de recommander une société comme la sienne.
Son entreprise n'apparaît jamais.
Le site s'affiche correctement dans un navigateur. Il est toujours bien positionné sur Google. Rien ne semble cassé.
La vraie question est donc de savoir si un crawler IA atteint réellement le site, ou si quelque chose sur celui-ci empêche discrètement ce crawler d'y accéder, sans que personne n'ait pris cette décision volontairement.
Voici comment un crawler IA lit réellement un site web, ce qui le bloque par accident, et comment vérifier que vos pages sont lisibles à la fois par les robots des moteurs de recherche et par les assistants IA.
Ce qu'est un crawler IA
Un crawler IA est un logiciel automatisé qui visite des pages web pour le compte d'une entreprise d'IA, de la même manière que le crawler d'un moteur de recherche.
Il demande une page, lit ce qui lui est renvoyé, puis passe à la suivante. Personne ne se trouve derrière un clavier à parcourir votre site. C'est un programme qui le fait, selon un calendrier, sur des millions de pages à la fois.
Ce qui change, c'est la finalité de la visite. Un crawler de moteur de recherche collecte en général des pages pour construire un index classé de résultats. Un crawler IA collecte en général des pages pour entraîner un modèle, pour ancrer les réponses d'un assistant dans des informations actuelles, ou pour permettre à cet assistant de citer une source lorsqu'il répond à une question.
Crawlers IA et crawlers de moteurs de recherche traditionnels
Googlebot et Bingbot sont des crawlers de moteurs de recherche. Leur rôle est de trouver des pages, de les comprendre suffisamment pour les classer, et d'afficher les plus pertinentes pour une recherche donnée.
GPTBot, ClaudeBot et PerplexityBot sont des crawlers IA. Ils sont exploités respectivement par OpenAI, Anthropic et Perplexity, et chacune de ces entreprises documente la finalité de son propre crawler au lieu de laisser place aux suppositions.
Le fonctionnement d'une visite isolée ressemble dans les deux cas : demander une page, lire le HTML, décider s'il faut suivre un lien. La différence tient à ce qui advient ensuite du contenu, et cela est défini par la politique propre à chaque entreprise, sans rien de visible de l'extérieur.
Pourquoi cela compte même si vous n'avez jamais entendu parler de GPTBot
Un chef d'entreprise n'a pas besoin de connaître chaque crawler par son nom pour s'en préoccuper.
L'essentiel est plus simple : si vos clients commencent à demander des recommandations à des assistants IA au lieu de taper une recherche dans Google, alors la capacité de ces crawlers à lire votre site fait partie de ce qui permet à votre entreprise d'être trouvée.
C'est une question différente de celle de savoir si votre site est bien classé dans Google. Une page peut être très bien positionnée dans les recherches et rester invisible pour un crawler IA, parce que les deux systèmes ne voient pas forcément la même chose.
Comment un crawler IA lit réellement une page
Réduit à sa mécanique, un passage de crawler suit une séquence courte et assez simple. Comprendre cette séquence permet de repérer beaucoup plus facilement où elle peut dérailler.
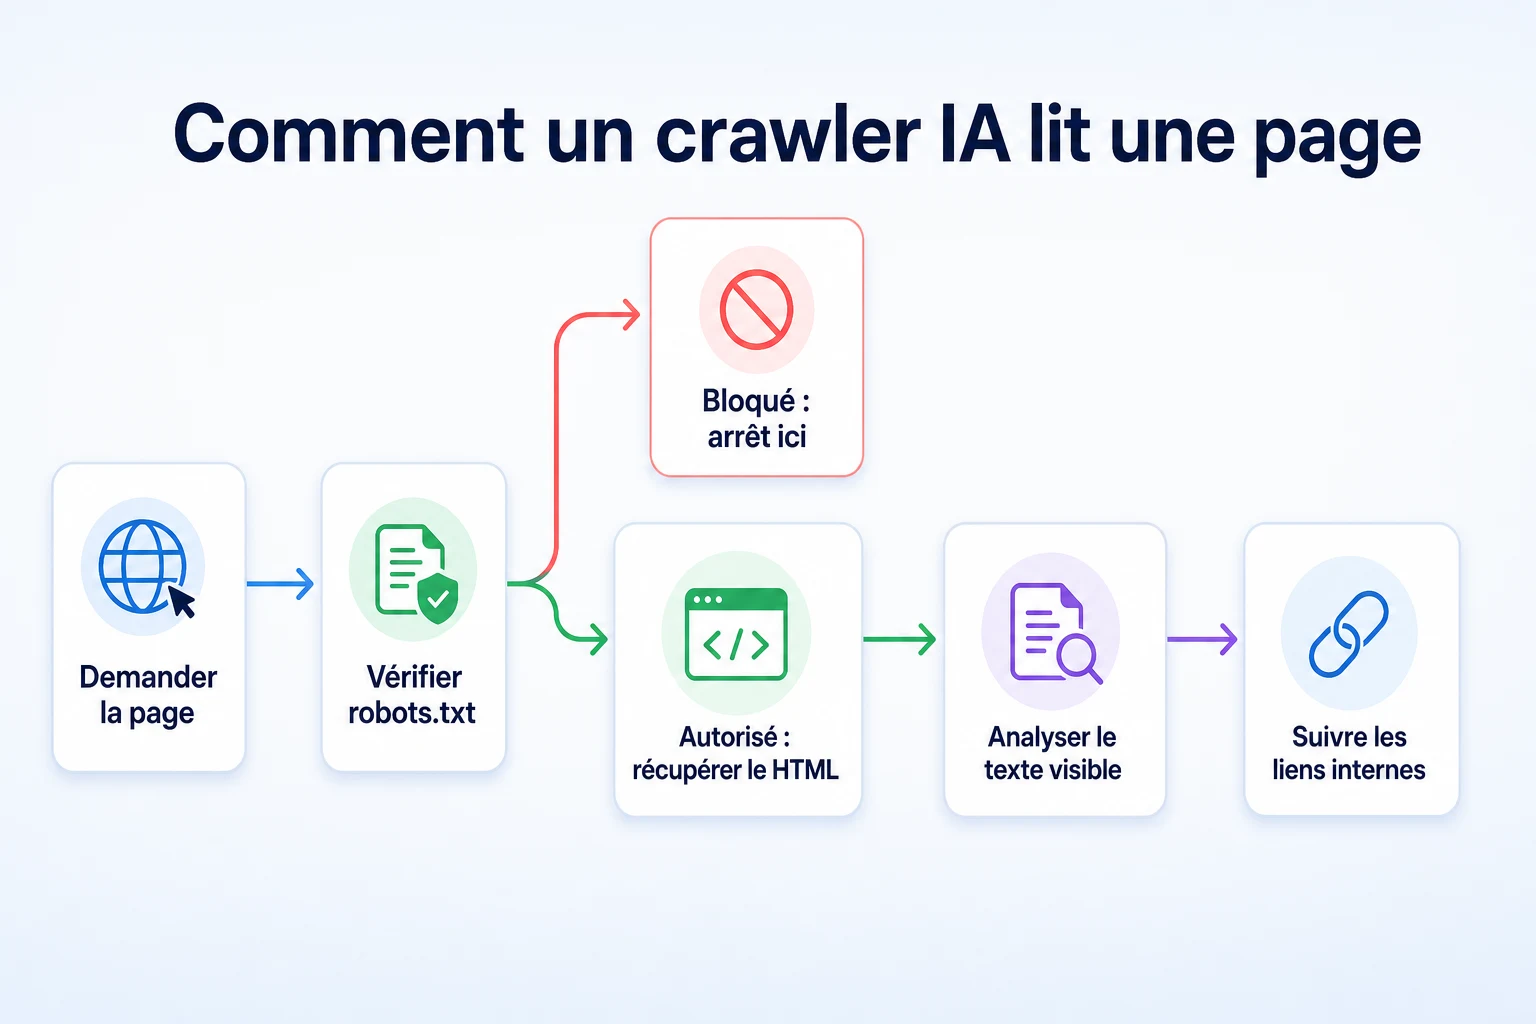
Vérifier d'abord les règles dans robots.txt
Avant de demander une page, un crawler respectueux vérifie le fichier robots.txt de votre site, à la recherche d'une règle qui le désigne nommément ou d'une règle générale qui s'applique à tous.
La documentation de Google sur le fonctionnement de robots.txt le décrit comme le moyen standard permettant aux crawlers de savoir quelles parties d'un site ils peuvent demander. Un crawler IA qui respecte ce standard ignorera tout chemin interdit pour son user-agent, et il ignorera l'ensemble du site si une règle générale interdit tout.
C'est le premier point de défaillance, et le plus courant. Si une règle destinée à un crawler s'applique par accident à tous, le crawler ne dépasse jamais cette étape.
Demander et analyser le HTML
Si robots.txt autorise la requête, le crawler récupère la page comme le ferait un navigateur, en demandant l'URL et en recevant du HTML en retour.
Il analyse ensuite ce HTML pour y chercher du texte, des titres et d'autres contenus lisibles. Beaucoup de crawlers IA font ce travail sans afficher la page comme le fait un navigateur, ce qui signifie qu'ils travaillent en général à partir de la réponse HTML brute, et non de ce qui aurait été ajouté à la page ensuite.
Cette distinction compte plus qu'il n'y paraît, et elle fait l'objet de sa propre section plus loin dans cet article.
Savoir s'il suit les liens vers l'intérieur du site
Une fois la page lue, un crawler examine en général les liens qu'elle contient et décide s'il doit suivre l'un d'eux vers d'autres pages du même site.
C'est ainsi qu'un crawler découvre des pages dont il n'a pas été informé directement, en suivant une piste de liens internes depuis les pages qu'il connaît déjà. Une page qu'aucun autre lien du site ne pointe peut être beaucoup plus difficile à trouver seule.
Les crawlers IA que vous êtes susceptible de voir
Quelques crawlers nommés représentent l'essentiel de ce qu'un petit site verra dans ses journaux serveur ou ses rapports d'accès des crawlers. Ils illustrent ce que chaque entreprise documente, et il vaut la peine de consulter directement leurs pages, car les noms et les politiques évoluent.
Nom du crawler | Exploité par | Finalité documentée |
|---|---|---|
GPTBot | OpenAI | Explore des pages pouvant servir aux finalités documentées par OpenAI, y compris l'entraînement de modèles |
ClaudeBot | Anthropic | Explore des pages pour le compte d'Anthropic, comme décrit dans ses informations publiées sur son crawler |
PerplexityBot | Perplexity | Explore des pages que les réponses de Perplexity peuvent utiliser ou citer |
Google-Extended | Contrôle si le contenu d'un site peut être utilisé pour Gemini et les fonctionnalités génératives associées, séparément de l'exploration habituelle de Google Search |
Ces descriptions résument ce que chaque entreprise déclare publiquement ; consultez leur propre documentation pour la formulation actuelle et faisant autorité.
Bloquer ou autoriser l'un de ces crawlers ne change rien au fait que Googlebot peut toujours explorer et classer votre site pour une recherche classique. Chaque crawler suit sa propre règle dans robots.txt, et ces règles sont indépendantes les unes des autres.
Avant de décider quoi que ce soit à leur sujet, il est utile de savoir ce que votre site autorise actuellement. L'AI Crawler Checker gratuit de RepGet vérifie si GPTBot, ClaudeBot et PerplexityBot peuvent actuellement accéder à un site donné.
Ce qui indique à un crawler quelles pages lire
Un crawler ne connaît pas à l'avance la structure de votre site. Il s'appuie sur un petit ensemble de signaux pour savoir ce qui est autorisé et où se trouve chaque chose.
Votre fichier robots.txt
C'est la couche des autorisations. Elle indique à un crawler les chemins qu'il peut demander et ceux qu'il doit laisser de côté, au besoin crawler par crawler.
Notre guide pour créer un fichier robots.txt sans risque pour Google et l'IA détaille davantage la syntaxe, y compris comment autoriser ou bloquer un crawler IA nommé sans toucher aux règles qui s'appliquent aux moteurs de recherche.
Votre sitemap XML
Un sitemap est une liste de vos pages, généralement à une adresse du type yoursite.com/sitemap.xml, qui donne à un crawler un index direct de ce qui existe, au lieu de compter uniquement sur les liens pour le trouver.
Il n'oblige rien à être exploré, et ce n'est pas un signal de classement. Il rend simplement la découverte plus rapide et plus complète. Le Sitemap Checker & Finder gratuit de RepGet peut confirmer qu'un sitemap existe et qu'il est valide.
Les liens internes entre vos pages
Une page sans lien interne qui pointe vers elle est plus difficile à trouver pour n'importe quel crawler, IA ou non. Si votre nouvelle page de services n'est accessible que via la barre de recherche de votre propre site, un crawler qui suit les liens n'a aucun moyen de tomber dessus.
Renvoyer vers les pages importantes depuis votre page d'accueil, votre menu de navigation ou vos articles connexes donne aux crawlers un chemin évident à suivre.
llms.txt : un signal récent et facultatif
llms.txt est un format de fichier récent, encore à l'état de proposition, documenté sur llmstxt. Il vise à donner aux systèmes d'IA un résumé court et structuré des pages les plus importantes d'un site, en langage clair.
Ce n'est pas une norme que tous les crawlers IA sont documentés pour lire, et il ne remplace ni robots.txt ni un sitemap. C'est un signal supplémentaire que certaines entreprises choisissent d'ajouter. Le llms.txt Generator gratuit de RepGet peut en créer un à partir des pages existantes d'un site, pour les entreprises qui souhaitent essayer.
Les blocages accidentels qui empêchent les crawlers IA d'accéder à votre site
La plupart des sites qui bloquent un crawler IA n'en avaient pas l'intention. La règle a été écrite pour une autre raison, ou ajoutée par défaut, et personne n'a remarqué ce qu'elle bloquait d'autre.
Une règle robots.txt oubliée ou trop large
Une règle écrite pour bloquer un crawler peut finir par en bloquer plusieurs, surtout si elle se trouve sous un bloc général User-agent: * plutôt que sous un bloc écrit pour un crawler précis, désigné par son nom.
Cela arrive aussi lorsqu'une règle globale Disallow: / d'un site de préproduction est copiée sur le domaine en ligne au moment du lancement, et que personne ne la supprime. Tous les crawlers lisent cette règle de la même façon, qu'il s'agisse de crawlers IA ou non.
La solution consiste à donner à chaque crawler que vous voulez traiter différemment son propre bloc nommé, afin qu'une règle destinée à l'un ne s'applique pas silencieusement à tous les autres. Notre guide sur la création d'un fichier robots.txt sûr explique la syntaxe pour le faire correctement.
Un pare-feu ou une extension de sécurité qui bloque par défaut
Les extensions de sécurité et les pare-feu fournis par l'hébergeur sont souvent livrés avec un réglage qui bloque automatiquement les user-agents inconnus, en partant du principe raisonnable que la plupart des bots inconnus sont des scrapers, voire pire.
Du point de vue du pare-feu, un crawler IA peut ressembler exactement à ce type de trafic. C'est un programme qui envoie des requêtes répétées depuis une adresse que le pare-feu ne reconnaît pas, précisément le schéma que beaucoup de ces outils sont conçus pour arrêter.
Le résultat est un crawler autorisé sans réserve dans robots.txt, mais qui n'arrive jamais à accéder au site, parce qu'une couche située plus bas rejette la requête avant même que robots.txt ne soit consulté. Ce type de blocage n'apparaît pas à la lecture de robots.txt, c'est pourquoi il vaut la peine de tester l'accès directement plutôt que de se contenter de lire les règles.
Du contenu derrière une connexion ou un paywall
Les pages qui exigent une connexion, un abonnement, ou même simplement une adresse e-mail avant d'afficher le contenu sont invisibles pour un crawler, de la même manière qu'elles le sont pour un visiteur qui ne s'est pas connecté.
C'est parfois voulu, et c'est un choix raisonnable pour du contenu réellement réservé. Le problème survient quand une entreprise ne réalise pas qu'une page qu'elle veut voir trouvée, comme une page de tarifs ou un guide de ressources, se trouve derrière une barrière ajoutée pour une raison sans rapport.
Erreur | Ce que cela fait à l'exploration | Comment le vérifier |
|---|---|---|
Règle robots.txt trop large | Bloque un crawler IA avec d'autres sous une règle commune | Lire le fichier robots.txt en ligne et vérifier à quels crawlers s'applique chaque bloc |
Pare-feu ou extension qui bloque les bots inconnus | Rejette la requête du crawler avant même que robots.txt soit lu | Tester l'accès réel avec un outil de vérification plutôt que de se fier uniquement aux règles |
Contenu derrière une connexion ou un paywall | Empêche tout crawler de lire la page protégée | Vérifier si les pages à faire découvrir exigent d'abord une connexion |
Limitation de débit trop agressive | Considère les requêtes répétées du crawler comme une attaque et bloque la source | Consulter les journaux du serveur ou du pare-feu pour repérer les requêtes bloquées provenant de noms de crawlers connus |
Le Robots.txt Checker et l'AI Crawler Checker gratuits de RepGet testent tous deux l'accès réel plutôt que de se contenter de lire les règles, ce qui permet de repérer les blocages au niveau du pare-feu qu'un simple fichier texte ne révèle pas.
Pourquoi les pages riches en JavaScript sont un angle mort fréquent
Une page peut sembler complète dans un navigateur et rester presque vide pour un crawler qui n'a jamais exécuté les scripts censés la remplir.
Ce que voit un crawler et ce que voit un visiteur
Beaucoup de crawlers IA lisent le code HTML brut envoyé par le serveur, sans exécuter le JavaScript qu'un navigateur lance ensuite pour construire le reste de la page.
Un visiteur ouvre une fiche produit et voit une description complète, un tableau de prix et une série d'avis. Si une partie de ce contenu n'apparaît qu'après l'exécution d'un script, qui charge des données depuis un autre endroit et les insère dans la page, un crawler qui n'exécute pas ce script peut n'en voir aucune trace. Il voit uniquement ce qui se trouvait déjà dans le HTML avant le déclenchement du script.
C'est facile à manquer, car rien ne semble anormal lorsque vous vérifiez la page vous-même. Vous utilisez un navigateur, et un navigateur exécute les scripts. Le crawler, lui, ne le fait pas, et c'est tout l'écart.
Une méthode rapide pour vérifier ce qui figure réellement dans le HTML
La vérification la plus simple consiste à afficher directement le code source HTML de la page, plutôt que ce qui est rendu à l'écran, puis à chercher le texte exact que vous vous attendez à voir lu par un crawler.
Si une description, un prix ou un fait clé n'apparaît que dans la page rendue et non dans le code source, c'est le contenu que risque de manquer totalement un crawler qui dépend du JavaScript. Le LLM HTML Visibility Checker gratuit de RepGet effectue cette vérification à votre place et indique quelle part du texte d'une page est réellement présente dans le HTML reçu par un crawler.
Rendre votre contenu lisible, pas seulement explorable
Faire franchir à un crawler la barrière de robots.txt et l'amener jusqu'à la page ne représente que la moitié du travail. Ce qui figure réellement sur la page doit aussi être quelque chose qu'il peut lire et exploiter.
Placer les informations essentielles dans du texte, pas seulement dans des images
Une photo de carte, une liste de prix scannée ou un visuel présentant les zones desservies paraît correct pour un visiteur, mais ne contient aucun texte lisible pour un crawler, qui ne peut pas lire les mots intégrés dans une image.
La solution n'est pas de retirer l'image. Il faut aussi écrire la même information en texte brut quelque part sur la page, pour que le fait existe sous une forme qu'un crawler peut réellement analyser.
Utiliser des titres clairs qui décrivent le contenu
Des titres qui indiquent précisément ce que contient une section, plutôt que quelque chose de vague ou de trop ingénieux, aident tout système qui lit la page à comprendre le sujet de chaque partie.
Un titre comme « Nos tarifs » indique clairement au crawler ce qui suit. Un titre comme « Ce que cela vous coûte » peut sembler plus agréable à un lecteur humain, mais donne moins de repères à un système d'analyse.
Éviter de cacher les informations essentielles derrière des clics
Du contenu qui n'apparaît qu'après qu'un visiteur a cliqué sur un onglet, déplié un accordéon ou parcouru un formulaire en plusieurs étapes peut rester invisible pour un crawler qui n'interagit pas avec la page comme le ferait une personne.
Si une information est assez importante pour que vous souhaitiez qu'elle soit trouvée, elle doit généralement figurer dans un texte présent sur la page dès le départ, et non derrière un clic supplémentaire. Le Meta Tag Checker gratuit de RepGet permet de vérifier ce qui figure dans le titre, la description et les autres balises d'une page, que les moteurs de recherche et les systèmes d'IA lisent en premier.
Explorer, indexer et être cité dans une réponse sont trois choses différentes
On suppose facilement qu'une fois qu'un crawler peut accéder à une page, la suite suit automatiquement. Ce n'est pas le cas. Il s'agit de trois étapes distinctes, et réussir l'une ne garantit pas la suivante.
Étape | Ce que cela signifie | Ce que cela ne garantit pas |
|---|---|---|
Page explorée | Un crawler a demandé et lu avec succès le HTML de la page | Que le contenu ait été stocké, indexé ou utilisé ensuite |
Contenu indexé ou référencé | Le système a conservé ou peut s'appuyer sur des informations de la page | Que la page sera citée ou mentionnée dans une réponse particulière |
Entreprise nommée dans une réponse | Une requête précise a produit une réponse qui nomme l'entreprise | Que la même requête, ou une requête proche, produira à nouveau le même résultat |
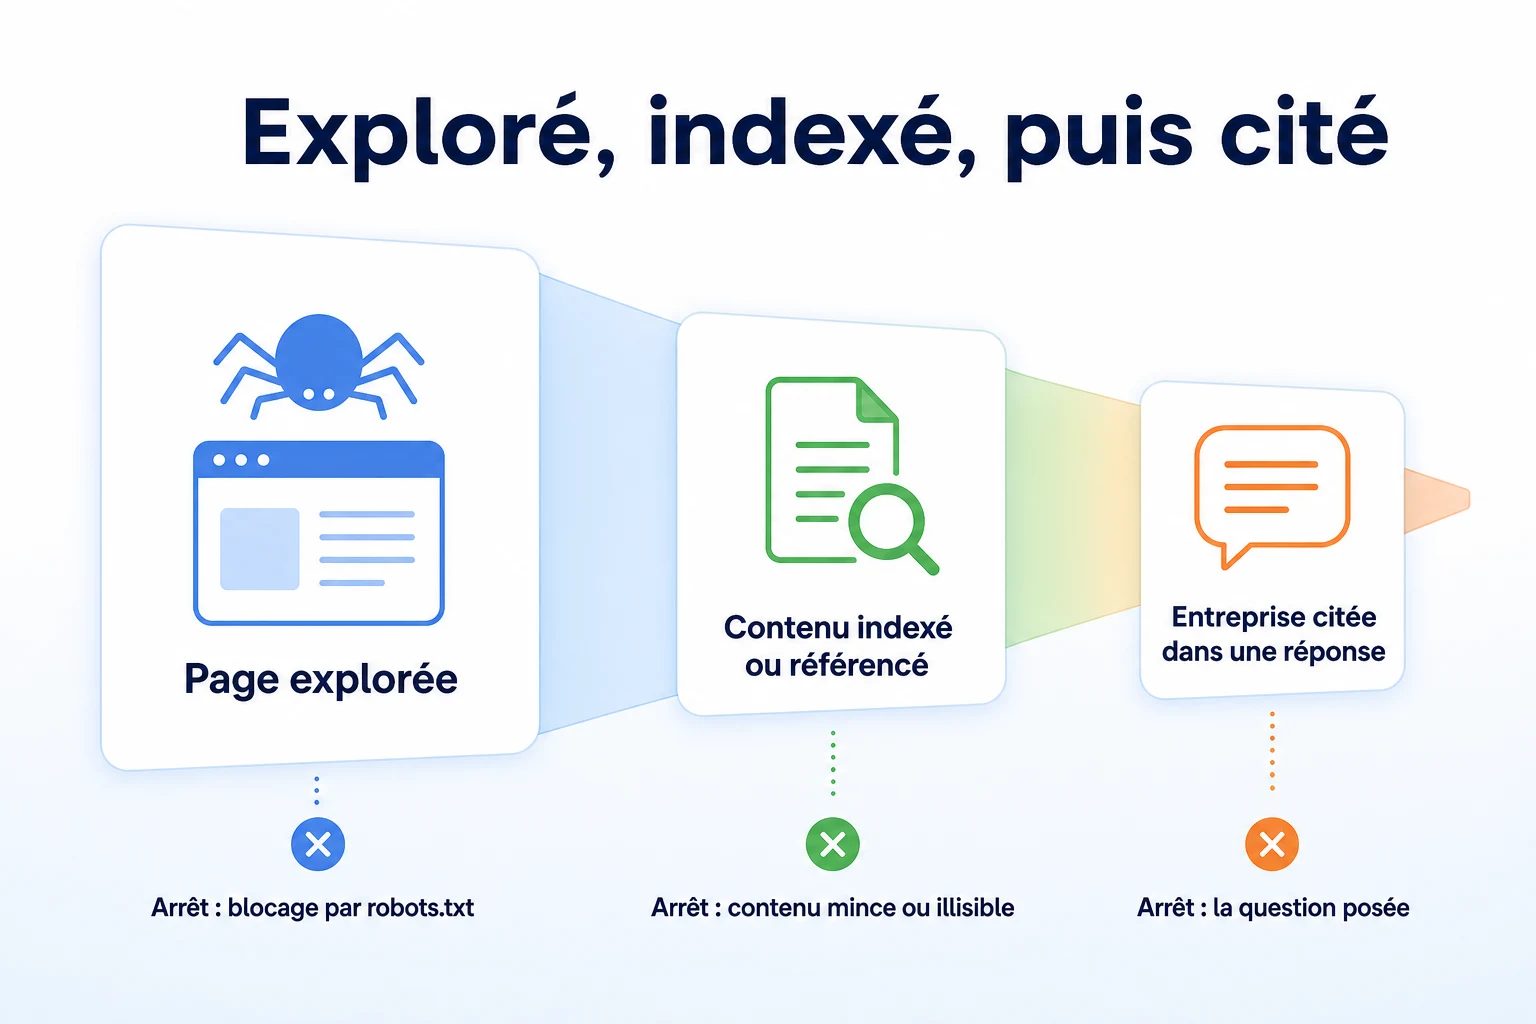
Une page peut être explorée sans jamais être référencée ensuite, de la même manière que Googlebot peut explorer une page qui ne se classe jamais pour quoi que ce soit d'utile. Le fait qu'une entreprise soit nommée dans une réponse d'IA particulière dépend fortement de la question posée, de l'assistant utilisé et d'informations sur lesquelles l'entreprise n'a aucun contrôle.
Notre guide sur la façon d'être mentionné dans ChatGPT et notre explication du fonctionnement des assistants IA pour choisir les entreprises à recommander vont plus loin sur ce qui se passe une fois qu'une page est lisible, et sur ce qui échappe au contrôle de chacun une fois qu'elle l'est.
Un exemple concret : suivre une page à travers les yeux d'un crawler IA
Imaginez une entreprise d'aménagement paysager avec une page de service d'entretien de pelouse à une adresse du type example.com/services/lawn-care. Cet exemple est illustratif.
GPTBot demande la page. Il vérifie d'abord le fichier robots.txt, ne trouve aucune règle qui le cite ou bloque ce chemin, et la requête passe.
Le crawler n'a pas trouvé cette page en suivant un lien depuis la page d'accueil. Il n'y en a pas. Il a trouvé l'URL listée dans le plan du site (sitemap), et c'est la seule raison pour laquelle il savait que la page existait.
Une fois la page chargée, le crawler lit le HTML qu'il reçoit. La description du service se trouve dans des paragraphes simples, directement dans le code source. Il en va de même pour les titres : « Services d'entretien de pelouse », « Zones d'intervention », « Ce qui est inclus ». Tout cela est lu sans aucune difficulté.
Plus bas sur la page, il y a un tableau de tarifs. Sur le site en ligne, le visiteur clique sur un onglet intitulé « Tarifs » et un script charge le contenu du tableau un instant plus tard.
Le crawler ne clique jamais sur quoi que ce soit. Il lit ce qui était déjà présent dans le HTML au premier chargement de la page, et le tableau des tarifs n'y était pas encore. Pour ce crawler, la page ne contient aucune information tarifaire, alors que chaque visiteur qui clique sur l'onglet la voit clairement.
Personne n'a conçu cet onglet pour cacher quoi que ce soit au crawler. Il a été pensé pour garder la page claire. L'effet sur un crawler IA n'a simplement jamais fait partie de la décision.
Une checklist de 20 minutes pour vérifier que votre site est explorable
À faire après chaque modification du site, qu'il s'agisse d'une nouvelle extension, d'une mise à jour du thème ou d'un changement d'hébergeur, car chacune de ces opérations peut discrètement modifier les règles dont dépend un crawler.
Étape | Ce qu'il faut vérifier | Durée |
|---|---|---|
1. Lire le fichier robots.txt en ligne | Vérifier qu'il n'y a ni blocage général ni règle qui couvre par accident plus de crawlers que prévu | 3 minutes |
2. Tester l'accès des crawlers IA nommés | Vérifier que GPTBot, ClaudeBot et PerplexityBot sont autorisés ou bloqués volontairement, et non par accident | 3 minutes |
3. Vérifier que le plan du site est valide | Contrôler qu'il liste vos pages actuelles et se charge sans erreur | 3 minutes |
4. Afficher le code source des pages clés | Vérifier que les descriptions, les prix et les autres informations essentielles apparaissent bien dans le HTML brut, et pas seulement sur la page affichée | 5 minutes |
5. Contrôler le pare-feu ou l'extension de sécurité | Vérifier que les user-agents des bots de recherche IA inconnus ne sont pas bloqués par défaut | 3 minutes |
6. Vérifier que les pages publiques ne sont pas derrière une connexion | Contrôler que les pages destinées à être trouvées se chargent sans connexion ni saisie d'adresse e-mail | 3 minutes |
Vingt minutes suffisent pour repérer la plupart des blocages accidentels abordés dans cet article. Les outils gratuits de RepGet, le AI Crawler Checker, le Robots.txt Checker, le Sitemap Checker & Finder et le LLM HTML Visibility Checker peuvent accélérer la plupart de ces étapes, au lieu de tout vérifier à la main.
Où se situe RepGet
Déterminer quel crawler peut atteindre quelle page, et quelles informations figurent réellement dans le HTML brut, est un travail détaillé et un peu technique, que l'on a tendance à repousser.
L'audit de site web gratuit de RepGet explore un site, lui attribue un score SEO de 0 à 100 et liste les problèmes techniques et de contenu à examiner, ce qui peut révéler un problème de robots.txt ou une page trop pauvre, parmi d'autres points à corriger lors de la même visite. Son AI Crawler Checker gratuit vérifie si GPTBot, ClaudeBot et PerplexityBot peuvent actuellement accéder à un site donné, et son LLM HTML Visibility Checker gratuit montre quelle part du texte d'une page est réellement présente dans le HTML reçu par un crawler. Aucun compte ni carte bancaire n'est requis pour l'un ou l'autre.
Aucun de ces outils ne peut vous dire si un assistant IA précis citera votre entreprise dans une réponse précise, et RepGet ne le garantit pas. Ce qu'ils permettent, c'est de vérifier en quelques minutes si l'accès et le contenu sont là, ce qui est la partie que l'entreprise contrôle réellement.
En résumé
Un crawler web IA n'a rien de mystérieux une fois décomposé. Il vérifie robots.txt, demande la page, lit le HTML qu'il reçoit en retour et suit parfois un lien vers la page suivante.
La plupart de ce qui empêche ces crawlers d'accéder à un site n'est pas délibéré. Une vieille règle de robots.txt, un pare-feu qui bloque par défaut les bots inconnus, un mur de connexion ajouté pour une raison sans rapport, ou une information qui n'apparaît qu'après un clic ou un script : tout cela peut discrètement empêcher un crawler de voir un contenu qu'un visiteur perçoit sans effort.
Y remédier relève de l'accès et d'un contenu simple et lisible, sans garantie au-delà. Être exploré ne garantit pas d'être indexé, et être indexé ne garantit pas d'être cité dans une réponse IA particulière. Ces dernières étapes dépendent de bien plus que ce qu'un seul site web peut contrôler.
Commencez par savoir ce dont votre site a besoin
Avant de chercher un paramètre précis pour un crawler, vérifiez ce que votre site autorise aujourd'hui et où son contenu pourrait être insuffisant. Lancez un audit gratuit de votre site avec RepGet pour contrôler la configuration technique de votre site ainsi que son contenu. Aucun compte ni carte bancaire n'est requis.
Questions fréquentes
Qu'est-ce qu'un crawler IA ?
C'est un logiciel automatisé, comme GPTBot ou ClaudeBot, qui demande des pages d'un site web pour recueillir du texte au profit d'une entreprise d'IA, dans des buts documentés, comme entraîner un modèle ou ancrer les réponses d'un assistant dans des informations actuelles.
Comment savoir si le crawler de ChatGPT a visité mon site ?
Consultez les journaux de votre serveur pour repérer les requêtes de GPTBot, ou utilisez un outil de vérification qui teste si GPTBot peut actuellement accéder à votre site. Les journaux montrent les visites réelles passées, alors qu'un outil de vérification indique si l'accès est autorisé à l'instant présent.
Puis-je bloquer les crawlers IA sans bloquer Google ?
Oui. Attribuez à chaque crawler son propre bloc
User-agentnommé dans robots.txt, afin qu'une règle écrite pour un crawler IA ne s'applique pas par accident à Googlebot ou à un autre crawler.Le JavaScript empêche-t-il les crawlers IA de lire mon site ?
De nombreux crawlers IA lisent le HTML brut envoyé par le serveur, sans exécuter le JavaScript comme le ferait un navigateur. Un contenu qui n'apparaît qu'après l'exécution d'un script peut donc leur rester invisible, alors que les visiteurs le voient sans problème.
Pourquoi mon entreprise n'apparaît-elle pas dans ChatGPT alors que Google peut explorer mon site ?
Googlebot et les crawlers IA suivent des règles distinctes, qui peuvent être autorisées ou bloquées indépendamment les unes des autres. De plus, qu'une page soit explorée ne garantit pas qu'elle soit citée ou nommée dans une réponse IA particulière.
Ai-je besoin d'un fichier llms.txt pour les crawlers IA ?
Non. C'est un fichier facultatif et récent, et tous les crawlers IA ne sont pas documentés comme le lisant. Il ne remplace ni robots.txt ni un sitemap, qui restent les principaux signaux sur lesquels les crawlers s'appuient.
À quelle fréquence les crawlers IA visitent-ils un site web ?
Cela varie selon le crawler et selon le site, et les entreprises ne publient pas de calendrier fixe. La seule façon fiable de voir à quelle fréquence un crawler donné visite réellement votre site est de consulter les journaux de votre serveur sur la durée.
GPTBot est-il le même que Googlebot ?
Non. Ils sont exploités par des entreprises différentes, dans des buts différents. GPTBot est le crawler d'OpenAI, Googlebot explore pour la recherche Google, et chacun suit ses propres règles distinctes dans robots.txt.