

Crawler AI: come legge e indicizza il tuo sito web
Risposta breve
Un crawler AI è un software automatico, come GPTBot o ClaudeBot, che richiede le tue pagine, controlla prima robots.txt, poi legge l'HTML grezzo per raccogliere testo per un assistente AI. Di solito non può eseguire JavaScript come farebbe un browser, quindi gli script che caricano il testo dopo l'apertura della pagina, i login e i blocchi accidentali in robots.txt sono i motivi più comuni per cui un sito non viene letto da questi bot.
Un titolare d'azienda chiede a ChatGPT di consigliare un'azienda come la sua.
La sua attività non compare mai.
Il sito web si carica correttamente in un browser. Continua anche a posizionarsi bene su Google. Niente sembra rotto.
Quindi la domanda vera diventa un'altra: un crawler AI arriva davvero al sito, oppure qualcosa al suo interno lo tiene fuori in silenzio, senza che nessuno l'abbia deciso di proposito?
Ecco come un crawler AI legge davvero un sito web, cosa lo blocca per errore e come verificare che le tue pagine siano leggibili sia dai bot dei motori di ricerca sia dagli assistenti AI.
Cos'è un crawler AI
Un crawler AI è un software automatico che visita pagine web per conto di un'azienda di intelligenza artificiale, proprio come fa il crawler di un motore di ricerca.
Richiede una pagina, legge ciò che riceve e passa alla successiva. Nessuno è seduto davanti a una tastiera a cliccare sul tuo sito. Lo fa un programma, in base a una pianificazione, su milioni di pagine contemporaneamente.
Cambia lo scopo della visita. Un crawler dei motori di ricerca raccoglie di solito pagine per costruire un indice di risultati ordinati. Un crawler AI raccoglie di solito pagine per addestrare un modello, per basare le risposte di un assistente su informazioni aggiornate, oppure per permettere a quell'assistente di citare una fonte quando risponde a una domanda.
Crawler AI e crawler dei motori di ricerca tradizionali
Googlebot e Bingbot sono crawler dei motori di ricerca. Il loro compito è trovare le pagine, capirle abbastanza bene da posizionarle e mostrare le più pertinenti per una determinata ricerca.
GPTBot, ClaudeBot e PerplexityBot sono crawler AI. Sono gestiti rispettivamente da OpenAI, Anthropic e Perplexity, e ciascuna azienda documenta lo scopo del proprio crawler invece di lasciarlo alle supposizioni.
La meccanica di una singola visita è simile in entrambi i casi: richiedere una pagina, leggere l'HTML, decidere se seguire un link. La differenza sta in ciò che succede dopo ai contenuti, e questo è stabilito dalla politica dichiarata da ciascuna azienda, non da qualcosa di visibile dall'esterno.
Perché conta anche se non hai mai sentito il nome GPTBot
Un'attività non ha bisogno di conoscere per nome ogni crawler per preoccuparsene.
Quello che conta è più semplice: se i tuoi clienti iniziano a chiedere consigli agli assistenti AI invece di digitare una ricerca su Google, allora la possibilità che questi crawler leggano il tuo sito diventa parte del fatto che la tua attività possa essere trovata.
È una domanda diversa dal chiederti se il tuo sito si posiziona bene in Google. Una pagina può posizionarsi benissimo nella ricerca e restare comunque invisibile a un crawler AI, perché i due sistemi non vedono necessariamente la stessa cosa.
Come un crawler AI legge davvero una pagina
Ridotta all'essenziale, una singola visita di un crawler segue una sequenza breve e piuttosto meccanica. Capire questa sequenza rende molto più facile individuare dove può andare storta.
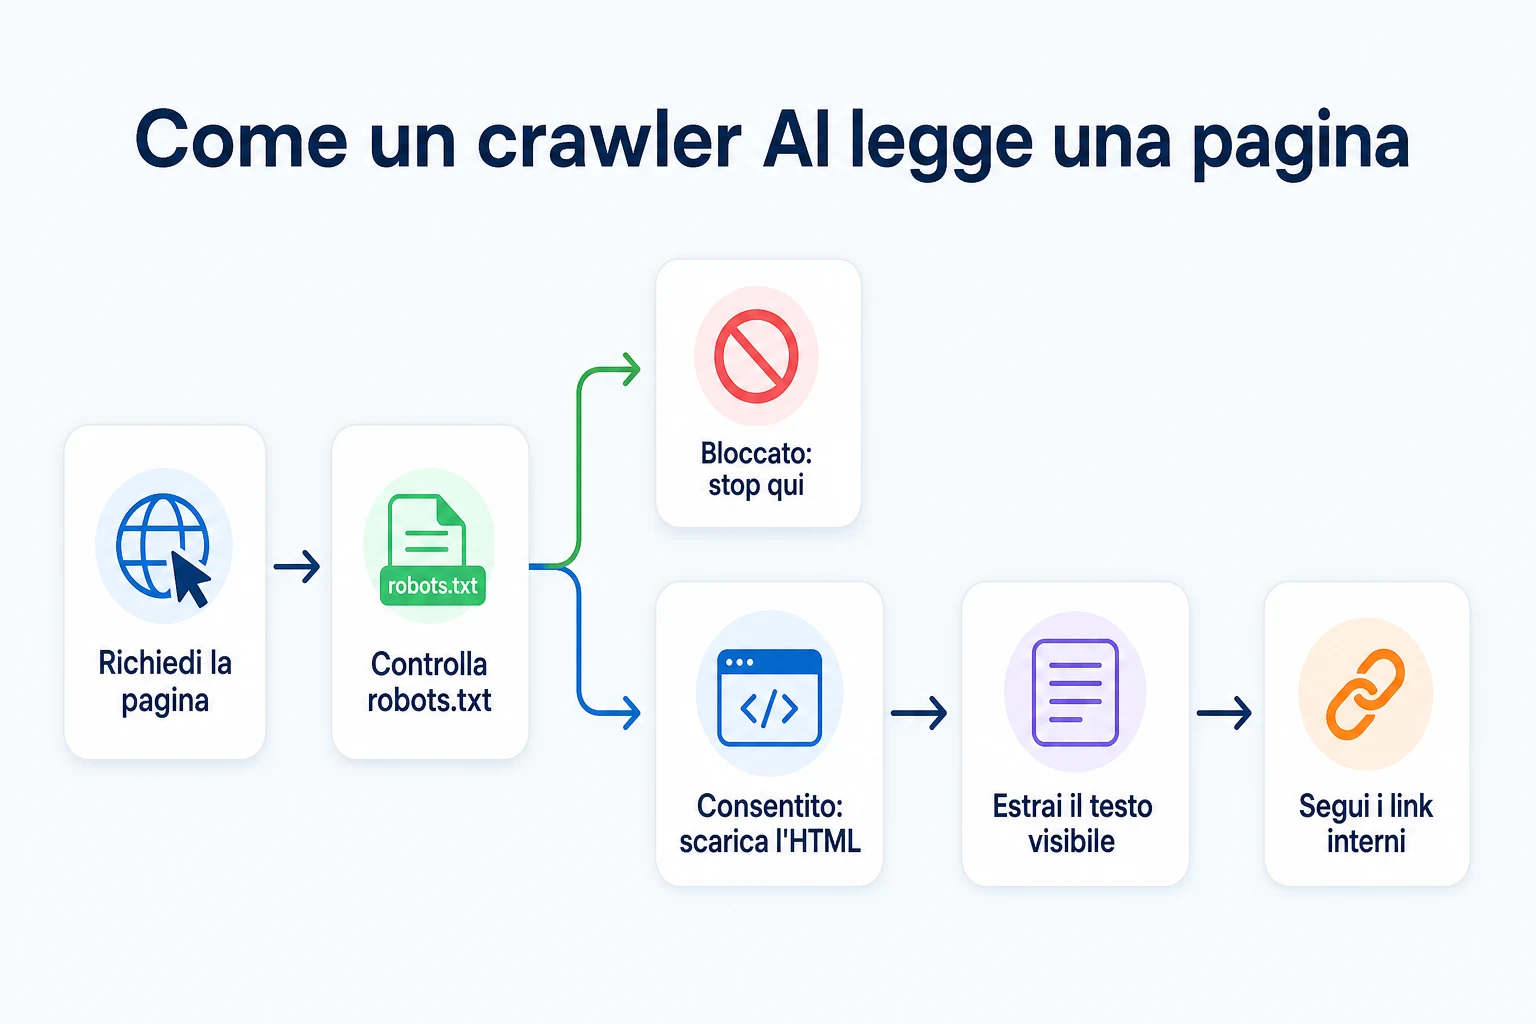
Prima controllare le regole in robots.txt
Prima di richiedere una pagina, un crawler corretto controlla il file robots.txt del sito alla ricerca di una regola che lo nomini specificamente, oppure di una regola generale che valga per tutti.
La documentazione di Google su come funziona robots.txt lo descrive come il modo standard con cui i crawler capiscono quali parti di un sito possono richiedere. Un crawler AI che rispetta lo standard salta qualsiasi percorso vietato per il proprio user-agent, e salta l'intero sito se una regola generale vieta tutto.
È il primo e più comune punto di errore. Se una regola pensata per un solo crawler si applica per sbaglio a tutti, il crawler non supera mai questo passaggio.
Richiedere e analizzare l'HTML
Se robots.txt consente la richiesta, il crawler scarica la pagina allo stesso modo di un browser, richiedendo l'URL e ricevendo in cambio l'HTML.
Da lì analizza quell'HTML cercando testo, titoli e altri contenuti leggibili. Molti crawler AI lo fanno senza eseguire il rendering della pagina come farebbe un browser, il che significa che lavorano in genere partendo dalla risposta HTML grezza, e non da quello che viene aggiunto alla pagina in un secondo momento.
Questa distinzione conta più di quanto sembri, ed è l'argomento di una sezione dedicata più avanti in questo articolo.
Se segue i link in profondità nel sito
Una volta letta una pagina, un crawler di solito esamina i link presenti e decide se seguirne qualcuno verso altre pagine dello stesso sito.
È così che un crawler scopre pagine di cui non gli è stato detto direttamente, seguendo una traccia di link interni a partire dalle pagine che già conosce. Una pagina che non riceve link da nessun'altra parte del sito può essere molto più difficile da trovare da solo per un crawler.
I crawler AI che probabilmente vedrai
Un piccolo gruppo di crawler con nome proprio rappresenta gran parte di ciò che un sito di una piccola attività vedrà nei propri log del server o nei report di accesso dei crawler. Questi esempi illustrano ciò che ogni azienda documenta, ma conviene verificare direttamente le pagine di ciascuna azienda, perché nomi e politiche cambiano.
Nome del crawler | Gestito da | Scopo documentato |
|---|---|---|
GPTBot | OpenAI | Scansiona pagine che possono essere usate per gli scopi documentati di OpenAI, incluso l'addestramento dei modelli |
ClaudeBot | Anthropic | Scansiona pagine per conto di Anthropic, come descritto nelle sue informazioni pubblicate sui crawler |
PerplexityBot | Perplexity | Scansiona pagine da cui le risposte di Perplexity possono attingere o che possono citare |
Google-Extended | Controlla se i contenuti di un sito possono essere usati per le app Gemini e le relative funzioni generative, separatamente dalla normale scansione di Google Search |
Queste descrizioni riassumono ciò che ogni azienda dichiara pubblicamente; consulta la loro documentazione per il testo attuale e ufficiale.
Bloccare o consentire uno qualsiasi di questi crawler non cambia la possibilità che Googlebot scansioni e posizioni il tuo sito per la normale ricerca. Ogni crawler segue la propria regola in robots.txt, e sono indipendenti tra loro.
Prima di decidere qualsiasi cosa su di loro, conviene sapere cosa consente il tuo sito al momento. Lo AI Crawler Checker gratuito di RepGet verifica se GPTBot, ClaudeBot e PerplexityBot possono attualmente raggiungere un sito.
Cosa indica a un crawler quali pagine leggere
Un crawler non conosce in anticipo la struttura del tuo sito. Si affida a un piccolo insieme di segnali per capire cosa è consentito e dove si trova ogni cosa.
Il tuo file robots.txt
Questo è il livello dei permessi. Indica a un crawler quali percorsi può richiedere e quali deve lasciare stare, anche separatamente per ogni crawler se necessario.
La nostra guida alla creazione di un file robots.txt sicuro per Google e per l'IA spiega la sintassi in modo più approfondito, incluso come consentire o bloccare un crawler AI specifico senza toccare le regole che valgono per i motori di ricerca.
La tua sitemap XML
Una sitemap è un elenco delle tue pagine, di solito disponibile a un indirizzo come yoursite.com/sitemap.xml, che offre a un crawler un indice diretto di ciò che esiste, invece di affidarsi soltanto al seguire i link per trovarlo.
Non obbliga nulla a essere scansionato e non è un segnale di posizionamento. Rende solo la scoperta più rapida e completa. Il Sitemap Checker & Finder gratuito di RepGet può confermare che una sitemap esiste ed è valida.
I link interni tra le tue pagine
Una pagina senza link interni che la puntano è più difficile da trovare per qualsiasi crawler, AI o di altro tipo. Se la tua nuova pagina di servizi è raggiungibile solo tramite la casella di ricerca del tuo sito, un crawler che segue i link non ha modo di imbattersi in essa.
Collegare le pagine importanti dalla homepage, dal menu di navigazione o dagli articoli correlati offre ai crawler un percorso chiaro da seguire.
llms.txt: un segnale nuovo e facoltativo
llms.txt è un formato di file nuovo e ancora in fase di proposta, documentato su llmstxt, pensato per offrire ai sistemi AI un riepilogo breve e strutturato delle pagine più importanti di un sito, in linguaggio semplice.
Non è uno standard che ogni crawler AI sia documentato per leggere, e non sostituisce robots.txt né una sitemap. È un segnale aggiuntivo che alcune attività scelgono di inserire. Il llms.txt Generator gratuito di RepGet può crearne uno a partire dalle pagine esistenti del sito, per chi vuole provarlo.
I blocchi accidentali che tengono lontani i crawler AI
La maggior parte dei siti che bloccano un crawler AI non lo ha fatto apposta. La regola è stata scritta per un altro motivo, oppure aggiunta di default, e nessuno si è accorto di cos'altro stava intercettando.
Una regola robots.txt rimasta o troppo ampia
Una regola scritta per bloccare un solo crawler può finire per bloccarne diversi, soprattutto se si trova sotto un blocco generale User-agent: * invece che in un blocco scritto per un crawler specifico, indicato per nome.
Succede anche quando la regola Disallow: / di un sito di staging, che blocca tutto, viene copiata sul dominio live durante il lancio e nessuno la rimuove. Ogni crawler legge quella regola allo stesso modo, che sia AI o no.
La soluzione è dare a ogni crawler che vuoi trattare in modo diverso un blocco separato con il suo nome, così una regola pensata per uno non si applica silenziosamente a tutti gli altri. La nostra guida su come creare un file robots.txt sicuro spiega la sintassi per farlo correttamente.
Un firewall o un plugin di sicurezza che blocca di default
I plugin di sicurezza e i firewall a livello di hosting spesso includono un'impostazione che blocca automaticamente gli user-agent sconosciuti, con la ragionevole convinzione che la maggior parte dei bot sconosciuti siano scraper o peggio.
Dal punto di vista del firewall, un crawler AI può sembrare esattamente quel tipo di traffico. È un programma che fa richieste ripetute da un indirizzo che il firewall non riconosce, ed è proprio il comportamento che molti di questi strumenti sono costruiti per fermare.
Il risultato è un crawler che è pienamente consentito nel robots.txt ma non riesce mai a passare, perché qualcosa più in basso nello stack rifiuta la richiesta prima ancora che il robots.txt venga consultato. Questo tipo di blocco non compare leggendo il robots.txt, ed è il motivo per cui conviene testare l'accesso direttamente invece di limitarsi a leggere le regole.
Contenuti dietro un login o un paywall
Le pagine che richiedono un accesso, un'iscrizione o anche solo un indirizzo email prima di caricare il contenuto sono invisibili a un crawler, così come lo sono per un visitatore che non ha effettuato l'accesso.
A volte è una scelta intenzionale, e per contenuti davvero riservati è una decisione ragionevole. Diventa un problema quando un'azienda non si rende conto che una pagina che vorrebbe far trovare, come una pagina dei prezzi o una guida di risorse, si trova dietro un muro aggiunto per un motivo non correlato.
Errore | Cosa fa alla scansione | Come verificarlo |
|---|---|---|
Regola robots.txt troppo ampia | Blocca un crawler AI insieme ad altri sotto una regola comune | Leggi il file robots.txt attivo e verifica a quali crawler si applica ogni blocco |
Firewall o plugin che blocca bot sconosciuti | Rifiuta la richiesta del crawler prima che venga letto il robots.txt | Testa l'accesso reale con un controllore invece di leggere solo le regole |
Contenuti dietro login o paywall | Impedisce a qualsiasi crawler di leggere la pagina protetta | Verifica se le pagine che vuoi far trovare richiedono davvero un login |
Limitazione aggressiva delle richieste (rate limiting) | Considera le richieste ripetute dei crawler come un attacco e blocca la fonte | Controlla i log del server o del firewall per richieste bloccate provenienti da nomi di crawler noti |
Il Robots.txt Checker e l'AI Crawler Checker gratuiti di RepGet testano entrambi l'accesso reale invece di limitarsi a leggere le regole, e così individuano i blocchi a livello di firewall che un semplice file di testo non rivela.
Perché le pagine ricche di JavaScript sono un punto cieco comune
Una pagina può sembrare completa in un browser e restare quasi vuota per un crawler che non ha eseguito gli script che la riempiono.
Cosa vede un crawler e cosa vede un visitatore
Molti crawler AI leggono l'HTML grezzo che il server restituisce, senza eseguire il JavaScript che il browser esegue dopo per costruire il resto della pagina.
Un visitatore apre una pagina prodotto e vede una descrizione completa, una tabella dei prezzi e una serie di recensioni. Se parte di quel contenuto appare solo dopo che uno script è stato eseguito, caricando dati da un'altra fonte e inserendoli nella pagina, un crawler che non esegue quello script potrebbe non vederne nulla. Vede solo ciò che era già nell'HTML prima che lo script partisse.
È facile non accorgersene perché controllando la pagina di persona nulla sembra sbagliato. Usi un browser, e un browser esegue gli script. Il crawler no, ed è proprio questo il divario.
Un modo rapido per verificare cosa c'è davvero nell'HTML
Il controllo più semplice è visualizzare direttamente il codice sorgente HTML della pagina, invece di ciò che viene mostrato a schermo, e cercare il testo effettivo che ti aspetti che un crawler legga.
Se una descrizione, un prezzo o un dato chiave compare solo nella pagina visualizzata e non nel sorgente grezzo, è il contenuto che un crawler dipendente dal JavaScript probabilmente non vedrà affatto. Il LLM HTML Visibility Checker gratuito di RepGet fa questo controllo al posto tuo, mostrando quanto del testo di una pagina è effettivamente presente nell'HTML che riceve un crawler.
Rendere il contenuto leggibile, non solo scansionabile
Far superare al crawler il robots.txt e arrivare alla pagina è solo metà del lavoro. Quello che c'è davvero nella pagina deve comunque essere qualcosa che il crawler possa leggere e usare.
Metti le informazioni chiave nel testo, non solo nelle immagini
Una foto di un menu, un listino prezzi scansionato o una grafica con le aree di servizio appaiono bene a un visitatore ma non contengono testo leggibile per un crawler, che non può leggere le parole incorporate in un'immagine.
La soluzione non è eliminare l'immagine. Bisogna anche scrivere le stesse informazioni come testo semplice da qualche parte nella pagina, così il dato esiste in una forma che il crawler può effettivamente interpretare.
Usa titoli chiari che descrivano il contenuto
I titoli che dicono cosa contiene davvero una sezione, invece di essere vaghi o ricercati, aiutano qualsiasi sistema che legge la pagina a capire di cosa parla ciascuna parte.
Un titolo come «I nostri prezzi» dice al crawler esattamente cosa segue. Un titolo come «Quanto ti costa davvero» può suonare meglio a una persona, ma dà a un sistema di analisi meno elementi con cui lavorare.
Evita di nascondere le informazioni essenziali dietro i clic
I contenuti che compaiono solo dopo che un visitatore clicca su una scheda, espande una fisarmonica o compila un modulo in più passaggi possono essere invisibili a un crawler che non interagisce con la pagina come farebbe una persona.
Se un dato è abbastanza importante da volerlo far trovare, di solito deve trovarsi in un testo presente nella pagina fin dall'inizio, non dietro un clic in più. Il Meta Tag Checker gratuito di RepGet può verificare cosa c'è nel titolo, nella descrizione e negli altri tag della pagina che sia i motori di ricerca sia i sistemi AI leggono di solito per primi.
Scansione, indicizzazione e comparsa in una risposta sono tre cose diverse
È facile dare per scontato che, una volta che un crawler può raggiungere una pagina, il resto segua automaticamente. Non è così. Sono tre passaggi separati, e superarne uno non garantisce il successivo.
Fase | Cosa significa | Cosa non garantisce |
|---|---|---|
La pagina viene scansionata | Un crawler ha richiesto con successo e letto l'HTML della pagina | Che il contenuto sia stato memorizzato, indicizzato o utilizzato in seguito |
Il contenuto viene indicizzato o referenziato | Il sistema ha conservato o può attingere alle informazioni della pagina | Che la pagina venga citata o menzionata in una specifica risposta |
L'azienda viene nominata in una risposta | Un prompt specifico ha prodotto una risposta che nomina l'azienda | Che lo stesso prompt o uno simile produca di nuovo lo stesso risultato |
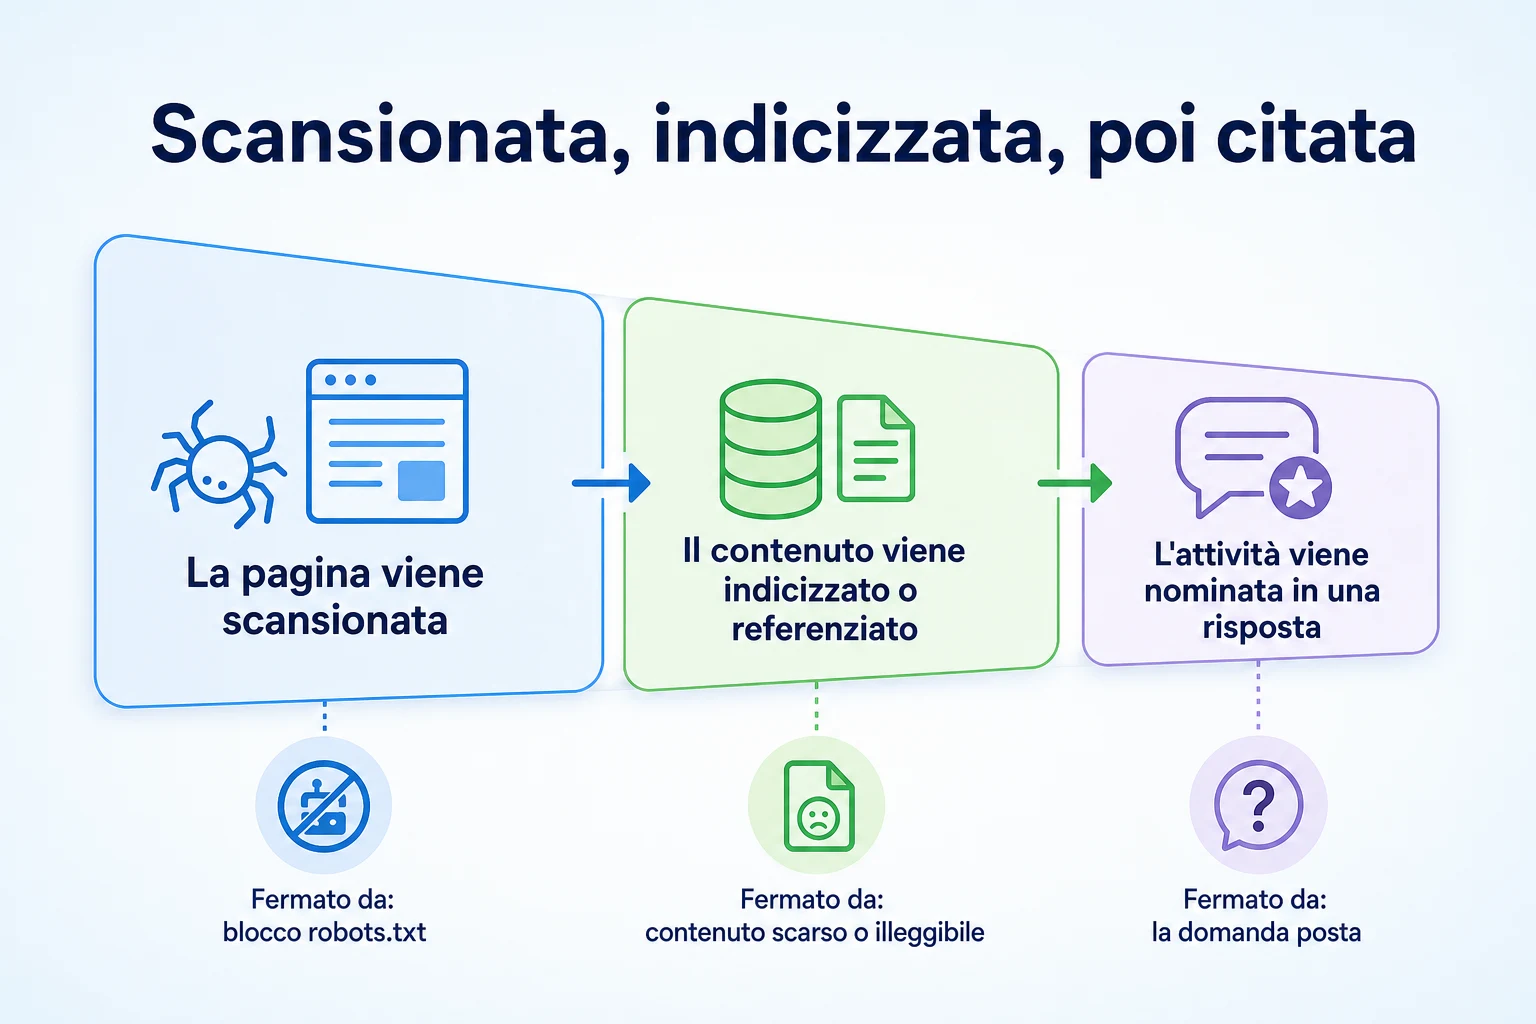
Una pagina può essere scansionata senza essere mai più referenziata, allo stesso modo in cui Googlebot può scansionare una pagina che non si posiziona mai per nulla di utile. Se un'azienda venga nominata in una particolare risposta AI dipende molto dalla domanda posta, dall'assistente utilizzato e da informazioni su cui l'azienda non ha alcun controllo.
La nostra guida su come farsi menzionare in ChatGPT e la nostra spiegazione di come gli assistenti AI decidono quali aziende consigliare vanno oltre in ciò che accade dopo che una pagina è leggibile, e in ciò che sfugge al controllo di chiunque una volta che lo è.
Un esempio pratico: seguire una pagina con gli occhi di un crawler AI
Immaginate un'azienda di giardinaggio con una pagina dedicata al servizio di cura del prato, a un indirizzo come example.com/services/lawn-care. Questo esempio è puramente illustrativo.
GPTBot richiede la pagina. Prima controlla il file robots.txt, non trova alcuna regola che lo nomini o blocchi il percorso, e la richiesta va a buon fine.
Il crawler non ha trovato questa pagina seguendo un link dalla homepage. Un link del genere non c'è. Ha trovato l'URL elencato nella sitemap del sito, ed è l'unico motivo per cui sapeva che la pagina esisteva.
Una volta caricata la pagina, il crawler legge l'HTML che riceve. La descrizione del servizio si trova in normali paragrafi, proprio lì nel codice sorgente. Lo stesso vale per i titoli: "Servizi di cura del prato", "Aree di servizio", "Cosa è incluso". Tutto questo viene letto senza alcun problema.
Più in basso nella pagina c'è una tabella dei prezzi. Sul sito attivo, il visitatore clicca su una scheda chiamata "Prezzi" e uno script carica il contenuto della tabella un istante dopo.
Il crawler non clicca mai su nulla. Legge ciò che era già presente nell'HTML al primo caricamento della pagina, e la tabella dei prezzi non c'era ancora. Per quanto il crawler può capire, la pagina non contiene informazioni sui prezzi, anche se ogni visitatore che clicca sulla scheda li vede chiaramente.
Nessuno ha costruito quella scheda per nascondere qualcosa a un crawler. È stata costruita per mantenere la pagina ordinata. L'effetto sui crawler AI non è mai rientrato nella decisione.
Una checklist di 20 minuti per verificare che il tuo sito sia scansionabile
Vale la pena eseguirla dopo ogni modifica al sito, un nuovo plugin, un aggiornamento del tema o un cambio di hosting, perché ciascuno di questi interventi può riscrivere in silenzio le regole da cui dipende un crawler.
Passaggio | Cosa controllare | Tempo |
|---|---|---|
1. Leggi il file robots.txt attivo | Verifica che non ci sia un blocco generale e nessuna regola che, per errore, copra più crawler di quelli previsti | 3 minuti |
2. Verifica l'accesso dei crawler AI per nome | Verifica che GPTBot, ClaudeBot e PerplexityBot siano consentiti o bloccati di proposito, non per errore | 3 minuti |
3. Verifica che la sitemap sia valida | Controlla che elenchi le pagine attuali e che si carichi senza errori | 3 minuti |
4. Visualizza il codice sorgente delle pagine principali | Verifica che descrizioni, prezzi e altri dati chiave compaiano davvero nell'HTML grezzo, non solo nella pagina visualizzata | 5 minuti |
5. Controlla le impostazioni del firewall o del plugin di sicurezza | Verifica che i user-agent di crawler sconosciuti non siano bloccati di default | 3 minuti |
6. Verifica che le pagine pubbliche non siano protette da login | Controlla che le pagine destinate a essere trovate si carichino senza effettuare l'accesso o inserire un'email | 3 minuti |
Venti minuti bastano per individuare la maggior parte dei blocchi involontari trattati in questo articolo. Il Controllo crawler AI, il Controllo robots.txt, il Controllo e ricerca sitemap e il Controllo visibilità HTML per LLM gratuiti di RepGet possono velocizzare la maggior parte di questi passaggi, evitando di verificarli uno per uno a mano.
Dove si colloca RepGet
Capire quale crawler può raggiungere quale pagina, e quali dati si trovano davvero nell'HTML grezzo, è un lavoro dettagliato e un po' tecnico, che è facile rimandare.
Il audit gratuito del sito web di RepGet analizza un sito, gli assegna un punteggio SEO da 0 a 100 ed elenca i problemi tecnici e di contenuto da approfondire, che possono far emergere un problema nel robots.txt o una pagina povera di contenuti insieme ad altri aspetti da correggere durante la stessa verifica. Il suo Controllo crawler AI gratuito verifica se GPTBot, ClaudeBot e PerplexityBot possono attualmente raggiungere un determinato sito, mentre il suo Controllo visibilità HTML per LLM gratuito mostra quanto del testo di una pagina è effettivamente presente nell'HTML che riceve un crawler. Per nessuno di questi strumenti serve un account o una carta di credito.
Nessuno di questi strumenti può dirvi se uno specifico assistente AI nominerà la vostra attività in una determinata risposta, e RepGet non lo garantisce. Quello che possono fare è mostrarvi, in pochi minuti, se l'accesso e i contenuti ci sono fin dall'inizio, ed è la parte su cui un'azienda ha davvero il controllo.
In sintesi
Un crawler web AI non è misterioso una volta che lo si scompone. Controlla il robots.txt, richiede la pagina, legge l'HTML che riceve e a volte segue un link verso la pagina successiva.
La maggior parte di ciò che tiene lontani questi crawler non è intenzionale. Una regola residua nel robots.txt, un firewall che blocca di default i bot sconosciuti, una barriera di login aggiunta per un motivo non correlato, oppure un dato che si carica solo dopo un clic o uno script: tutti questi elementi possono impedire in silenzio a un crawler di vedere contenuti che un visitatore vede senza difficoltà.
Risolvere il problema significa garantire l'accesso e contenuti semplici e leggibili, non offrire garanzie oltre questo. Essere scansionati non garantisce di essere indicizzati, e essere indicizzati non garantisce di essere citati in una particolare risposta AI. Gli ultimi passaggi dipendono da molto più di quanto un singolo sito web possa controllare.
Scopri per prima cosa di cosa ha bisogno il tuo sito
Prima di inseguire una specifica impostazione per un crawler, verifica cosa consente attualmente il tuo sito e dove i suoi contenuti potrebbero essere carenti. Esegui un audit gratuito del sito web con RepGet per controllare la configurazione tecnica del sito insieme ai suoi contenuti. Non serve un account né una carta di credito.
Domande frequenti
Che cos'è un crawler AI?
È un software automatico, come GPTBot o ClaudeBot, che richiede pagine di un sito web per raccogliere testo per scopi documentati dall'azienda di AI, come addestrare un modello o basare le risposte di un assistente su informazioni aggiornate.
Come so se il crawler di ChatGPT ha visitato il mio sito?
Controlla i log del server per le richieste di GPTBot, oppure usa uno strumento di verifica che controlla se GPTBot può accedere al tuo sito in questo momento. I log mostrano le visite effettive passate; lo strumento mostra se l'accesso è consentito adesso.
Posso bloccare i crawler AI senza bloccare Google?
Sì. Assegna a ogni crawler un blocco
User-agentcon il suo nome in robots.txt, così una regola scritta per un crawler AI non si applica per errore a Googlebot o ad altri crawler.JavaScript impedisce ai crawler AI di leggere il mio sito?
Molti crawler AI leggono l'HTML grezzo inviato dal server senza eseguire JavaScript come farebbe un browser. Il contenuto che compare solo dopo l'esecuzione di uno script può restare invisibile a loro, anche se i visitatori lo vedono senza problemi.
Perché la mia attività non compare in ChatGPT anche se Google può scansionare il mio sito?
Googlebot e i crawler AI seguono regole separate e possono essere consentiti o bloccati indipendentemente l'uno dall'altro. Inoltre, il fatto che una pagina venga scansionata non garantisce che venga referenziata o nominata in una specifica risposta AI.
Ho bisogno di un file llms.txt per i crawler AI?
No. È un file facoltativo e più recente, e non tutti i crawler AI sono documentati come capaci di leggerlo. Non sostituisce robots.txt né la sitemap, che restano i segnali principali su cui si basano i crawler.
Con quale frequenza i crawler AI visitano un sito web?
Varia in base al crawler e al sito, e le aziende non pubblicano una frequenza fissa. Controllare i log del server nel tempo è l'unico modo affidabile per capire quanto spesso un determinato crawler visita davvero il tuo sito.
GPTBot è lo stesso di Googlebot?
No. Sono gestiti da aziende diverse per scopi diversi: GPTBot è il crawler di OpenAI, Googlebot scansiona per Google Search, e ognuno segue le proprie regole separate in robots.txt.