

Generatore Robots.txt: come creare un file sicuro per Google e l'IA
Risposta breve
Un file robots.txt sicuro consente a Google, Bing e agli eventuali crawler IA che vuoi far passare, bloccando solo le pagine che davvero non vuoi far scansionare, come le schermate di amministrazione o i risultati di ricerca interni. Usa un generatore o un modello come punto di partenza, non copiare mai il file di un altro sito così com'è, poi verificalo con un controllo robots.txt prima di pubblicarlo online. Una riga sbagliata può nascondere un intero sito dalla ricerca.
Un piccolo imprenditore trova un file robots.txt online.
Sembra ufficiale, arriva da un sito dello stesso settore e incollarlo sembra la cosa sicura e accurata da fare.
Qualche settimana dopo, le pagine dei servizi che comparivano su Google sono sparite senza che nessuno se ne accorgesse.
Nessuno ha toccato i contenuti. Nessuno ha cambiato gli URL. L'unica cosa cambiata era quel file preso in prestito, e una riga al suo interno diceva ai motori di ricerca di stare lontani dalla cartella esatta in cui si trovano quelle pagine.
Succede più spesso di quanto dovrebbe, di solito perché un generatore robots.txt o un modello viene copiato senza verificare cosa fa ogni riga su questo specifico sito.
Un file robots.txt è un file di testo semplice e piccolo, ma con conseguenze reali. Fatto bene, tiene lontani in silenzio i crawler dalle pagine che non volevi far indicizzare comunque. Fatto male, può nascondere l'intero sito, o gli assistenti IA che i tuoi clienti ora usano per trovare attività come la tua.
Ecco come crearne uno sicuro per Google, Bing e i crawler IA che vuoi davvero far visitare il sito, usando un generatore robots.txt come punto di partenza e non come scorciatoia.
Cosa fa davvero un file Robots.txt (e cosa non fa)
Robots.txt è un insieme di istruzioni per i crawler. Indica ai bot ben educati quali parti di un sito possono scansionare e quali devono lasciare stare.
Questo è tutto il suo compito. Non è uno strumento di sicurezza e non garantisce cosa compare nei risultati di ricerca.
Cosa può controllare robots.txt
Può dire a un crawler di non richiedere determinati URL o cartelle. La documentazione di Google su come funziona robots.txt lo descrive come un modo per gestire il traffico dei crawler, non come un modo per tenere le pagine fuori da Google del tutto.
Un file ben scritto può evitare che i crawler perdano tempo su schermate di amministrazione, risultati di ricerca interni o pagine duplicate con parametri, cosa davvero utile su un sito più grande.
Cosa non può controllare
Una pagina bloccata può comunque essere indicizzata se altri siti vi fanno dei link. Google può mostrare l'URL nei risultati di ricerca senza descrizione, perché non gli è mai stato permesso di scansionare la pagina per vedere cosa contiene.
Robots.txt inoltre non impedisce a chi ha già il link di visualizzare la pagina. Non è una protezione con password e non nasconde informazioni sensibili a un visitatore determinato.
Robots.txt e il tag noindex
Se l'obiettivo è davvero tenere una pagina fuori dai risultati di Google, un meta tag noindex svolge questo compito. Robots.txt svolge un compito diverso: blocca la scansione, non necessariamente l'inserimento in elenco.
Usare entrambi insieme di solito si ritorce contro. Se una pagina è bloccata in robots.txt, Google non può scansionarla per vedere il tag noindex, quindi le due istruzioni possono contrastarsi invece di lavorare insieme.
Metodo | Cosa fa | Quando usarlo |
|---|---|---|
Disallow in robots.txt | Chiede ai crawler di non richiedere un URL o una cartella | Pagine di scarso valore che non vuoi far scansionare affatto, come i risultati di ricerca interni |
Tag noindex | Consente la scansione, ma chiede ai motori di ricerca di non inserire la pagina in elenco | Pagine che devono essere scansionate e comprese, ma non devono comparire nei risultati |
Protezione con password | Blocca l'accesso finché non viene fornito un login | Contenuti davvero privati o sensibili che non devono essere visibili a nessuno senza invito |
Le poche regole da conoscere davvero (con esempi di sintassi robots.txt)
La maggior parte dei file robots.txt, anche su siti grandi, usa solo una manciata di direttive. Non serve memorizzare una lunga specifica per scriverne uno sicuro.
User-agent e Disallow
User-agent indica a quale crawler si applica una regola, e Disallow indica un percorso che quel crawler non deve richiedere. Una riga User-agent: * si applica a ogni crawler che non ha un blocco specifico tutto suo.
Una riga Disallow: vuota significa che per quel crawler non è bloccato nulla, un dettaglio facile da perdere quando si scorre rapidamente un file.
Allow e caratteri jolly
Allow crea un'eccezione all'interno di una cartella bloccata più ampia, utile quando la maggior parte di una directory deve restare nascosta ma un file o una sottocartella no. I caratteri jolly, scritti come *, permettono a una sola riga di corrispondere a uno schema di URL invece che a un unico percorso esatto.
La guida di Google alla creazione di un file robots.txt spiega la sintassi completa, inclusa la modalità di risoluzione delle regole quando più di una si applica allo stesso URL.
Indicare la sitemap
Una riga Sitemap non è affatto una regola di scansione. Indica semplicemente ai crawler dove trovare la tua sitemap XML, il che rende più facile scoprire le tue pagine.
Direttiva | Cosa fa | Esempio |
|---|---|---|
User-agent | Indica il blocco di regole a cui si applica il crawler |
|
Disallow | Chiede al crawler indicato di non richiedere un percorso |
|
Allow | Crea un'eccezione all'interno di un percorso bloccato |
|
Sitemap | Indica ai crawler la posizione della sitemap XML |
|
Come creare un file robots.txt sicuro per un sito di piccola impresa
La maggior parte dei siti di piccole imprese non ha bisogno di un file complicato. Ne serve uno breve, che blocchi pochissimo e lo dichiari chiaramente.
Un file di base da cui partire e adattare
Immagina il sito di un'azienda idraulica locale, con pagine dei servizi, un blog, un modulo di contatto e una schermata di accesso per il personale. Questi URL sono solo esempi.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /cart/
Sitemap: https://example.com/sitemap.xml
Quasi tutto il sito resta aperto alla scansione. Gli unici percorsi bloccati sono un'area di amministrazione e una pagina del carrello, di cui né un cliente né un motore di ricerca hanno bisogno.
Prima di pubblicare un file del genere, vale la pena testare robots.txt e confermare che l'indirizzo della sitemap sia corretto e che la sitemap sia valida. Il Sitemap Checker & Finder gratuito di RepGet può trovare e verificare la sitemap di un sito in pochi secondi.
Gli errori che bloccano Google per sbaglio
Quasi ogni file robots.txt dannoso non è stato scritto per causare danni. È stato scritto per una situazione e poi lasciato al suo posto per un'altra.
Un blocco rimasto da un sito di staging
I siti di sviluppo e di staging spesso contengono una regola generale come Disallow: /, che dice a ogni crawler di stare lontano dall'intero sito. Ha senso mentre il sito è in costruzione.
Diventa un problema serio se lo stesso file viene copiato sul dominio live durante il lancio e nessuno rimuove poi il blocco generale.
Bloccare le cartelle dove si trovano CSS e immagini
Alcuni modelli più vecchi bloccano cartelle come /wp-includes/ o la directory delle risorse di un tema, presupponendo che i crawler si interessino solo al testo. La documentazione di Google chiarisce che bloccare le risorse necessarie a una pagina per il rendering, come i file CSS e JavaScript, può impedire a Google di capire correttamente la pagina.
Percorsi sensibili alle maiuscole ed errori di battitura
I percorsi in robots.txt distinguono le maiuscole, quindi Disallow: /Contact non corrisponde a un URL su /contact. Un semplice refuso nel nome di una cartella può far sì che il blocco previsto non faccia nulla, mentre un carattere sbagliato altrove può bloccare molto di più del previsto.
Errore | Effetto sulla scansione | Come risolverlo |
|---|---|---|
Blocco di staging rimasto ( | Nasconde l'intero sito live ai crawler | Rimuovere la regola generale una volta che il sito è online |
Blocco delle cartelle CSS o JavaScript | Impedisce a Google di eseguire il rendering e comprendere completamente le pagine | Consentire le cartelle che contengono gli stili e gli script necessari alle pagine |
Maiuscole sbagliate o refuso in un percorso | Blocca l'URL sbagliato, oppure non blocca quello previsto | Copiare i percorsi direttamente dalla barra degli indirizzi del browser e ricontrollare le maiuscole |
Blocco accidentale dell'intero blog | Rimuove nel tempo un'intera sezione di contenuti dai risultati di ricerca | Verificare che ogni cartella bloccata sia indicata con precisione e intenzionalmente |
La nostra checklist su come far indicizzare il tuo sito da Google è utile da rivedere se alcune pagine sembrano mancare dalla ricerca per motivi diversi da robots.txt.
Decidere se consentire o bloccare i crawler IA
Accanto a Googlebot e Bingbot, un nuovo gruppo di crawler visita ora i siti per conto degli assistenti IA. GPTBot raccoglie pagine per i modelli di OpenAI, ClaudeBot fa qualcosa di simile per Anthropic e PerplexityBot esamina le pagine da cui le risposte di Perplexity potrebbero attingere.
Nessuno di questi è un crawler dei motori di ricerca in senso tradizionale. Consentirli o bloccarli non influisce sulla presenza del tuo sito su Google. Influisce invece sulla possibilità che queste aziende accedano alle tue pagine, per qualunque scopo utilizzino tale accesso.
Perché un'azienda potrebbe bloccare un crawler IA
Alcune aziende preferiscono che i propri contenuti originali, i prezzi e le fotografie non vengano usati per addestrare un modello con cui non hanno alcun rapporto. È una posizione ragionevole, e robots.txt è il metodo documentato per esprimerla.
Un'azienda con contenuti dietro un paywall, o con pagine piene di dati proprietari che non vuole vengano copiati, ha un motivo altrettanto chiaro per bloccare.
Perché un'azienda potrebbe consentirne uno
Un'azienda che vuole comparire quando qualcuno chiede a un assistente IA di consigliare un'impresa come la sua di solito deve permettere al crawler pertinente di leggere prima il sito. Se GPTBot non riesce ad accedere alle tue pagine di servizio, è meno probabile che ChatGPT le abbia viste.
La nostra guida su come essere menzionati in ChatGPT approfondisce il tema, incluso ciò da cui dipende e ciò da cui non dipende apparire in una risposta IA.
Nome del crawler | Gestito da | Cosa fa il blocco |
|---|---|---|
GPTBot | OpenAI | Impedisce a OpenAI di scansionare il sito per i suoi scopi documentati, incluso l'addestramento dei modelli |
ClaudeBot | Anthropic | Impedisce al crawler di Anthropic di accedere alle pagine del sito |
PerplexityBot | Perplexity | Impedisce al crawler di Perplexity di accedere alle pagine che potrebbe altrimenti usare in una risposta |
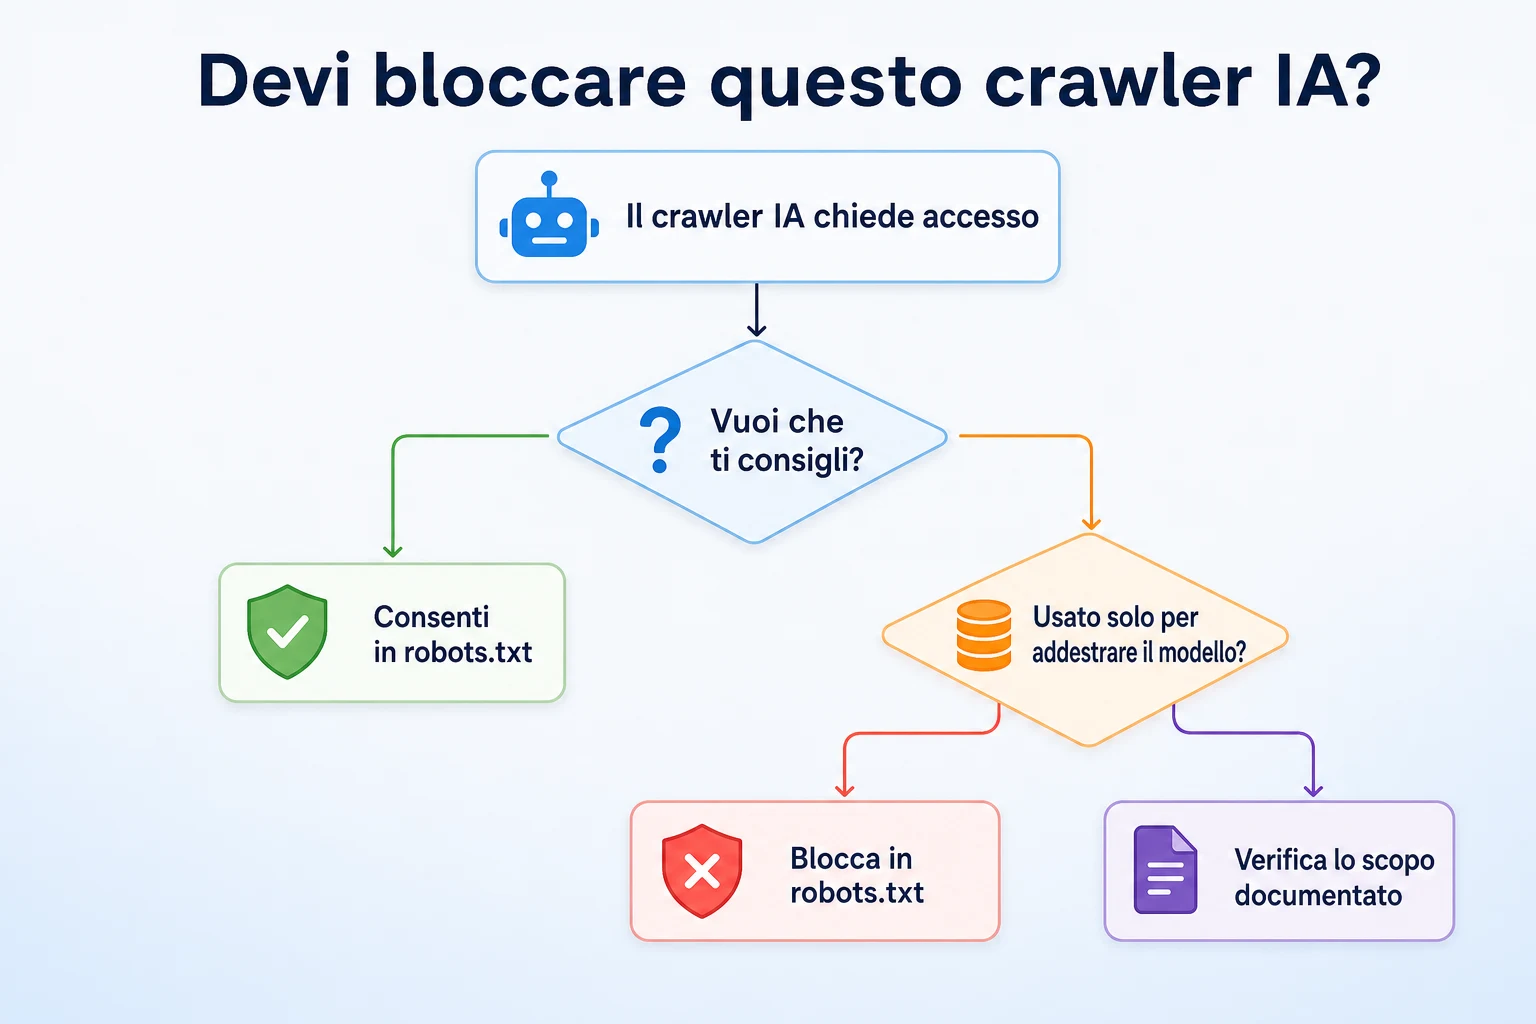
OpenAI descrive il comportamento di GPTBot e come controllarlo nella sua documentazione sui crawler, che vale la pena leggere direttamente invece di affidarsi a un riassunto di seconda mano, perché i nomi dei crawler e le politiche cambiano.
Prima di decidere qualsiasi cosa, è utile sapere cosa consente attualmente il tuo sito. Il Controllo Crawler IA gratuito di RepGet verifica se GPTBot, ClaudeBot e PerplexityBot possono attualmente raggiungere un determinato sito.
Regole di scrittura per i crawler IA senza bloccare i motori di ricerca
La parte che mette in difficoltà molti è mescolare le regole dei crawler IA nello stesso blocco che governa Googlebot e Bingbot. Una singola riga inserita nel punto sbagliato può finire per bloccare molto più del previsto.
Ogni crawler che vuoi trattare in modo diverso ha bisogno del proprio blocco User-agent. Le regole scritte sotto User-agent: * si applicano a tutto ciò che non ha un blocco più specifico, quindi un crawler citato separatamente ignora completamente le regole generali e segue solo quelle scritte per lui con il nome.
Esempio: bloccare i crawler IA ma mantenere Google e Bing
Immagina un sito che vuole restare completamente aperto ai motori di ricerca tenendo fuori i crawler IA. Queste regole sono solo a scopo illustrativo.
User-agent: Googlebot
Disallow:
User-agent: Bingbot
Disallow:
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: PerplexityBot
Disallow: /
Sitemap: https://example.com/sitemap.xml
Ogni crawler citato qui segue solo il blocco scritto per lui. Googlebot e Bingbot vedono una riga disallow vuota, che significa che nulla è escluso. I tre crawler IA vedono Disallow: /, che blocca l'intero sito per loro in modo specifico.
Esempio: consentire a tutti di scansionare
Un'azienda a proprio agio con la visita dei crawler IA non ha bisogno di blocchi separati per loro. Una sola sezione User-agent: * con poco o nessun elemento escluso copre già ogni crawler, citato per nome o no.
User-agent: *
Disallow:
Sitemap: https://example.com/sitemap.xml
Questo è il file più semplice, ed è un'impostazione predefinita ragionevole per un'azienda che non cerca di escludere alcun crawler in particolare. Aggiungere blocchi con nome ha senso solo quando esiste un crawler specifico che vuoi trattare diversamente dagli altri.
Usare un generatore robots.txt in sicurezza
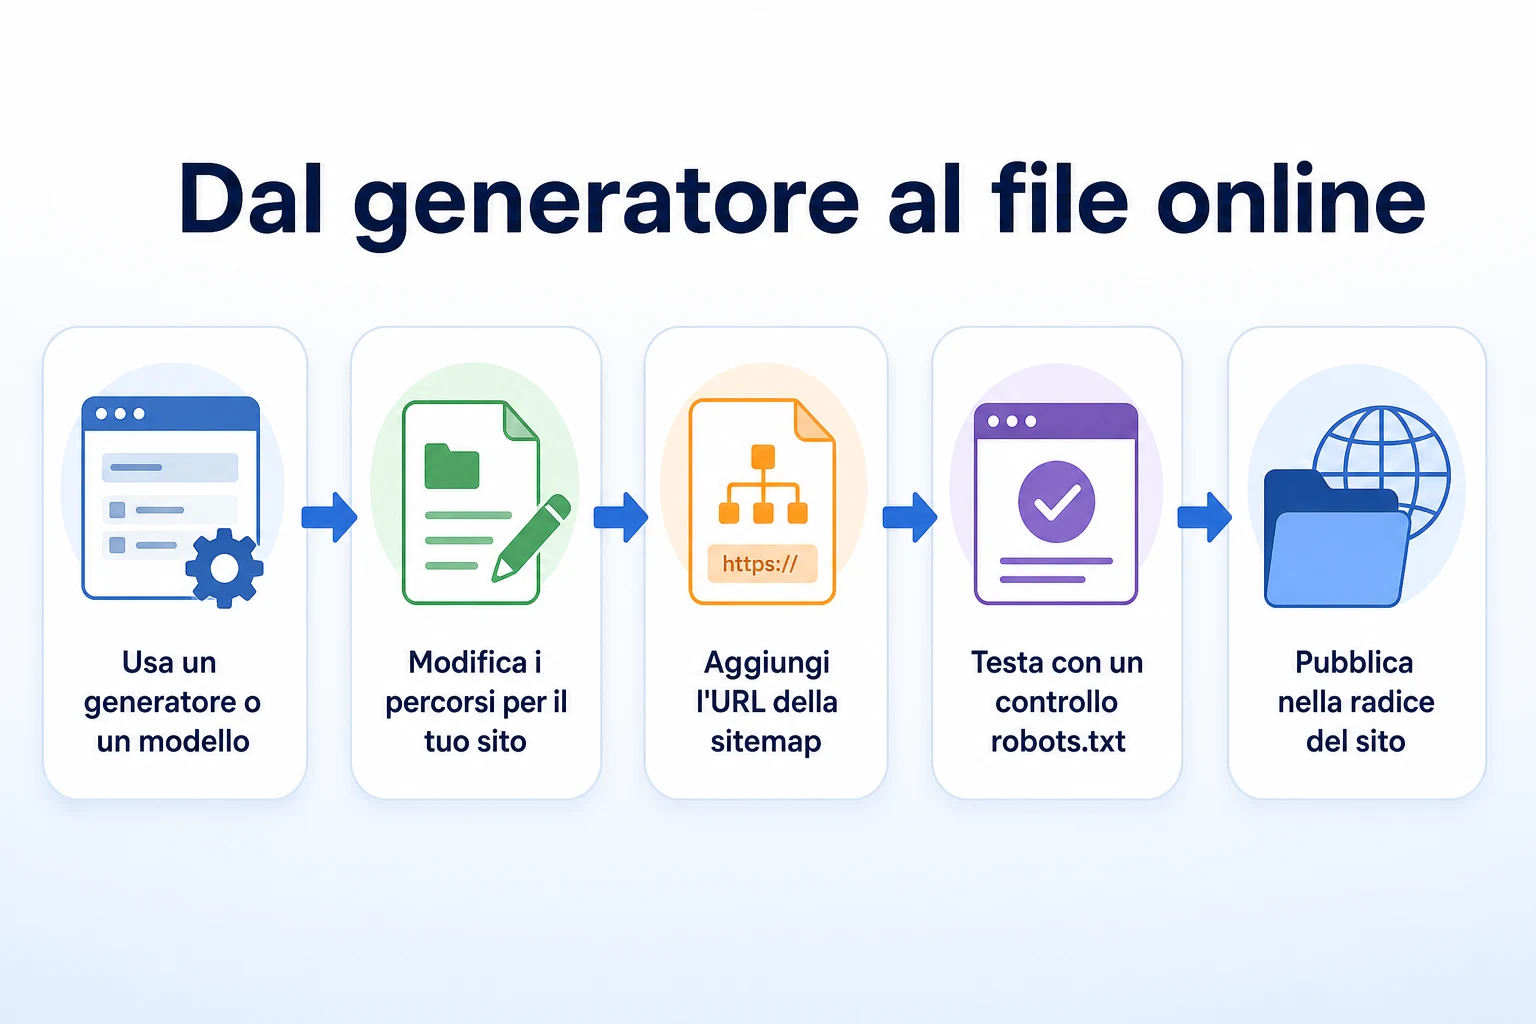
Un generatore può far risparmiare tempo, ma vale la pena capire cosa fa davvero prima di fidarsi di ciò che restituisce.
Cosa produce davvero un generatore
La maggior parte dei generatori pone alcune domande, come quali cartelle bloccare e quali crawler citare, poi assembla un file da queste risposte usando una sintassi standard. Alcuni offrono modelli predefiniti per piattaforme comuni come WordPress o Shopify.
Questo è davvero utile per ottenere la sintassi giusta. Pochi ricordano a memoria se una barra finale conta o come vengono interpretati i caratteri jolly, e un generatore elimina questa incertezza.
Ciò che un generatore non può fare è sapere quali cartelle del tuo sito specifico debbano davvero essere bloccate. Non conosce la struttura degli URL, il percorso di accesso riservato al personale o le parti del sito che contano per la tua attività. Queste risposte arrivano solo da chi conosce il sito.
Cosa controllare prima di fidarti del risultato
Leggi ogni riga prodotta dal generatore prima di pubblicarla, invece di considerare il risultato come definitivo. Verifica che ogni percorso escluso esista davvero sul tuo sito e che meriti davvero di essere bloccato.
Controlla che la riga della sitemap punti al tuo indirizzo reale della sitemap, non a un segnaposto rimasto dal modello predefinito dello strumento. Controlla che nulla blocchi le cartelle di CSS, JavaScript o immagini, perché alcuni modelli più datati tramandano ancora questo consiglio come impostazione predefinita.
Quando il file sembra corretto, verifica che si comporti come previsto prima che vada online. Il Controllo Robots.txt gratuito di RepGet fornisce un esito sia per i motori di ricerca sia per i crawler IA insieme, un modo più rapido per individuare un errore rispetto a leggere il testo grezzo riga per riga.
Dove mettere il file e come pubblicarlo
Un file robots.txt funziona solo se i crawler riescono a trovarlo nell'unico posto in cui sono progettati per cercarlo.
Deve trovarsi nella radice del dominio, come file di testo semplice con il nome esatto robots.txt, raggiungibile a un indirizzo come https://example.com/robots.txt. Una copia collocata in una sottocartella, o salvata con un nome di file diverso, non verrà letta da nessun crawler.
WordPress
WordPress genera automaticamente un file robots.txt virtuale di base, visibile all'indirizzo consueto anche senza un file fisico sul server. La maggior parte dei plugin SEO ti permette di modificarne il contenuto direttamente dalla bacheca, più semplice che gestire un file separato tramite l'accesso all'hosting.
Se nella cartella radice del sito esiste già un file robots.txt fisico, di solito ha la precedenza su quello virtuale, quindi vale la pena verificare quale versione viene effettivamente servita prima di dare per scontato che una modifica del plugin abbia avuto effetto.
Shopify e altre piattaforme ospitate
Shopify e diverse altre piattaforme ospitate generano automaticamente un robots.txt predefinito e, a seconda della piattaforma, possono consentire modifiche tramite un file modello o un'impostazione del tema invece di un caricamento diretto. Il metodo esatto varia da piattaforma e a volte dal piano, quindi conviene consultare la documentazione di aiuto della piattaforma invece di presumere che una modifica in stile WordPress funzioni allo stesso modo.
Qualunque sia la piattaforma, il test è sempre lo stesso: visita direttamente l'indirizzo online in un browser e leggi esattamente ciò che è pubblicato, perché è l'unica versione che i crawler vedono.
Testare il tuo robots.txt prima di pubblicarlo
Un file robots.txt può sembrare corretto e comportarsi comunque in modo diverso da come avevi previsto. L'unico modo per esserne sicuri è testarlo, non limitarsi a leggerlo.
Controllare il file manualmente
Inizia digitando direttamente nel browser l'indirizzo del file, con un percorso come https://example.com/robots.txt. Quello che si carica lì è esattamente ciò che vede ogni crawler, quindi vale la pena leggerlo con occhi nuovi invece di fidarsi del file che pensi di aver caricato.
Verifica che la riga della sitemap rimandi a una sitemap reale e funzionante. Controlla che ogni percorso bloccato sia uno che avevi davvero intenzione di bloccare, e che nulla di importante ci finisca dentro per errore. Se il file è stato modificato tramite un plugin o un'impostazione del tema, assicurati che la versione online corrisponda a quella che hai salvato, perché a volte una copia in cache può restare attiva più a lungo del previsto.
Controllare il file con un checker per robots.txt
Leggere il file permette di individuare errori di battitura ed evidenti sviste, ma non sempre ti dice come un crawler specifico interpreta regole che si sovrappongono. Un checker svolge questo lavoro al posto tuo.
Il Robots.txt Checker gratuito di RepGet fornisce un esito valido sia per i motori di ricerca sia per i crawler IA, così puoi verificare in un'unica passata che Googlebot e Bingbot siano consentiti dove previsto e che ogni crawler IA che hai indicato venga trattato come desideri, che sia consentito o bloccato.
Ripeti il controllo dopo ogni modifica al file, anche piccola. Basta una singola riga spostata nel blocco sbagliato per annullare quello che il resto del file fa correttamente.
Una checklist di 20 minuti per rivedere un file robots.txt esistente
La maggior parte dei siti aziendali ha già un file robots.txt, anche se nessuno ricorda di averlo scritto. Vale la pena dedicargli una breve verifica programmata invece di dare per scontato che stia ancora facendo quello per cui era stato pensato.
Passaggio | Cosa controllare | Tempo |
|---|---|---|
1. Carica il file online | Visita direttamente l'indirizzo del file e leggi ciò che è effettivamente pubblicato, non una bozza salvata | 2 minuti |
2. Cerca un blocco generale | Verifica che non ci sia un | 2 minuti |
3. Controlla ogni percorso bloccato | Verifica che ogni cartella bloccata esista ancora e che meriti ancora di essere bloccata | 5 minuti |
4. Controlla l'accesso a CSS e JavaScript | Verifica che nulla blocchi le cartelle di cui le pagine hanno bisogno per essere visualizzate correttamente | 3 minuti |
5. Rivedi i blocchi dei crawler IA indicati per nome | Verifica che GPTBot, ClaudeBot e PerplexityBot siano consentiti o bloccati di proposito, non per impostazione predefinita | 3 minuti |
6. Conferma la riga della sitemap | Verifica che rimandi a un indirizzo di sitemap reale e aggiornato | 2 minuti |
7. Esegui uno strumento di verifica | Verifica che gli esiti corrispondano a ciò che avevi previsto per ogni crawler | 3 minuti |
Venti minuti bastano per individuare il tipo di errore che altrimenti resta inosservato per mesi. Imposta un promemoria in agenda ogni pochi mesi, oppure ogni volta che il sito passa a un nuovo hosting, tema o piattaforma, perché questi cambiamenti a volte riscrivono il file senza che nessuno lo decida.
Dove si inserisce RepGet
Decidere quali cartelle vanno bloccate e quali crawler IA un'azienda vuole davvero che leggano le sue pagine è una valutazione che spetta a chi gestisce il sito. Nessuno strumento può prendere questa decisione al posto tuo, perché dipende da cosa vende l'azienda, da ciò con cui si sente a proprio agio e da ciò che i clienti cercano davvero.
RepGet può invece aiutarti a verificare più in fretta il risultato di questa decisione. Il suo Robots.txt Checker gratuito fornisce un esito valido per i motori di ricerca e per i crawler IA insieme, così un file modificato a mano o prodotto da un generatore può essere confermato in pochi secondi invece di essere letto riga per riga. Il suo audit del sito gratuito analizza un sito, gli assegna un punteggio SEO da 0 a 100 ed elenca i problemi tecnici da approfondire, il che può far emergere un problema del robots.txt insieme ad altri aspetti da sistemare durante la stessa visita. Per entrambi non serve un account né una carta di credito.
RepGet non scrive il file robots.txt di un'azienda al suo posto, non decide quali crawler IA un'azienda dovrebbe accogliere e non garantisce che consentire un crawler porti a una menzione nella risposta di un assistente IA o a una certa posizione su Google. Questi risultati dipendono da molto più di un piccolo file di testo, e nessuno può prometterli.
In conclusione
Un file robots.txt sicuro è breve, scritto con intenzione, e ogni percorso bloccato ha una ragione chiara alle spalle.
Un generatore o un modello è un buon punto di partenza, ma il risultato va comunque riletto da qualcuno che conosce il sito, va verificato che la riga della sitemap sia reale e va testato prima di pubblicarlo. La stessa attenzione vale per i crawler IA: indicarne uno in un blocco separato ti permette di consentirlo o bloccarlo in modo deliberato, senza toccare le regole che fanno sì che Google e Bing continuino a scansionare normalmente.
Nulla di tutto questo garantisce un posizionamento, una presenza nella risposta di un assistente IA o una quantità specifica di traffico. Serve invece a fare in modo che il file non stia lavorando in silenzio contro il sito che dovrebbe proteggere.
Scopri prima di cosa ha bisogno il tuo sito web
Prima di pubblicare un nuovo file robots.txt, verifica cosa consente attualmente il tuo sito e cos'altro potrebbe richiedere attenzione. Esegui un audit gratuito del sito con RepGet per controllare la configurazione tecnica del sito insieme ai suoi contenuti. Non serve un account né una carta di credito.
Domande frequenti
Un generatore di robots.txt può bloccare Google per errore?
Sì, se il suo output predefinito o un modello copiato include una regola generica o un percorso scritto male. Leggi sempre ciò che produce un generatore e verificalo con un controllo prima di pubblicarlo su un sito online.
Ho bisogno di un file robots.txt se il mio sito è piccolo?
Un sito piccolo può funzionare anche senza, perché i crawler lo scansionano comunque per impostazione predefinita. Un file breve vale comunque la pena se vuoi bloccare una cartella specifica o indicare ai crawler la tua sitemap.
Come blocco ChatGPT dalla scansione del mio sito web?
Aggiungi al tuo file robots.txt un blocco
User-agent: GPTBotconDisallow: /. OpenAI documenta direttamente il comportamento di GPTBot, quindi conviene controllare la sua documentazione aggiornata sui crawler prima di affidarti a questa regola.Dove devo caricare il file robots.txt?
Deve trovarsi nella radice del dominio, come file di testo semplice chiamato esattamente
robots.txt, raggiungibile a un indirizzo comehttps://example.com/robots.txt. Una copia in una sottocartella non verrà letta dai crawler.Bloccare GPTBot impedisce al mio sito di comparire nelle risposte di ChatGPT?
Bloccare GPTBot impedisce al crawler di OpenAI di accedere alle tue pagine per gli scopi documentati. Non garantisce nulla su se o come un'attività venga menzionata nella risposta di un assistente IA.
Con quale frequenza dovrei controllare il file robots.txt?
Una revisione rapida ogni pochi mesi è ragionevole, ed è utile ricontrollarlo ogni volta che il sito cambia host, tema o piattaforma, perché questi cambiamenti a volte riscrivono il file senza che nessuno lo decida.
Qual è la differenza tra robots.txt e un tag noindex?
Robots.txt chiede ai crawler di non richiedere affatto un URL. Un tag noindex consente la scansione ma chiede ai motori di ricerca di non inserire la pagina nei risultati. Usare entrambi sulla stessa pagina può creare conflitti.
Posso avere regole robots.txt diverse per bot IA diversi?
Sì. Ogni crawler può avere il proprio blocco
User-agentcon regole specifiche, così puoi consentire un crawler IA e bloccarne un altro senza influire affatto su Googlebot o Bingbot.