

Robots.txt-Generator: So erstellen Sie eine sichere Datei für Google und KI
Kurze Antwort
Eine sichere robots.txt-Datei erlaubt Google, Bing und allen KI-Crawlern den Zugriff, die Sie wirklich auf Ihrer Website haben möchten. Gesperrt werden nur Seiten, die nicht gecrawlt werden sollen, etwa Admin-Bereiche oder interne Suchergebnisse. Nutzen Sie einen Generator oder eine Vorlage als Ausgangspunkt und kopieren Sie niemals die Datei einer anderen Website unverändert. Testen Sie die Datei danach mit einem robots.txt-Checker, bevor Sie sie live schalten. Eine falsche Zeile kann eine ganze Website aus der Suche ausblenden.
Ein Inhaber eines kleinen Unternehmens findet online eine robots.txt-Datei.
Sie wirkt offiziell, stammt von einer Website aus einer ähnlichen Branche, und sie einzufügen fühlt sich wie der sichere und gründliche Schritt an.
Ein paar Wochen später sind Leistungsseiten, die früher bei Google zu finden waren, still und leise verschwunden.
Niemand hat am Inhalt etwas geändert. Niemand hat die URLs verändert. Das Einzige, was sich geändert hat, war diese übernommene Datei. Eine einzige Zeile darin sagte Suchmaschinen, sie sollen den genauen Ordner meiden, in dem diese Seiten liegen.
Das passiert häufiger, als es sollte, meist weil ein Robots.txt-Generator oder eine Vorlage kopiert wird, ohne zu prüfen, was jede Zeile auf genau dieser Website bewirkt.
Eine robots.txt-Datei ist eine kleine, schlichte Textdatei mit echten Folgen. Ist sie richtig, hält sie Crawler still und leise von den Seiten fern, die Sie ohnehin nicht indexiert haben wollten. Ist sie falsch, kann sie Ihre gesamte Website verbergen oder auch die KI-Assistenten, die Ihre Kunden heute nutzen, um Betriebe wie Ihren zu finden.
So erstellen Sie eine robots.txt, die sicher ist für Google, Bing und die KI-Crawler, die Sie tatsächlich zulassen möchten. Nutzen Sie dabei einen Robots.txt-Generator als Ausgangspunkt und nicht als Abkürzung.
Was eine Robots.txt-Datei tatsächlich bewirkt (und was nicht)
Robots.txt ist eine Sammlung von Anweisungen für Crawler. Sie sagt gut erzogenen Bots, welche Teile einer Website sie crawlen dürfen und welche sie auslassen sollen.
Das ist die ganze Aufgabe. Es ist kein Sicherheitswerkzeug und keine Garantie dafür, was in den Suchergebnissen erscheint.
Was robots.txt steuern kann
Sie kann einem Crawler untersagen, bestimmte URLs oder Ordner abzurufen. Googles eigene Dokumentation zu der Funktionsweise von robots.txt beschreibt sie als Möglichkeit, den Crawler-Traffic zu steuern, nicht als Möglichkeit, Seiten vollständig aus Google herauszuhalten.
Eine gut geschriebene Datei kann verhindern, dass Crawler Zeit auf Admin-Bereichen, internen Suchergebnissen oder doppelten Parameter-Seiten verschwenden. Auf einer größeren Website ist das wirklich nützlich.
Was sie nicht steuern kann
Eine gesperrte Seite kann trotzdem indexiert werden, wenn andere Websites auf sie verlinken. Google zeigt die URL dann unter Umständen ohne Beschreibung in den Suchergebnissen, weil Google die Seite nie crawlen durfte, um zu sehen, was darauf steht.
Robots.txt verhindert außerdem nicht, dass jemand die Seite aufruft, der den Link bereits kennt. Es ist kein Passwortschutz und verbirgt keine sensiblen Informationen vor einem hartnäckigen Besucher.
Robots.txt im Vergleich zum noindex-Tag
Wenn das Ziel ist, eine Seite wirklich aus den Google-Ergebnissen herauszuhalten, erledigt ein noindex-Meta-Tag diese Aufgabe. Robots.txt hat eine andere Aufgabe: Sie stoppt das Crawling, nicht unbedingt den Eintrag in den Ergebnissen.
Beides gleichzeitig zu verwenden geht meist nach hinten los. Ist eine Seite in robots.txt gesperrt, kann Google sie nicht crawlen und deshalb auch nicht das noindex-Tag sehen. Die beiden Anweisungen können sich dann gegenseitig ausbremsen, statt zusammenzuarbeiten.
Methode | Was sie bewirkt | Wann sie sinnvoll ist |
|---|---|---|
Robots.txt-Disallow | Bittet Crawler, eine URL oder einen Ordner nicht abzurufen | Wenig wertvolle Seiten, die gar nicht gecrawlt werden sollen, etwa interne Suchergebnisse |
Noindex-Tag | Erlaubt das Crawling, bittet Suchmaschinen aber, die Seite nicht aufzulisten | Seiten, die gecrawlt und verstanden werden müssen, aber nicht in den Ergebnissen erscheinen sollten |
Passwortschutz | Blockiert den Zugriff vollständig, bis ein Login angegeben wird | Wirklich private oder sensible Inhalte, die niemand ohne Einladung sehen darf |
Die wenigen Regeln, die Sie wirklich kennen müssen
Die meisten robots.txt-Dateien, selbst auf großen Websites, verwenden nur eine Handvoll Direktiven. Um eine sichere Datei zu schreiben, müssen Sie keine lange Spezifikation auswendig lernen.
User-agent und Disallow
User-agent benennt den Crawler, für den eine Regel gilt, und Disallow nennt einen Pfad, den dieser Crawler nicht abrufen soll. Eine Zeile User-agent: * gilt für jeden Crawler, der keinen eigenen, spezifischen Block hat.
Eine leere Disallow:-Zeile bedeutet, dass für diesen Crawler nichts blockiert ist. Beim schnellen Durchsehen einer Datei wird das leicht übersehen.
Allow und Platzhalter
Allow nimmt eine Ausnahme innerhalb eines breiteren gesperrten Ordners aus. Das ist nützlich, wenn die meisten Inhalte eines Verzeichnisses verborgen bleiben sollen, eine Datei oder ein Unterordner aber nicht. Platzhalter, geschrieben als *, lassen eine einzelne Zeile ein Muster von URLs treffen, statt nur einen exakten Pfad.
Googles Anleitung zum Erstellen einer robots.txt-Datei behandelt die vollständige Syntax, einschließlich der Frage, wie Regeln aufgelöst werden, wenn mehr als eine auf dieselbe URL zutrifft.
Auf Ihre Sitemap verweisen
Eine Sitemap-Zeile ist überhaupt keine Crawling-Regel. Sie teilt Crawlern lediglich mit, wo sie Ihre XML-Sitemap finden, und erleichtert es ihnen so, Ihre Seiten überhaupt erst zu entdecken.
Direktive | Was sie bewirkt | Beispiel |
|---|---|---|
User-agent | Benennt den Crawler, für den ein Regelblock gilt |
|
Disallow | Bittet den genannten Crawler, einen Pfad nicht abzurufen |
|
Allow | Erstellt eine Ausnahme innerhalb eines gesperrten Pfads |
|
Sitemap | Verweist Crawler auf den Speicherort Ihrer XML-Sitemap |
|
So sieht eine sichere robots.txt für eine typische Website eines kleinen Unternehmens aus
Die meisten Websites kleiner Unternehmen brauchen keine aufwendige Datei. Sie brauchen eine kurze, die wenig blockiert und das klar zum Ausdruck bringt.
Eine Basisdatei, von der Sie ausgehen und die Sie anpassen können
Stellen Sie sich die Website eines lokalen Installationsbetriebs vor, mit Leistungsseiten, einem Blog, einem Kontaktformular und einer Anmeldeseite für Mitarbeiter. Diese URLs dienen nur als Beispiel.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /cart/
Sitemap: https://example.com/sitemap.xml
Nahezu die gesamte Website bleibt zum Crawlen offen, sodass der Googlebot in robots.txt zugelassen ist. Gesperrt sind nur ein Admin-Bereich und eine Warenkorbseite, die weder ein Kunde noch eine Suchmaschine finden muss.
Bevor Sie eine Datei wie diese veröffentlichen, sollten Sie robots.txt vor der Veröffentlichung testen. Prüfen Sie dabei, ob Ihre Sitemap-Adresse stimmt und die Sitemap selbst gültig ist. Der kostenlose Sitemap Checker & Finder von RepGet findet und prüft die Sitemap einer Website in wenigen Sekunden.
Die Fehler, die Google versehentlich blockieren
Fast jede schädliche robots.txt-Datei wurde nicht geschrieben, um Schaden anzurichten. Sie wurde für eine Situation geschrieben und dann für eine andere stehen gelassen.
Ein übrig gebliebener Block von einer Staging-Seite
Entwicklungs- und Staging-Seiten tragen oft eine pauschale Regel wie Disallow: /, die jedem Crawler sagt, dass er die gesamte Website meiden soll. Während eine Website aufgebaut wird, ist das sinnvoll.
Ernst wird es, wenn dieselbe Datei beim Livegang auf die Live-Domain kopiert wird und danach niemand die pauschale Sperre entfernt.
Blockieren der Ordner, in denen CSS und Bilder liegen
Einige ältere Vorlagen sperren Ordner wie /wp-includes/ oder das Asset-Verzeichnis eines Themes, in der Annahme, dass Crawler nur Text interessiert. Googles Dokumentation macht deutlich, dass das Sperren von Ressourcen, die eine Seite zum Rendern braucht, etwa CSS- und JavaScript-Dateien, verhindern kann, dass Google die Seite richtig versteht.
Groß- und Kleinschreibung sowie Tippfehler in Pfaden
Pfade in robots.txt unterscheiden Groß- und Kleinschreibung. Daher trifft Disallow: /Contact keine URL unter /contact. Ein einfacher Tippfehler im Ordnernamen kann dazu führen, dass die beabsichtigte Sperre ins Leere läuft, während ein verirrtes Zeichen an anderer Stelle weit mehr blockiert als geplant.
Fehler | Was er für das Crawling bewirkt | Wie Sie ihn beheben |
|---|---|---|
Übrig gebliebene Staging-Sperre ( | Verbirgt die gesamte Live-Website vor Crawlern | Entfernen Sie die pauschale Regel, sobald die Website live geht |
Blockieren von CSS- oder JavaScript-Ordnern | Verhindert, dass Google Seiten vollständig rendert und versteht | Erlauben Sie die Ordner, die Styling und Skripte enthalten, die Ihre Seiten brauchen |
Abweichende Groß- und Kleinschreibung oder Tippfehler in einem Pfad | Blockiert die falsche URL oder sperrt die beabsichtigte nicht | Kopieren Sie Pfade direkt aus der Adresszeile des Browsers und prüfen Sie die Großschreibung doppelt |
Versehentliches Sperren des gesamten Blogs | Entfernt über die Zeit einen ganzen Inhaltsbereich aus den Suchergebnissen | Prüfen Sie, dass jeder gesperrte Ordner genau und bewusst benannt ist |
Unsere Checkliste dazu, wie Sie Ihre Website von Google indexieren lassen, lohnt sich, wenn Seiten in der Suche fehlen, aus Gründen, die nichts mit robots.txt zu tun haben.
KI-Crawler in robots.txt blockieren oder zulassen
Neben Googlebot und Bingbot besuchen inzwischen auch neuere Crawler Websites im Auftrag von KI-Assistenten. GPTBot sammelt Seiten für die Modelle von OpenAI, ClaudeBot erfüllt für Anthropic einen ähnlichen Zweck, und PerplexityBot durchsucht Seiten, aus denen die Antworten von Perplexity stammen könnten.
Keiner dieser Crawler ist im klassischen Sinne ein Suchmaschinen-Crawler. Wenn Sie sie zulassen oder blockieren, hat das keinen Einfluss darauf, ob Ihre Website in Google erscheint. Es entscheidet nur darüber, ob diese Unternehmen überhaupt auf Ihre Seiten zugreifen können, und zwar für welchen Zweck auch immer sie diesen Zugriff nutzen.
Warum ein Unternehmen einen KI-Crawler blockieren könnte
Manche Unternehmen möchten nicht, dass ihre eigenen Texte, Preise und Fotos dazu verwendet werden, ein Modell zu trainieren, zu dem sie keinerlei Beziehung haben. Das ist eine nachvollziehbare Haltung, und robots.txt ist der dokumentierte Weg, sie auszudrücken.
Ein Unternehmen mit Inhalten hinter einer Paywall oder mit Seiten voller proprietärer Daten, die nicht kopiert werden sollen, hat einen ähnlich klaren Grund zu blockieren.
Warum ein Unternehmen einen KI-Crawler zulassen könnte
Ein Unternehmen, das erscheinen möchte, wenn jemand einen KI-Assistenten bittet, ein Unternehmen wie seines zu empfehlen, muss dem passenden Crawler in der Regel zuerst erlauben, die Website zu lesen. Wenn GPTBot Ihre Leistungsseiten nicht abrufen kann, ist die Wahrscheinlichkeit geringer, dass ChatGPT sie überhaupt gesehen hat.
Unser Leitfaden, wie Sie in ChatGPT erwähnt werden, geht darauf ausführlicher ein, einschließlich dessen, wovon die Nennung in einer KI-Antwort abhängt und wovon nicht.
Crawler-Name | Betrieben von | Was eine Blockade bewirkt |
|---|---|---|
GPTBot | OpenAI | Verhindert, dass OpenAI die Website für ihre dokumentierten Zwecke crawlt, einschließlich des Modelltrainings |
ClaudeBot | Anthropic | Verhindert, dass der Crawler von Anthropic auf Seiten der Website zugreift |
PerplexityBot | Perplexity | Verhindert, dass der Crawler von Perplexity auf Seiten zugreift, die sonst in einer Antwort verwendet werden könnten |
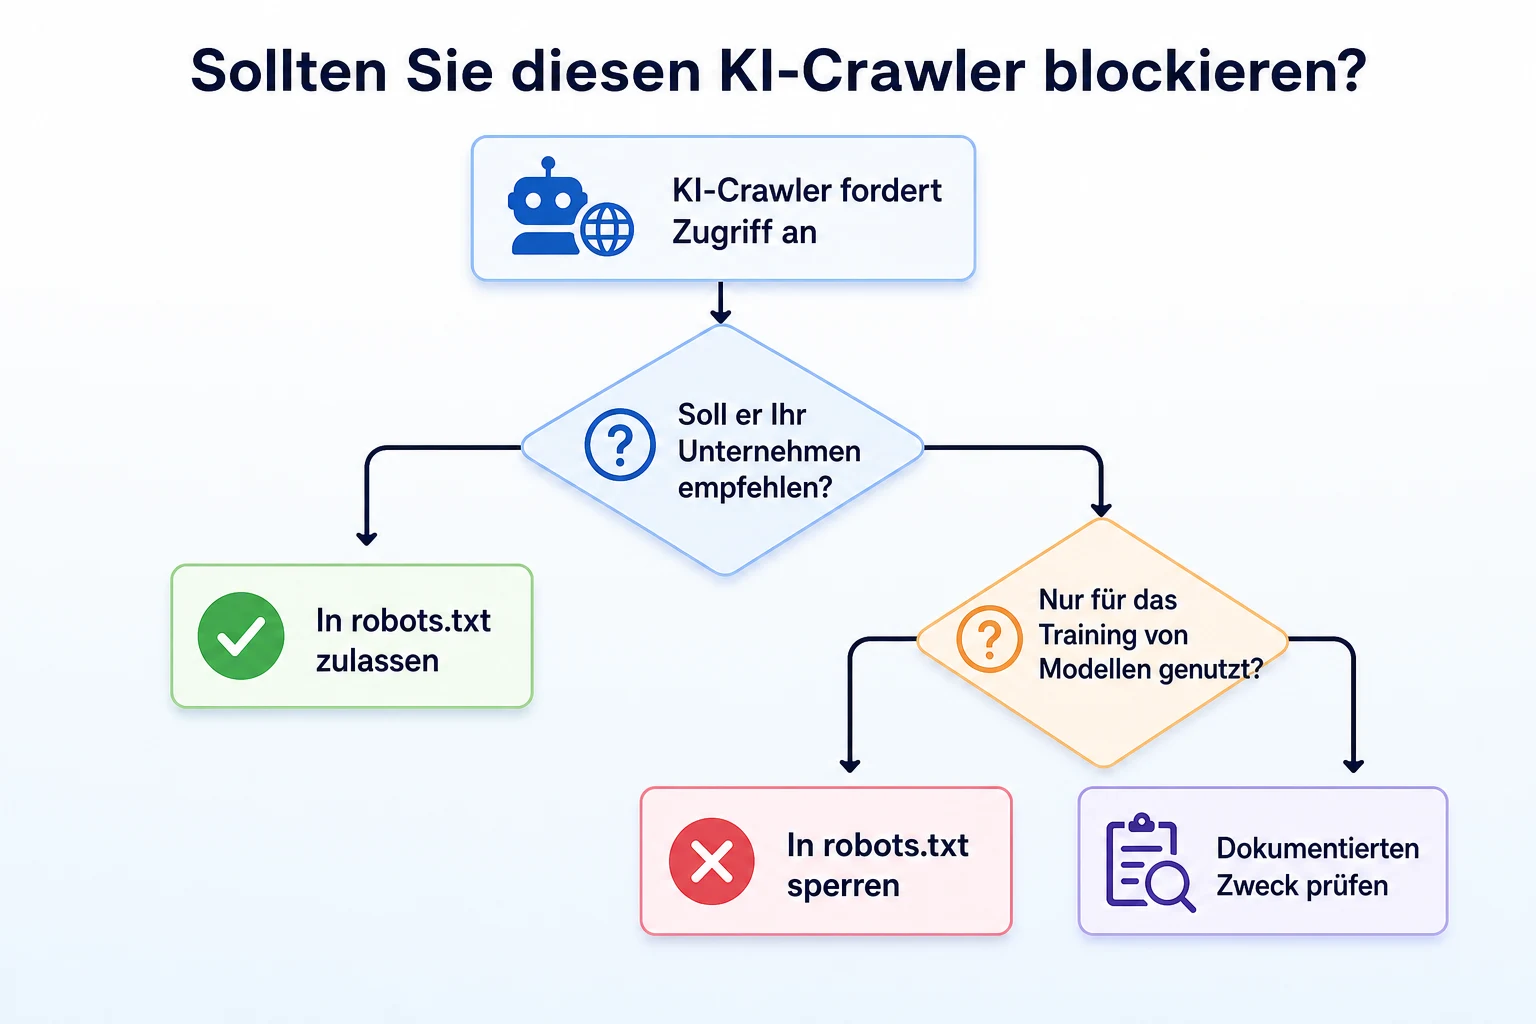
OpenAI beschreibt das Verhalten von GPTBot und wie Sie es steuern können, in seiner Crawler-Dokumentation. Diese lohnt die direkte Lektüre statt einer Zusammenfassung aus zweiter Hand, denn Crawler-Namen und Richtlinien ändern sich.
Bevor Sie etwas entscheiden, hilft es zu wissen, was Ihre Website derzeit erlaubt. Der kostenlose KI-Crawler-Checker von RepGet prüft, ob GPTBot, ClaudeBot und PerplexityBot derzeit eine Website erreichen können.
robots.txt Syntax Beispiele: KI-Crawler ohne Sperre für Suchmaschinen schreiben
Die Stelle, an der die meisten stolpern, ist, KI-Regeln in denselben Block zu schreiben, der Googlebot und Bingbot steuert. Eine einzige falsch platzierte Zeile kann weit mehr blockieren als beabsichtigt.
Jeder Crawler, den Sie anders behandeln möchten, braucht seinen eigenen User-agent-Block. Regeln unter User-agent: * gelten für alles ohne einen spezifischeren eigenen Block. Ein separat genannter Crawler ignoriert daher die allgemeinen Regeln vollständig und folgt nur den Regeln, die ausdrücklich für ihn namentlich geschrieben wurden.
Beispiel: KI-Crawler blockieren und Googlebot in robots.txt zulassen
Stellen Sie sich eine Website vor, die für Suchmaschinen vollständig offen bleiben, KI-Crawler aber fernhalten will. Diese Regeln dienen nur der Veranschaulichung.
User-agent: Googlebot
Disallow:
User-agent: Bingbot
Disallow:
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: PerplexityBot
Disallow: /
Sitemap: https://example.com/sitemap.xml
Jeder hier genannte Crawler folgt nur dem Block, der für ihn geschrieben wurde. Googlebot und Bingbot sehen eine leere Disallow-Zeile, was bedeutet, dass nichts gesperrt ist. Die drei KI-Crawler sehen jeweils Disallow: /, was die gesamte Website speziell für sie blockiert.
Beispiel: Alles crawlen lassen
Ein Unternehmen, das mit KI-Crawlern einverstanden ist, braucht für sie überhaupt keine eigenen Blöcke. Ein einziger Abschnitt User-agent: * mit wenig oder keinen Sperren deckt bereits jeden Crawler ab, ob namentlich genannt oder nicht.
User-agent: *
Disallow:
Sitemap: https://example.com/sitemap.xml
Das ist die einfachere Datei und ein vernünftiger Standard für ein Unternehmen, das keinen bestimmten Crawler ausschließen möchte. Eigene benannte Blöcke ergeben erst Sinn, wenn es einen bestimmten Crawler gibt, den Sie tatsächlich anders behandeln wollen als den Rest.
Einen Robots.txt-Generator sicher verwenden
Ein Generator kann Zeit sparen, aber Sie sollten verstehen, was er tatsächlich tut, bevor Sie dem Ergebnis vertrauen.
Was ein Generator tatsächlich erzeugt
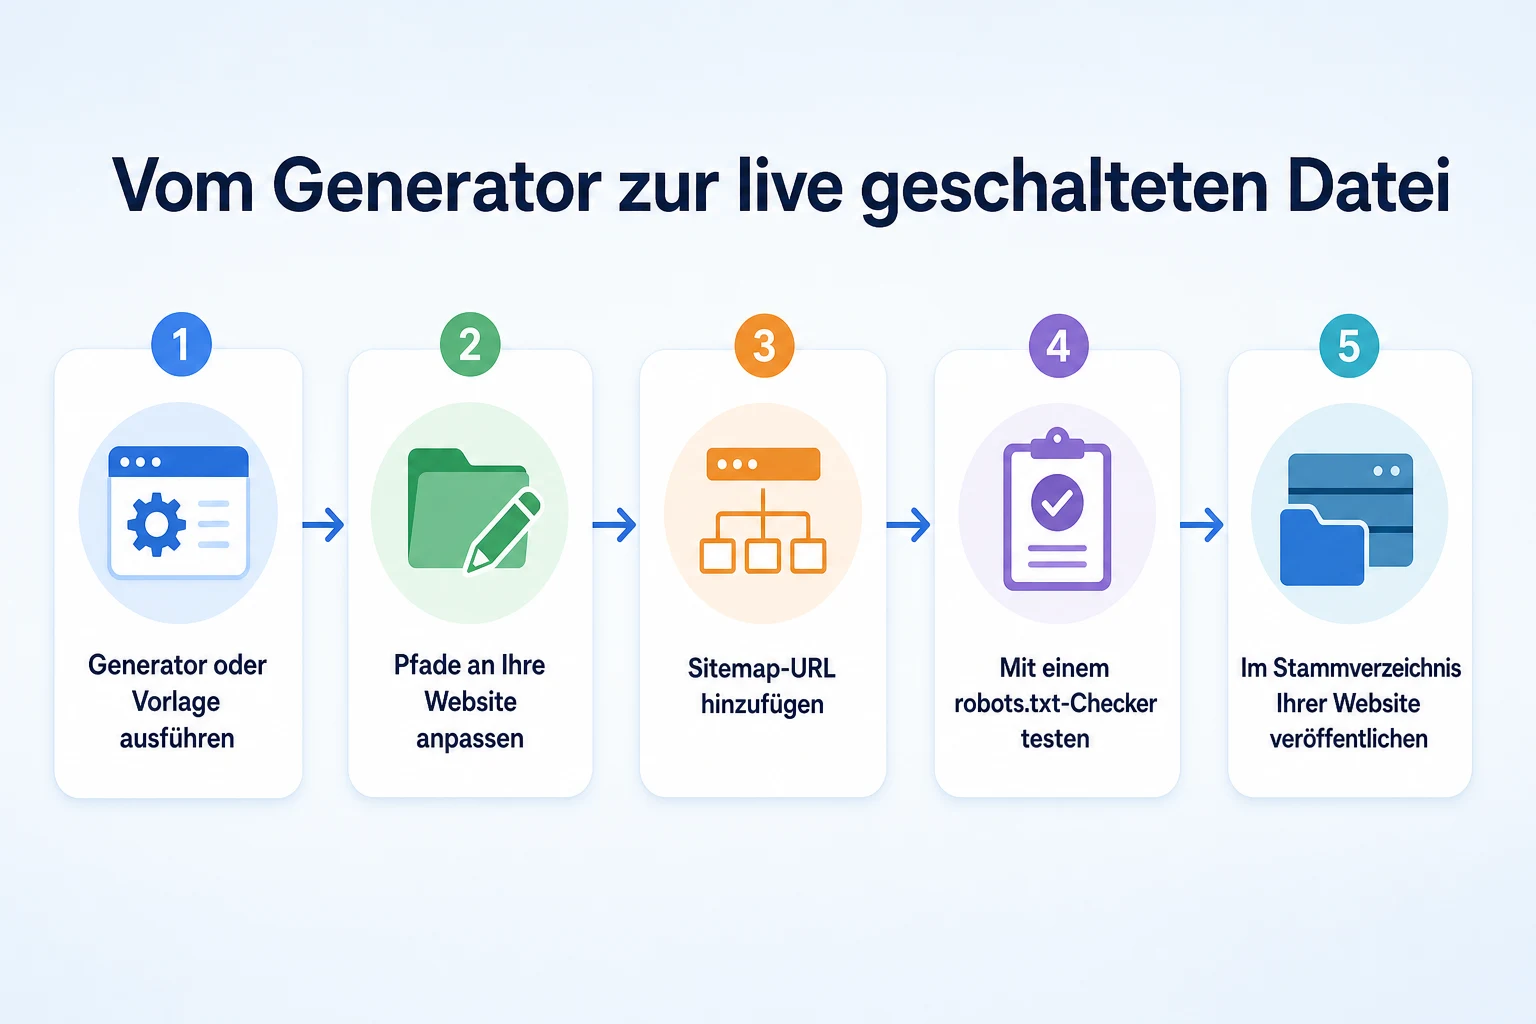
Die meisten Generatoren stellen ein paar Fragen, etwa welche Ordner gesperrt und welche Crawler genannt werden sollen, und setzen daraus mit der Standardsyntax eine Datei zusammen. Manche bieten Vorlagen für gängige Plattformen wie WordPress oder Shopify an.
Das ist wirklich nützlich, um die Syntax richtig zu bekommen. Kaum jemand erinnert sich spontan daran, ob ein abschließender Schrägstrich eine Rolle spielt oder wie Platzhalter abgeglichen werden, und ein Generator nimmt dieses Rätselraten weg.
Was ein Generator nicht leisten kann, ist zu wissen, welche Ordner auf Ihrer konkreten Website tatsächlich gesperrt werden sollten. Er kennt Ihre URL-Struktur, Ihren Anmeldepfad für Mitarbeiter oder die Bereiche Ihrer Website, die für Ihr Geschäft wichtig sind, nicht. Diese Antworten kann nur jemand liefern, der die Website kennt.
Was Sie prüfen sollten, bevor Sie der Ausgabe vertrauen
Lesen Sie jede Zeile, die der Generator erzeugt, bevor Sie veröffentlichen, statt die Ausgabe als fertig zu behandeln. Prüfen Sie, ob jeder gesperrte Pfad tatsächlich auf Ihrer Website existiert und ob er tatsächlich gesperrt werden sollte.
Achten Sie darauf, dass die Sitemap-Zeile auf Ihre echte Sitemap-Adresse verweist und nicht auf einen Platzhalter aus der Standardvorlage des Tools. Achten Sie außerdem darauf, dass nichts Ihre CSS-, JavaScript- oder Bildordner blockiert, da manche älteren Vorlagen diesen Rat noch standardmäßig weitergeben.
Wenn die Datei richtig aussieht, sollten Sie robots.txt vor Veröffentlichung testen. Der kostenlose Robots.txt-Checker von RepGet gibt ein Urteil sowohl für Suchmaschinen als auch für KI-Crawler gemeinsam aus. Damit lässt sich ein Fehler schneller finden, als wenn Sie den Rohtext Zeile für Zeile lesen.
robots.txt erstellen: Wo die Datei liegt und wie Sie sie veröffentlichen
Eine robots.txt-Datei funktioniert nur, wenn Crawler sie an dem einen Ort finden, an dem sie suchen.
Sie muss im Stammverzeichnis Ihrer Domain liegen, als reine Textdatei mit genau dem Namen robots.txt, erreichbar unter einer Adresse wie https://example.com/robots.txt. Eine Kopie in einem Unterordner oder unter einem anderen Dateinamen wird von keinem Crawler gelesen.
WordPress
WordPress erzeugt automatisch eine einfache virtuelle robots.txt-Datei, die unter der üblichen Adresse sichtbar ist, auch wenn es auf dem Server gar keine physische Datei gibt. Die meisten SEO-Plugins erlauben es, ihren Inhalt direkt im Dashboard zu bearbeiten. Das ist einfacher, als eine separate Datei über den Hosting-Zugang zu verwalten.
Wenn im Stammordner der Website bereits eine physische robots.txt-Datei existiert, hat sie in der Regel Vorrang vor der virtuellen. Prüfen Sie daher, welche Version tatsächlich ausgeliefert wird, bevor Sie annehmen, dass eine Änderung im Plugin gewirkt hat.
Shopify und andere gehostete Plattformen
Shopify und einige andere gehostete Plattformen erzeugen automatisch eine Standard-robots.txt und erlauben je nach Plattform Änderungen über eine Vorlagendatei oder eine Theme-Einstellung statt über einen direkten Upload. Die genaue Vorgehensweise hängt von der Plattform und manchmal vom Tarif ab. Schauen Sie daher in der Hilfedokumentation der Plattform nach, statt anzunehmen, dass eine Bearbeitung wie bei WordPress genauso funktioniert.
Egal welche Plattform, der Test ist immer derselbe: Rufen Sie die Live-Adresse direkt im Browser auf und lesen Sie genau, was dort veröffentlicht ist, denn nur diese Version sehen Crawler jemals.
robots.txt vor Veröffentlichung testen
Eine robots.txt-Datei kann korrekt aussehen und sich trotzdem anders verhalten, als Sie es beabsichtigt haben. Sicher wissen Sie es nur, wenn Sie die Datei testen und nicht nur lesen.
Die Datei manuell prüfen
Geben Sie zuerst die Adresse der Datei direkt in einen Browser ein, etwa unter einem Pfad wie https://example.com/robots.txt. Was dort geladen wird, sehen genau alle Crawler. Es lohnt sich deshalb, die Datei frisch zu lesen, statt der Datei zu vertrauen, von der Sie glauben, sie hochgeladen zu haben.
Prüfen Sie, ob die Sitemap-Zeile auf eine echte, funktionierende Sitemap verweist. Prüfen Sie, ob jeder gesperrte Pfad tatsächlich gesperrt werden soll und ob nichts Wichtiges versehentlich darin liegt. Wenn die Datei über ein Plugin oder eine Theme-Einstellung bearbeitet wurde, bestätigen Sie, dass die Live-Version mit dem übereinstimmt, was Sie gespeichert haben, denn eine zwischengespeicherte Kopie kann manchmal länger bestehen bleiben als erwartet.
Die Prüfung mit einem robots.txt-Checker
Die Datei zu lesen, fängt Tippfehler und offensichtliche Fehler ab. Doch damit erkennen Sie nicht immer, wie ein bestimmter Crawler sich überschneidende Regeln auslegt. Ein Checker übernimmt diese Arbeit für Sie.
Der kostenlose Robots.txt Checker von RepGet liefert ein Ergebnis für Suchmaschinen und KI-Crawler gemeinsam. So können Sie in einem Durchgang bestätigen, dass Googlebot und Bingbot dort zugelassen sind, wo Sie es erwarten, und dass jeder KI-Crawler, den Sie benannt haben, so behandelt wird, wie Sie es vorgesehen haben, ob erlaubt oder blockiert.
Führen Sie die Prüfung nach jeder Änderung an der Datei erneut aus, auch nach einer kleinen. Eine einzige Zeile, die in den falschen Block verschoben wurde, reicht aus, um alles wieder zunichtezumachen, was der Rest der Datei richtig macht.
Eine 20-Minuten-Checkliste zur Prüfung einer bestehenden robots.txt-Datei
Die meisten Websites kleiner Unternehmen haben bereits eine robots.txt-Datei, auch wenn sich niemand mehr daran erinnert, sie geschrieben zu haben. Es lohnt sich, sie in einem kurzen, fest eingeplanten Termin anzusehen, statt anzunehmen, dass sie noch das tut, wofür sie gedacht war.
Schritt | Was zu prüfen ist | Zeit |
|---|---|---|
1. Live-Datei laden | Rufen Sie die Adresse der Datei direkt auf und lesen Sie, was tatsächlich veröffentlicht ist, nicht einen gespeicherten Entwurf | 2 Minuten |
2. Nach einer pauschalen Sperre suchen | Bestätigen Sie, dass unter | 2 Minuten |
3. Jeden gesperrten Pfad prüfen | Bestätigen Sie, dass jeder gesperrte Ordner noch existiert und weiterhin gesperrt werden sollte | 5 Minuten |
4. CSS- und JavaScript-Zugriff prüfen | Bestätigen Sie, dass nichts die Ordner blockiert, die Ihre Seiten zum korrekten Anzeigen benötigen | 3 Minuten |
5. Benannte KI-Crawler-Sperren prüfen | Bestätigen Sie, dass GPTBot, ClaudeBot und PerplexityBot bewusst erlaubt oder blockiert sind und nicht aus Standardeinstellung | 3 Minuten |
6. Sitemap-Zeile bestätigen | Prüfen Sie, ob sie auf eine echte, aktuelle Sitemap-Adresse verweist | 2 Minuten |
7. Ein Checker-Tool ausführen | Bestätigen Sie, dass die Ergebnisse für jeden Crawler dem entsprechen, was Sie beabsichtigt haben | 3 Minuten |
Zwanzig Minuten reichen aus, um die Art von Fehler zu finden, der sonst monatelang unbemerkt bleibt. Setzen Sie alle paar Monate eine Erinnerung im Kalender oder jedes Mal, wenn die Website auf einen neuen Host, ein neues Theme oder eine neue Plattform umzieht, denn bei solchen Änderungen wird die Datei manchmal umgeschrieben, ohne dass jemand dies entschieden hat.
Wo RepGet hilft
Zu entscheiden, welche Ordner gesperrt werden sollten und welche KI-Crawler ein Unternehmen tatsächlich beim Lesen seiner Seiten haben möchte, ist eine Ermessensfrage. Sie liegt bei den Menschen, die die Website betreiben. Kein Tool kann diese Entscheidung an Ihrer Stelle treffen, denn sie hängt davon ab, was das Unternehmen verkauft, womit es sich wohlfühlt und wonach seine Kunden tatsächlich suchen.
Was RepGet leisten kann, ist, das Ergebnis dieser Entscheidung schneller zu prüfen. Der kostenlose Robots.txt Checker liefert ein Ergebnis für Suchmaschinen und KI-Crawler gemeinsam. So lässt sich eine von Hand bearbeitete oder von einem Generator erstellte Datei in wenigen Sekunden bestätigen, statt sie Zeile für Zeile zu lesen. Das kostenlose Website-Audit von RepGet durchsucht eine Website, vergibt einen SEO-Wert von 0 bis 100 und listet technische Probleme auf, die sich lohnen, untersucht zu werden. Dabei kann ein Problem mit der robots.txt zusammen mit anderen Punkten auftauchen, die beim gleichen Besuch behoben werden sollten. Für beides sind weder ein Konto noch eine Kreditkarte nötig.
RepGet schreibt für ein Unternehmen keine robots.txt-Datei, entscheidet nicht, welche KI-Crawler ein Unternehmen willkommen heißen sollte, und garantiert nicht, dass eine Erlaubnis für einen Crawler zu einer Erwähnung in der Antwort eines KI-Assistenten oder zu einer bestimmten Platzierung bei Google führt. Diese Ergebnisse hängen von weit mehr ab als von einer kleinen Textdatei, und niemand kann sie versprechen.
Das Fazit
Eine sichere robots.txt-Datei ist kurz und bewusst geschrieben, und jeder gesperrte Pfad hat einen klaren Grund.
Ein Generator oder eine Vorlage ist ein sinnvoller Ausgangspunkt. Das Ergebnis braucht aber trotzdem eine Durchsicht durch jemanden, der die Website kennt, eine Prüfung, ob die Sitemap-Zeile echt ist, und einen Test, bevor die Datei live geht. Dieselbe Sorgfalt gilt für KI-Crawler: Wenn Sie einem davon einen eigenen Block geben, können Sie ihn gezielt erlauben oder sperren, ohne die Regeln anzutasten, die dafür sorgen, dass Google und Bing normal crawlen.
Nichts davon garantiert ein Ranking, einen Platz in der Antwort eines KI-Assistenten oder eine bestimmte Zahl an Besuchern. Die Prüfung sorgt aber dafür, dass die Datei nicht unbemerkt gegen die Website arbeitet, die sie schützen soll.
Finden Sie zuerst heraus, was Ihre Website braucht
Bevor Sie eine neue robots.txt-Datei veröffentlichen, sehen Sie nach, was Ihre Website derzeit erlaubt und was sonst noch Aufmerksamkeit braucht. Führen Sie mit RepGet ein kostenloses Website-Audit durch, um den technischen Aufbau Ihrer Website zusammen mit ihren Inhalten zu prüfen. Es ist kein Konto und keine Kreditkarte erforderlich.
Häufige Fragen
Kann ein Robots.txt-Generator Google versehentlich blockieren?
Ja, wenn die Standardausgabe oder eine kopierte Vorlage eine pauschale Regel oder einen falsch geschriebenen Pfad enthält. Prüfen Sie immer, was ein Generator erzeugt, und testen Sie es mit einem Checker, bevor Sie die Datei auf einer Live-Website veröffentlichen.
Brauche ich eine robots.txt-Datei, wenn meine Website klein ist?
Eine kleine Website kann auch ohne auskommen, da Crawler sie standardmäßig trotzdem crawlen. Eine kurze Datei lohnt sich aber, wenn Sie einen bestimmten Ordner sperren oder Crawler auf Ihre Sitemap hinweisen möchten.
Wie blockiere ich ChatGPT am Crawlen meiner Website?
Fügen Sie Ihrer robots.txt-Datei einen Block
User-agent: GPTBotmitDisallow: /hinzu. OpenAI dokumentiert das Verhalten von GPTBot direkt. Prüfen Sie daher die aktuelle Crawler-Dokumentation, bevor Sie sich auf diese Regel verlassen.Wo soll ich meine robots.txt-Datei hochladen?
Sie muss im Stammverzeichnis Ihrer Domain liegen, als einfache Textdatei mit genau dem Namen
robots.txt, erreichbar unter einer Adresse wiehttps://example.com/robots.txt. Eine Kopie in einem Unterordner wird von Crawlern nicht gelesen.Stoppt das Blockieren von GPTBot, dass meine Website in ChatGPT-Antworten erscheint?
Das Blockieren von GPTBot verhindert, dass der Crawler von OpenAI Ihre Seiten für die dokumentierten Zwecke aufruft. Es garantiert aber nichts darüber, ob oder wie ein Unternehmen in der Antwort eines KI-Assistenten erwähnt wird.
Wie oft sollte ich meine robots.txt-Datei prüfen?
Eine kurze Prüfung alle paar Monate ist sinnvoll. Prüfen Sie außerdem erneut, wenn sich Host, Theme oder Plattform Ihrer Website ändert, denn dabei wird die Datei manchmal umgeschrieben, ohne dass jemand es entschieden hat.
Was ist der Unterschied zwischen robots.txt und einem noindex-Tag?
Robots.txt bittet Crawler, eine URL gar nicht erst aufzurufen. Ein noindex-Tag erlaubt das Crawlen, bittet Suchmaschinen aber, die Seite nicht aufzunehmen. Wenn beides auf derselben Seite steht, kann es sich gegenseitig beeinträchtigen.
Kann ich für verschiedene KI-Bots unterschiedliche robots.txt-Regeln festlegen?
Ja. Jeder Crawler kann einen eigenen Block
User-agentmit eigenen Regeln haben. So können Sie einen KI-Crawler zulassen und einen anderen blockieren, ohne Googlebot oder Bingbot überhaupt zu beeinflussen.