

Générateur robots.txt : comment créer un fichier sûr pour Google et l'IA
Réponse courte
Un fichier robots.txt sûr autorise Google, Bing et les robots IA que vous souhaitez réellement voir passer, tout en bloquant uniquement les pages que vous ne voulez pas explorer, comme les écrans d'administration ou les résultats de recherche interne. Utilisez un générateur ou un modèle comme point de départ, ne copiez jamais tel quel le fichier d'un autre site, puis testez-le avec un vérificateur robots.txt avant de le mettre en ligne. Une seule ligne erronée peut faire disparaître tout un site des résultats de recherche.
Un propriétaire de petite entreprise trouve un fichier robots.txt en ligne.
Il a l'air officiel, il vient d'un site du même secteur, et le coller semble être la démarche sûre et sérieuse.
Quelques semaines plus tard, les pages de services qui apparaissaient dans Google ont discrètement disparu.
Personne n'a touché au contenu. Personne n'a modifié les URL. Le seul changement venait de ce fichier emprunté, et une seule ligne demandait aux moteurs de recherche de tenir à l'écart le dossier exact où se trouvent ces pages.
Cela arrive plus souvent qu'il ne devrait, généralement parce qu'un générateur ou un modèle de robots.txt a été copié sans vérifier ce que fait réellement chaque ligne sur ce site précis.
Un fichier robots.txt est un petit fichier texte simple, mais aux conséquences bien réelles. Bien le configurer permet de tenir discrètement les robots d'exploration à l'écart des pages que vous ne souhaitiez de toute façon pas indexer. Mal le configurer peut masquer tout votre site, ou les assistants IA que vos clients utilisent aujourd'hui pour trouver des entreprises comme la vôtre.
Voici comment créer un générateur robots.txt sûr pour Google, Bing et les robots IA que vous souhaitez réellement voir passer, en utilisant un générateur comme point de départ plutôt que comme raccourci.
Ce que fait vraiment un fichier Robots.txt (et ce qu'il ne fait pas)
Robots.txt est un ensemble d'instructions destinées aux robots d'exploration. Il indique aux robots respectueux les parties d'un site qu'ils peuvent explorer et celles qu'ils doivent laisser de côté.
C'est là toute sa mission. Ce n'est pas un outil de sécurité, et il ne garantit pas ce qui apparaîtra dans les résultats de recherche.
Ce que robots.txt peut contrôler
Il peut demander à un robot de ne pas solliciter certaines URL ou certains dossiers. La documentation de Google sur le fonctionnement de robots.txt le décrit comme un moyen de gérer le trafic des robots d'exploration, et non comme un moyen de retirer des pages de Google.
Un fichier bien rédigé peut empêcher les robots de perdre du temps sur les écrans d'administration, les résultats de recherche interne ou les pages dupliquées à cause de paramètres, ce qui est vraiment utile sur un site plus grand.
Ce qu'il ne peut pas contrôler
Une page bloquée peut tout de même être indexée si d'autres sites y mènent. Google peut afficher l'URL dans les résultats sans description, puisqu'il n'a jamais été autorisé à explorer la page pour voir son contenu.
Robots.txt n'empêche pas non plus une personne qui possède déjà le lien de consulter la page. Ce n'est pas une protection par mot de passe, et il ne cache pas les informations sensibles à un visiteur déterminé.
Robots.txt ou la balise noindex
Si l'objectif est vraiment de retirer une page des résultats de Google, une balise meta noindex fait ce travail. Robots.txt remplit une autre fonction : il bloque l'exploration, pas forcément l'affichage dans les résultats.
Utiliser les deux ensemble échoue généralement. Si une page est bloquée dans robots.txt, Google ne peut pas l'explorer pour voir la balise noindex, de sorte que les deux instructions peuvent se contredire au lieu de se compléter.
Méthode | Ce qu'elle fait | Quand l'utiliser |
|---|---|---|
Disallow dans robots.txt | Demande aux robots de ne pas solliciter une URL ou un dossier | Pages peu utiles que vous ne voulez pas faire explorer du tout, comme les résultats de recherche interne |
Balise noindex | Autorise l'exploration, mais demande aux moteurs de recherche de ne pas afficher la page | Pages qui doivent être explorées et comprises, mais qui ne doivent pas apparaître dans les résultats |
Protection par mot de passe | Bloque tout accès tant qu'un identifiant n'est pas fourni | Contenus réellement privés ou sensibles, qui ne doivent être visibles par personne sans invitation |
Les quelques règles qu'il faut vraiment connaître
La plupart des fichiers robots.txt, même sur de grands sites, n'utilisent qu'une poignée de directives. Inutile de mémoriser une longue spécification pour en écrire un sûr.
User-agent et Disallow
User-agent indique à quel robot une règle s'applique, et Disallow indique un chemin que ce robot ne doit pas solliciter. Une ligne User-agent: * s'applique à tous les robots qui n'ont pas leur propre bloc spécifique.
Une ligne Disallow: vide signifie qu'rien n'est bloqué pour ce robot, un détail facile à manquer lorsqu'on parcourt un fichier rapidement.
Allow et caractères génériques
Allow crée une exception à l'intérieur d'un dossier bloqué plus large, ce qui est utile lorsque la plupart d'un répertoire doit rester masquée, mais qu'un fichier ou un sous-dossier doit rester accessible. Les caractères génériques, écrits *, permettent à une seule ligne de correspondre à un motif d'URL plutôt qu'à un chemin exact.
Le guide de Google sur la création d'un fichier robots.txt détaille toute la syntaxe, y compris la manière dont les règles concurrentes sont départagées lorsque plusieurs d'entre elles s'appliquent à la même URL.
Indiquer votre sitemap
Une ligne Sitemap n'est pas du tout une règle d'exploration. Elle indique simplement aux robots où trouver votre sitemap XML, ce qui facilite la découverte de vos pages.
Directive | Ce qu'elle fait | Exemple |
|---|---|---|
User-agent | Indique le robot auquel s'applique un bloc de règles |
|
Disallow | Demande au robot indiqué de ne pas solliciter un chemin |
|
Allow | Crée une exception à l'intérieur d'un chemin bloqué |
|
Sitemap | Indique aux robots l'emplacement de votre sitemap XML |
|
À quoi ressemble un robots.txt sûr pour un site de petite entreprise classique
La plupart des sites de petites entreprises n'ont pas besoin d'un fichier élaboré. Ils ont besoin d'un fichier court, qui bloque très peu et le dit clairement.
Une base de départ à adapter
Imaginez le site d'une entreprise locale de plomberie, avec des pages de services, un blog, un formulaire de contact et un écran de connexion pour le personnel. Ces URL sont fictives.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /cart/
Sitemap: https://example.com/sitemap.xml
Presque tout le site reste ouvert à l'exploration. Les seuls chemins bloqués sont une zone d'administration et une page panier, dont ni un client ni un moteur de recherche n'a besoin.
Avant de publier un fichier de ce type, vérifiez que l'adresse de votre sitemap est correcte et que le sitemap lui-même est valide. Le Sitemap Checker & Finder gratuit de RepGet peut localiser et vérifier le sitemap d'un site en quelques secondes.
Les erreurs qui bloquent Google par accident
Presque tous les fichiers robots.txt nuisibles n'ont pas été écrits pour causer des dégâts. Ils ont été rédigés pour une situation précise, puis laissés en place pour une autre.
Un blocage resté d'un site de préproduction
Les sites de développement et de préproduction contiennent souvent une règle générale comme Disallow: /, qui demande à tous les robots de rester à l'écart de tout le site. C'est logique pendant la construction d'un site.
Cela devient un problème sérieux si ce même fichier est copié sur le domaine en ligne au moment du lancement et que personne ne supprime ensuite ce blocage général.
Bloquer les dossiers où se trouvent vos CSS et vos images
Certains anciens modèles bloquent des dossiers comme /wp-includes/ ou le répertoire des ressources d'un thème, en partant du principe que les robots ne s'intéressent qu'au texte. La documentation de Google précise que bloquer les ressources dont une page a besoin pour s'afficher, comme les fichiers CSS et JavaScript, peut empêcher Google de bien comprendre la page.
Chemins sensibles à la casse et fautes de frappe
Les chemins dans robots.txt sont sensibles à la casse : Disallow: /Contact ne correspondra donc pas à une URL en /contact. Une simple faute de frappe dans un nom de dossier peut aussi rendre le blocage inutile, tandis qu'un caractère perdu ailleurs peut bloquer bien plus que prévu.
Erreur | Effet sur l'exploration | Comment la corriger |
|---|---|---|
Blocage resté de la préproduction ( | Masque tout le site en ligne aux robots d'exploration | Supprimez la règle générale dès la mise en ligne du site |
Blocage des dossiers CSS ou JavaScript | Empêche Google de rendre et de comprendre pleinement les pages | Autorisez les dossiers qui contiennent les styles et scripts nécessaires à vos pages |
Casse incorrecte ou faute de frappe dans un chemin | Bloque la mauvaise URL, ou ne bloque pas celle qui était visée | Copiez les chemins directement depuis la barre d'adresse du navigateur et vérifiez soigneusement les majuscules |
Bloquer tout le blog par accident | Retire progressivement une section entière de contenu des résultats de recherche | Vérifiez que chaque dossier bloqué est désigné avec précision et intentionnellement |
Notre checklist sur la manière de faire indexer votre site par Google mérite d'être consultée si des pages semblent manquer dans la recherche pour des raisons qui dépassent robots.txt.
Décider s'il faut autoriser ou bloquer les robots IA
En plus de Googlebot et Bingbot, un nouvel ensemble de robots d'exploration visite désormais les sites pour le compte des assistants IA. GPTBot collecte des pages pour les modèles d'OpenAI, ClaudeBot fait quelque chose de similaire pour Anthropic, et PerplexityBot explore les pages dont les réponses de Perplexity pourraient s'inspirer.
Aucun de ces robots n'est un robot d'exploration de moteur de recherche au sens traditionnel. Les autoriser ou les bloquer n'affecte pas l'apparition de votre site dans Google. Cela influe sur la possibilité pour ces entreprises d'accéder à vos pages, quel que soit l'usage qu'elles en font.
Pourquoi une entreprise pourrait bloquer un robot IA
Certaines entreprises préfèrent que leurs textes originaux, leurs tarifs et leurs photos ne servent pas à entraîner un modèle avec lequel elles n'ont aucune relation. C'est une position raisonnable, et robots.txt est la méthode documentée pour l'exprimer.
Une entreprise dont le contenu est derrière un paywall, ou dont les pages contiennent des données propriétaires qu'elle ne veut pas voir copiées, a une raison tout aussi claire de bloquer.
Pourquoi une entreprise pourrait en autoriser un
Une entreprise qui veut apparaître lorsqu'une personne demande à un assistant IA de recommander une société comme la sienne doit généralement laisser le robot concerné lire son site en premier. Si GPTBot ne peut pas accéder à vos pages de services, il y a moins de chances que ChatGPT les ait jamais vues.
Notre guide sur la façon d'être mentionné dans ChatGPT approfondit le sujet, y compris ce dont dépend (ou non) l'apparition dans une réponse d'IA.
Nom du robot | Exploité par | Ce que fait le blocage |
|---|---|---|
GPTBot | OpenAI | Empêche OpenAI d'explorer le site pour ses usages documentés, y compris l'entraînement de modèles |
ClaudeBot | Anthropic | Empêche le robot d'Anthropic d'accéder aux pages du site |
PerplexityBot | Perplexity | Empêche le robot de Perplexity d'accéder aux pages qu'il pourrait autrement utiliser dans une réponse |
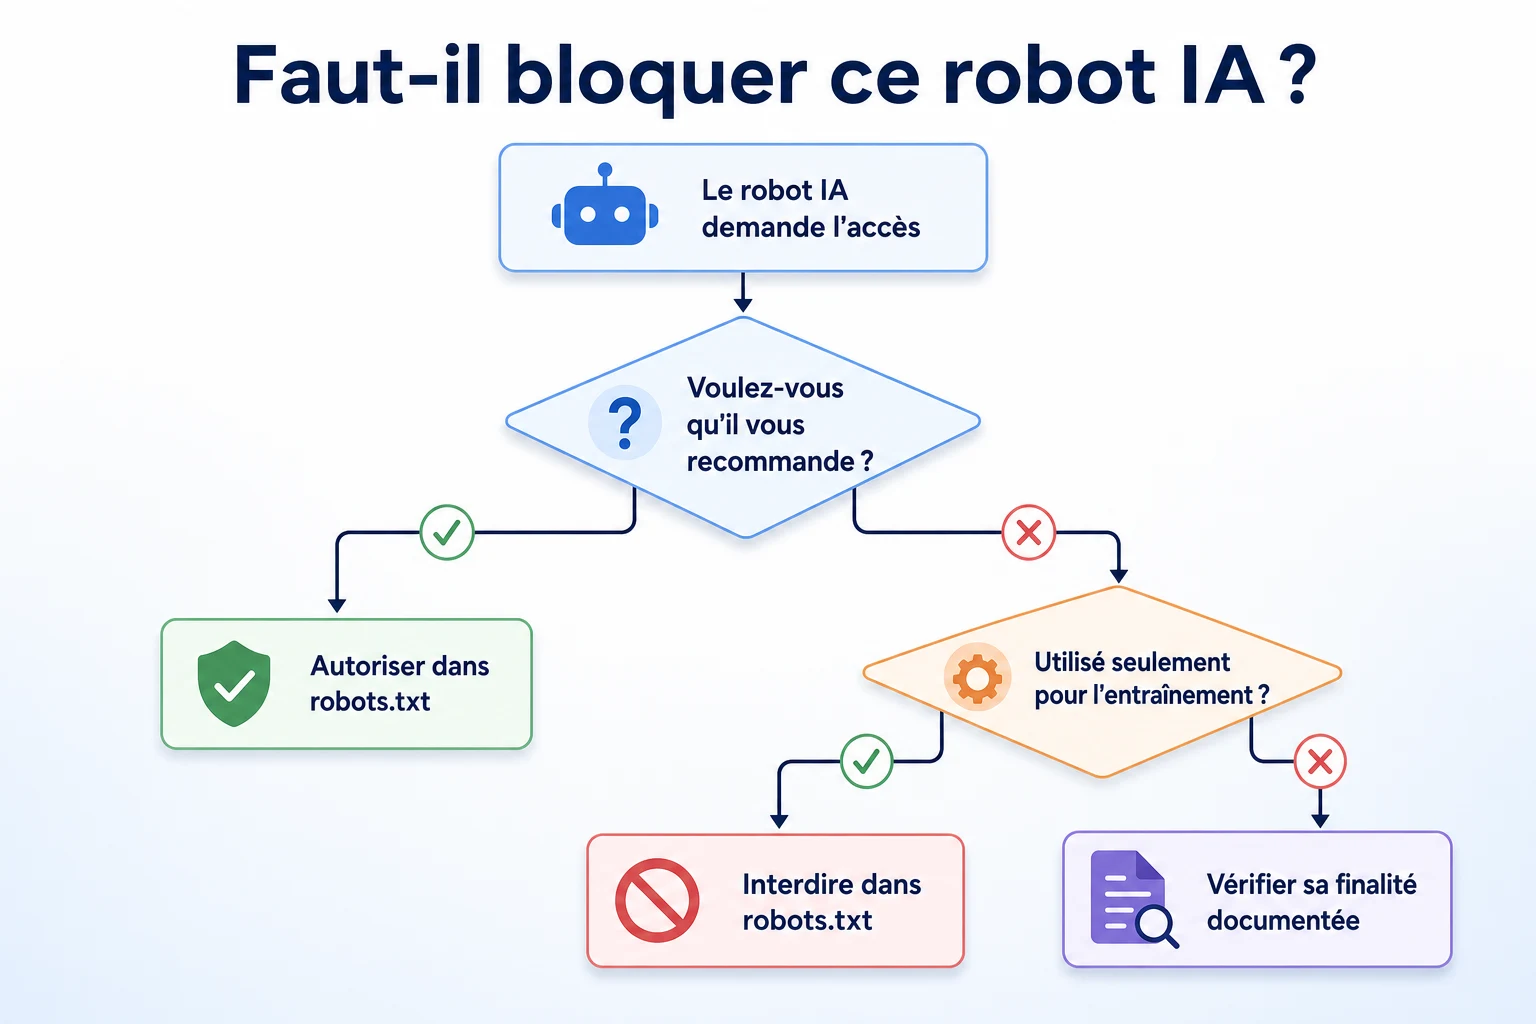
OpenAI documente le comportement de GPTBot et la façon de le contrôler dans sa documentation des robots d'exploration, qu'il vaut la peine de lire directement plutôt que de se fier à un résumé de seconde main, car les noms et les politiques des robots évoluent.
Avant de décider quoi que ce soit, il est utile de savoir ce que votre site autorise actuellement. Le Vérificateur de robots d'exploration IA gratuit de RepGet teste si GPTBot, ClaudeBot et PerplexityBot peuvent actuellement atteindre un site donné.
Écrire les règles robots.txt pour les robots IA sans bloquer Googlebot
La partie qui pose problème consiste à mélanger les règles des robots IA avec le même bloc que celui qui régit Googlebot et Bingbot. Une seule ligne mal placée peut bloquer beaucoup plus que prévu.
Chaque robot que vous voulez traiter différemment a besoin de son propre bloc User-agent. Les règles écrites sous User-agent: * s'appliquent à tout ce qui n'a pas de bloc plus spécifique, donc un robot nommé séparément ignore entièrement les règles générales et ne suit que celles écrites pour lui par son nom.
Exemple : bloquer les robots IA tout en gardant Google et Bing
Imaginez un site qui veut rester entièrement ouvert aux moteurs de recherche tout en tenant les robots IA à l'écart. Ces règles sont données à titre d'illustration.
User-agent: Googlebot
Disallow:
User-agent: Bingbot
Disallow:
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: PerplexityBot
Disallow: /
Sitemap: https://example.com/sitemap.xml
Chaque robot nommé ici ne suit que le bloc qui lui est destiné. Googlebot et Bingbot voient une ligne Disallow vide, ce qui signifie que rien n'est interdit. Les trois robots IA voient chacun Disallow: /, qui bloque tout le site pour eux spécifiquement.
Exemple : autoriser tous les robots à explorer
Une entreprise à l'aise avec la visite des robots IA n'a pas besoin de blocs séparés pour eux. Une seule section User-agent: * avec peu ou rien d'interdit couvre déjà tous les robots, nommés ou non.
User-agent: *
Disallow:
Sitemap: https://example.com/sitemap.xml
C'est le fichier le plus simple, et c'est une valeur par défaut raisonnable pour une entreprise qui ne cherche pas à exclure un robot en particulier. Ajouter des blocs nommés n'a de sens que lorsqu'il existe un robot précis que vous voulez traiter différemment des autres.
Utiliser un générateur robots.txt en toute sécurité
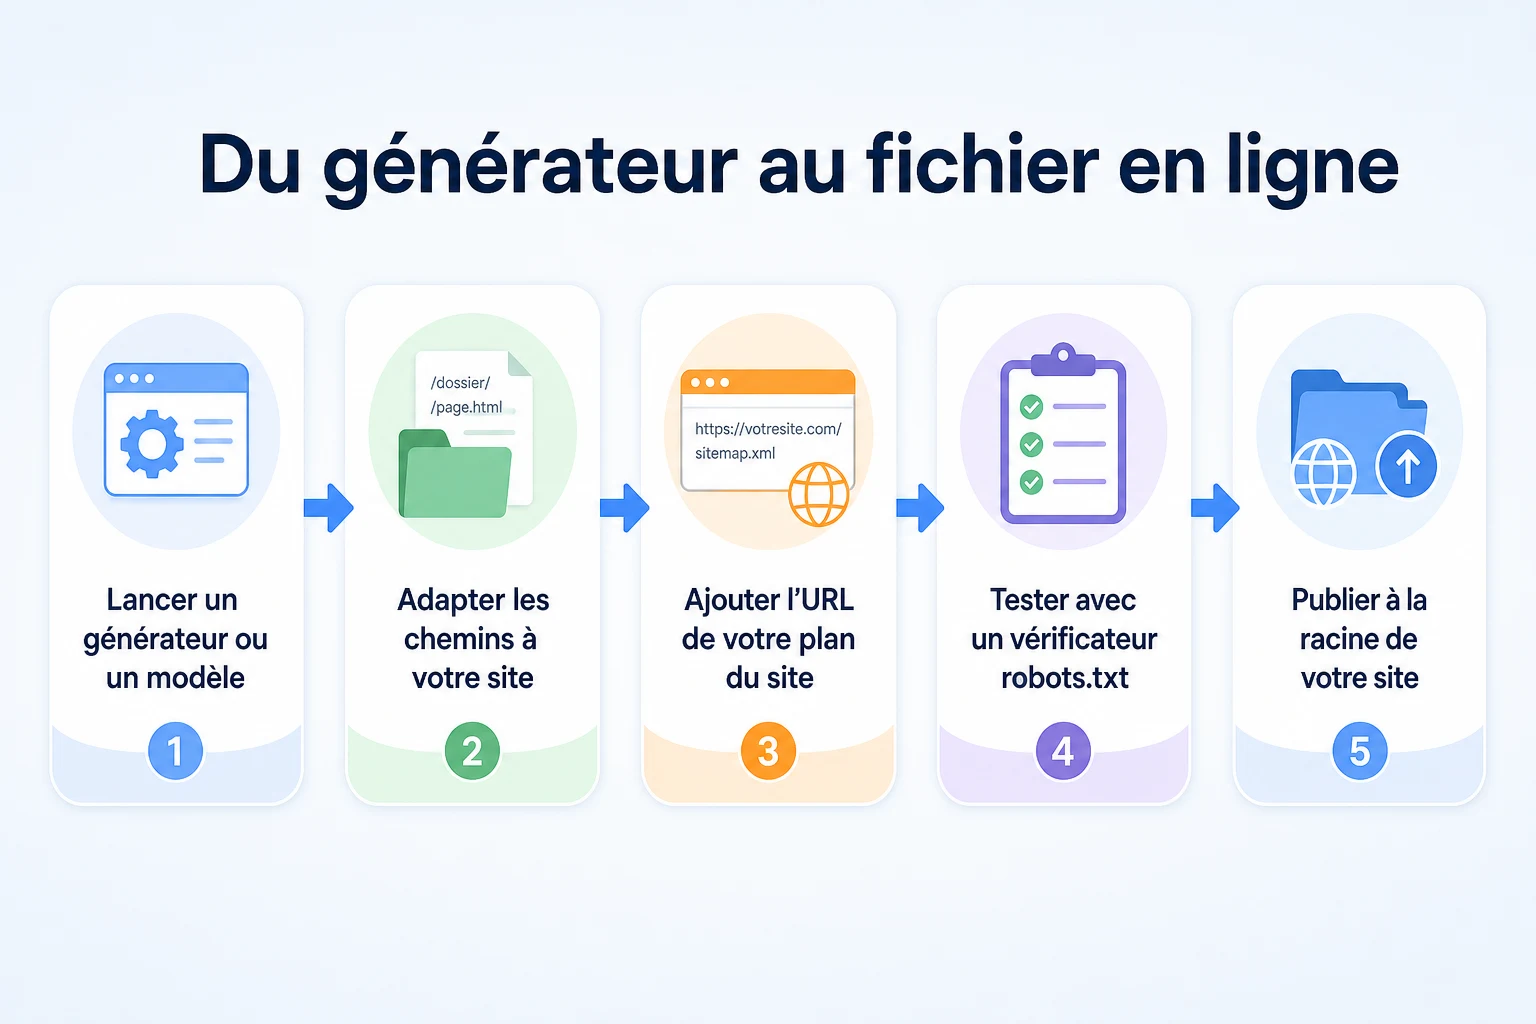
Un générateur peut faire gagner du temps, mais il vaut la peine de comprendre ce qu'il fait réellement avant de se fier à ce qu'il produit.
Ce que produit réellement un générateur
La plupart des générateurs posent quelques questions, comme les dossiers à bloquer et les robots à nommer, puis assemblent un fichier à partir de ces réponses en utilisant la syntaxe standard. Certains proposent des modèles prêts à l'emploi pour des plateformes courantes comme WordPress ou Shopify.
C'est vraiment utile pour obtenir la bonne syntaxe. Peu de gens se souviennent de tête si une barre oblique finale compte ou comment les caractères génériques sont interprétés, et un générateur supprime cette incertitude.
Ce qu'un générateur ne peut pas faire, c'est savoir quels dossiers de votre site doivent réellement être bloqués. Il ne connaît pas la structure de vos URL, le chemin de connexion de votre équipe ni les parties du site qui comptent pour votre activité. Ces réponses ne viennent que de quelqu'un qui connaît le site.
Ce qu'il faut vérifier avant de faire confiance au résultat
Lisez chaque ligne produite par le générateur avant de publier le fichier, plutôt que de considérer le résultat comme terminé. Vérifiez que chaque chemin interdit existe bien sur votre site et mérite réellement d'être bloqué.
Assurez-vous que la ligne du sitemap pointe vers l'adresse réelle de votre sitemap, et non vers un espace réservé laissé par le modèle par défaut de l'outil. Vérifiez que rien ne bloque vos dossiers CSS, JavaScript ou images, car certains anciens modèles transmettent encore ce conseil par défaut.
Une fois que le fichier semble correct, il faut tester robots.txt avant publication pour vérifier qu'il se comporte comme prévu. Le Vérificateur robots.txt gratuit de RepGet donne un verdict à la fois pour les moteurs de recherche et pour les robots IA, ce qui permet de repérer une erreur plus rapidement qu'en relisant le texte brut ligne par ligne.
Où placer le fichier et comment le publier
Un fichier robots.txt ne fonctionne que si les robots peuvent le trouver à l'endroit unique où ils sont conçus pour le chercher.
Il doit se trouver à la racine de votre domaine, sous forme de fichier texte brut nommé exactement robots.txt, accessible à une adresse telle que https://example.com/robots.txt. Une copie placée dans un sous-dossier, ou enregistrée sous un autre nom, ne sera lue par aucun robot.
WordPress
WordPress génère automatiquement un fichier robots.txt virtuel de base, visible à l'adresse habituelle même sans fichier physique sur le serveur. La plupart des extensions SEO vous permettent de modifier son contenu directement depuis le tableau de bord, ce qui est plus simple que de gérer un fichier séparé via l'accès à l'hébergement.
Si un fichier robots.txt physique existe déjà dans le dossier racine du site, il est généralement prioritaire sur la version virtuelle. Il vaut donc la peine de vérifier quelle version est réellement affichée avant de supposer qu'une modification faite par l'extension a bien été prise en compte.
Shopify et autres plateformes hébergées
Shopify et plusieurs autres plateformes hébergées génèrent automatiquement un robots.txt par défaut et, selon la plateforme, peuvent permettre des modifications via un fichier de modèle ou un paramètre de thème plutôt qu'un téléversement direct. La méthode exacte varie selon la plateforme et parfois selon le forfait. Il vaut donc la peine de consulter la documentation d'aide de la plateforme plutôt que de supposer qu'une modification à la manière de WordPress fonctionnera de la même façon.
Quelle que soit la plateforme, le test reste le même : ouvrez directement l'adresse en ligne dans un navigateur et lisez exactement ce qui y est publié, car c'est la seule version que les robots voient jamais.
Tester votre robots.txt avant publication
Un fichier robots.txt peut sembler correct tout en se comportant autrement que prévu. Le seul moyen d'en être certain est de le tester, et pas seulement de le relire.
Vérifier le fichier manuellement
Commencez par saisir directement l'adresse du fichier dans un navigateur, sous la forme https://example.com/robots.txt. Ce qui s'affiche à cette adresse est exactement ce que voit chaque robot d'exploration. Il vaut donc la peine de le lire tel qu'il est en ligne plutôt que de faire confiance au fichier que vous pensez avoir mis en ligne.
Vérifiez que la ligne du sitemap mène à un sitemap réel et fonctionnel. Vérifiez que chaque chemin bloqué est bien celui que vous vouliez bloquer, et que rien d'important ne s'y trouve par erreur. Si le fichier a été modifié via une extension ou un paramètre du thème, confirmez que la version en ligne correspond à ce que vous avez enregistré, car une copie en cache peut parfois persister plus longtemps que prévu.
Vérifier avec un outil de contrôle robots.txt
Relire le fichier permet de repérer les fautes de frappe et les erreurs évidentes, mais cela ne dit pas toujours comment un robot précis interprète des règles qui se chevauchent. Un outil de contrôle fait ce travail à votre place.
Le Robots.txt Checker gratuit de RepGet donne un verdict pour les moteurs de recherche et les robots IA à la fois. Vous pouvez ainsi confirmer en une seule étape que Googlebot et Bingbot sont autorisés là où vous l'attendez, et que tout robot IA que vous avez nommé est traité comme vous l'avez voulu, qu'il soit autorisé ou bloqué.
Relancez le contrôle après chaque modification du fichier, même minime. Une seule ligne déplacée dans le mauvais bloc suffit à annuler tout ce que le reste du fichier fait correctement.
Une liste de contrôle de 20 minutes pour réviser un fichier robots.txt existant
La plupart des sites de petites entreprises ont déjà un fichier robots.txt, même si personne ne se souvient de l'avoir rédigé. Il vaut la peine d'y jeter un coup d'œil court et planifié, plutôt que de supposer qu'il fait toujours ce pour quoi il a été conçu.
Étape | Ce qu'il faut vérifier | Durée |
|---|---|---|
1. Charger le fichier en ligne | Visitez directement l'adresse du fichier et lisez ce qui est réellement publié, pas un brouillon enregistré | 2 minutes |
2. Repérer un blocage général | Confirmez qu'il ne reste aucun | 2 minutes |
3. Vérifier chaque chemin bloqué | Confirmez que chaque dossier bloqué existe toujours et mérite encore d'être bloqué | 5 minutes |
4. Vérifier l'accès au CSS et au JavaScript | Confirmez que rien ne bloque les dossiers nécessaires au bon affichage de vos pages | 3 minutes |
5. Examiner les blocages des robots IA nommés | Confirmez que GPTBot, ClaudeBot et PerplexityBot sont autorisés ou bloqués volontairement, et non par défaut | 3 minutes |
6. Confirmer la ligne du sitemap | Vérifiez qu'elle pointe vers une adresse de sitemap réelle et à jour | 2 minutes |
7. Lancer un outil de contrôle | Confirmez que les verdicts correspondent à ce que vous voulez pour chaque robot | 3 minutes |
Vingt minutes suffisent pour repérer le type d'erreur qui resterait inaperçu pendant des mois. Programmez un rappel tous les quelques mois, ou chaque fois que le site change d'hébergeur, de thème ou de plateforme, car ces changements réécrivent parfois le fichier sans que personne ne l'ait décidé.
Où se situe RepGet
Décider quels dossiers méritent d'être bloqués, et quels robots IA une entreprise souhaite réellement voir lire ses pages, relève d'un jugement qui appartient aux personnes qui gèrent le site. Aucun outil ne peut prendre cette décision à votre place, car elle dépend de ce que l'entreprise vend, de ce avec quoi elle est à l'aise et de ce que ses clients recherchent réellement.
Ce que RepGet peut faire, c'est vous permettre de vérifier plus vite le résultat de cette décision. Son Robots.txt Checker gratuit donne un verdict pour les moteurs de recherche et les robots IA à la fois. Un fichier modifié à la main ou produit par un générateur peut ainsi être confirmé en quelques secondes, au lieu d'être relu ligne par ligne. Son audit de site web gratuit explore un site, lui attribue un score SEO de 0 à 100 et liste les problèmes techniques à examiner. Il peut faire remonter un problème de robots.txt avec d'autres points à corriger lors de la même visite. Aucun compte ni carte bancaire n'est requis pour l'un ou l'autre.
RepGet ne rédige pas le fichier robots.txt d'une entreprise à sa place, ne décide pas quels robots IA une entreprise devrait accueillir, et ne garantit pas qu'autoriser un robot mène à une mention dans la réponse d'un assistant IA ou à une position particulière sur Google. Ces résultats dépendent de bien plus qu'un petit fichier texte, et personne ne peut les promettre.
En résumé
Un fichier robots.txt sûr est un fichier court, écrit à dessein, où chaque chemin bloqué a une raison claire.
Un générateur ou un modèle est un bon point de départ, mais le résultat doit encore être relu par quelqu'un qui connaît le site, vérifié pour s'assurer que la ligne du sitemap est réelle, et testé avant publication. La même rigueur s'applique aux robots IA : nommer un robot dans son propre bloc permet de l'autoriser ou de le bloquer délibérément, sans toucher aux règles qui permettent à Google et Bing d'explorer normalement.
Rien de tout cela ne garantit un classement, une place dans la réponse d'un assistant IA ou un volume de trafic donné. Ce que cela permet, c'est de s'assurer que le fichier ne travaille pas discrètement contre le site qu'il est censé protéger.
Découvrez d'abord ce dont votre site a besoin
Avant de publier un nouveau fichier robots.txt, voyez ce que votre site autorise actuellement et ce qui pourrait encore demander de l'attention. Lancez un audit gratuit de votre site avec RepGet pour vérifier la configuration technique de votre site en même temps que son contenu. Aucun compte ni carte bancaire n'est requis.
Questions fréquentes
Un générateur de robots.txt peut-il bloquer Google par accident ?
Oui, si son résultat par défaut ou un modèle copié contient une règle globale ou un chemin mal saisi. Relisez toujours ce que produit un générateur et testez-le avec un vérificateur avant de le publier sur un site en ligne.
Ai-je besoin d'un fichier robots.txt si mon site est petit ?
Un petit site peut fonctionner sans, car les robots l'exploreront quand même par défaut. Un fichier court reste utile si vous voulez bloquer un dossier précis ou indiquer aux robots l'emplacement de votre plan du site.
Comment empêcher ChatGPT d'explorer mon site ?
Ajoutez un bloc
User-agent: GPTBotavecDisallow: /à votre fichier robots.txt. OpenAI documente directement le comportement de GPTBot, il est donc utile de consulter sa documentation actuelle sur ses robots avant de vous appuyer sur cette règle.Où placer mon fichier robots.txt ?
Il doit se trouver à la racine de votre domaine, sous forme de texte brut nommé exactement
robots.txt, accessible à une adresse commehttps://example.com/robots.txt. Une copie placée dans un sous-dossier ne sera pas lue par les robots.Bloquer GPTBot empêche-t-il mon site d'apparaître dans les réponses de ChatGPT ?
Bloquer GPTBot empêche le robot d'OpenAI d'accéder à vos pages pour les usages qu'il documente. Cela ne garantit rien quant à la manière dont une entreprise est mentionnée, ou non, dans les réponses d'un assistant IA.
À quelle fréquence dois-je vérifier mon fichier robots.txt ?
Une relecture rapide tous les quelques mois est raisonnable, et il est utile de la refaire à chaque changement d'hébergeur, de thème ou de plateforme, car ces changements réécrivent parfois le fichier sans que personne ne l'ait décidé.
Quelle est la différence entre robots.txt et une balise noindex ?
Robots.txt demande aux robots de ne pas demander une URL du tout. Une balise noindex autorise l'exploration, mais demande aux moteurs de recherche de ne pas afficher la page. Utiliser les deux sur une même page peut produire des effets contraires.
Puis-je avoir des règles robots.txt différentes pour chaque robot IA ?
Oui. Chaque robot peut avoir son propre bloc
User-agentavec ses propres règles, vous pouvez donc autoriser un robot IA tout en en bloquant un autre, sans affecter du tout Googlebot ou Bingbot.