

Generador de robots.txt: cómo crear un archivo seguro para Google y la IA
Respuesta corta
Un archivo robots.txt seguro permite el acceso a Google, Bing y a los rastreadores de IA que sí quieres que visiten tu sitio, y bloquea solo las páginas que realmente no quieres que se rastreen, como las pantallas de administración o los resultados de búsqueda internos. Usa un generador o una plantilla como punto de partida, nunca copies tal cual el archivo de otro sitio y, antes de publicarlo, pruébalo con un verificador de robots.txt. Una línea mal escrita puede ocultar un sitio entero de los buscadores.
Un propietario de un pequeño negocio encuentra un archivo robots.txt en internet.
Tiene aspecto oficial, procede de un sitio de un sector parecido y pegarlo parece lo más seguro y completo que puede hacer.
Unas semanas después, las páginas de servicios que antes aparecían en Google han desaparecido sin hacer ruido.
Nadie tocó el contenido. Nadie cambió las URL. Lo único que cambió fue ese archivo prestado, y una de sus líneas le indicaba a los buscadores que se mantuvieran alejados de la carpeta exacta donde están esas páginas.
Esto ocurre con más frecuencia de la que debería, normalmente porque se copia un generador o una plantilla de robots.txt sin comprobar qué hace realmente cada línea en este sitio concreto.
Un archivo robots.txt es un archivo de texto pequeño y sencillo, pero con consecuencias reales. Si está bien hecho, mantiene discretamente a los rastreadores fuera de las páginas que nunca quisiste indexar. Si está mal hecho, puede ocultar todo tu sitio o a los asistentes de IA que tus clientes ahora usan para encontrar negocios como el tuyo.
Aquí tienes cómo crear uno seguro para Google, Bing y los rastreadores de IA que sí quieres que visiten tu sitio, usando un generador de robots.txt como punto de partida y no como atajo.
Qué hace realmente un archivo robots.txt (y qué no hace)
Robots.txt es un conjunto de instrucciones para los rastreadores. Indica a los bots bien comportados qué partes de un sitio pueden rastrear y cuáles deben dejar en paz.
Esa es toda su función. No es una herramienta de seguridad ni garantiza lo que aparece en los resultados de búsqueda.
Lo que robots.txt sí puede controlar
Puede indicar a un rastreador que no solicite determinadas URL o carpetas. La documentación de Google sobre cómo funciona robots.txt lo describe como una forma de gestionar el tráfico de los rastreadores, no como una manera de mantener las páginas fuera de Google por completo.
Un archivo bien escrito puede evitar que los rastreadores pierdan tiempo en pantallas de administración, resultados de búsqueda internos o páginas duplicadas con parámetros, algo realmente útil en un sitio grande.
Lo que no puede controlar
Una página bloqueada puede seguir indexándose si otros sitios enlazan a ella. Google puede mostrar la URL en los resultados sin descripción, porque nunca se le permitió rastrear la página para ver su contenido.
Robots.txt tampoco impide que alguien que ya tiene el enlace vea la página. No es una protección con contraseña y no oculta información sensible a un visitante decidido.
Robots.txt frente a la etiqueta noindex
Si el objetivo es sacar de verdad una página de los resultados de Google, una etiqueta meta noindex cumple esa función. Robots.txt cumple otra: detiene el rastreo, no necesariamente el listado.
Usar ambas juntas suele salir mal. Si una página está bloqueada en robots.txt, Google no puede rastrearla para ver primero la etiqueta noindex, así que las dos instrucciones pueden contradecirse en lugar de complementarse.
Método | Qué hace | Cuándo usarlo |
|---|---|---|
Disallow en robots.txt | Pide a los rastreadores que no soliciten una URL o carpeta | Páginas de poco valor que no quieres que se rastreen, como los resultados de búsqueda internos |
Etiqueta noindex | Permite el rastreo, pero pide a los buscadores que no listen la página | Páginas que deben rastrearse y comprenderse, pero que no deberían aparecer en los resultados |
Protección con contraseña | Bloquea el acceso por completo hasta que se introduce un inicio de sesión | Contenido realmente privado o sensible que no debe ser visible para nadie sin invitación |
Las pocas reglas que realmente necesitas conocer
La mayoría de los archivos robots.txt, incluso en sitios grandes, usan solo unas pocas directivas. No necesitas memorizar una especificación extensa para escribir uno seguro.
User-agent y Disallow
User-agent indica a qué rastreador se aplica una regla, y Disallow indica una ruta que ese rastreador no debe solicitar. Una línea que diga User-agent: * se aplica a todos los rastreadores que no tengan un bloque específico propio.
Una línea Disallow: vacía significa que no se bloquea nada para ese rastreador, algo fácil de pasar por alto al revisar un archivo deprisa.
Allow y comodines
Allow crea una excepción dentro de una carpeta bloqueada más amplia, lo cual resulta útil cuando la mayor parte de un directorio debe permanecer oculta, pero un archivo o subcarpeta concreta no. Los comodines, escritos como *, permiten que una sola línea coincida con un patrón de URL en lugar de una ruta exacta.
La guía de Google para crear un archivo robots.txt explica la sintaxis completa, incluido cómo se resuelven las reglas coincidentes cuando más de una se aplica a la misma URL.
Indicar tu sitemap
Una línea Sitemap no es una regla de rastreo. Simplemente indica a los rastreadores dónde encontrar tu sitemap XML, lo que facilita que descubran tus páginas.
Directiva | Qué hace | Ejemplo |
|---|---|---|
User-agent | Indica el rastreador al que se aplica un bloque de reglas |
|
Disallow | Pide al rastreador indicado que no solicite una ruta |
|
Allow | Crea una excepción dentro de una ruta bloqueada |
|
Sitemap | Indica a los rastreadores la ubicación de tu sitemap XML |
|
Ejemplos de sintaxis de robots.txt para un sitio típico de pequeño negocio
La mayoría de los sitios de pequeños negocios no necesitan un archivo elaborado. Necesitan uno corto que bloquee muy poco y lo deje claro.
Un archivo base para empezar y ajustar
Imagina el sitio web de una empresa local de fontanería, con páginas de servicios, un blog, un formulario de contacto y una pantalla de acceso para el personal. Estas URL son ilustrativas.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /cart/
Sitemap: https://example.com/sitemap.xml
Casi todo el sitio sigue abierto al rastreo. Las únicas rutas bloqueadas son un área de administración y una página de carrito, y ni el cliente ni el buscador necesitan encontrarlas.
Antes de publicar un archivo como este, conviene probar robots.txt y confirmar que la dirección de tu sitemap es correcta y que el sitemap es válido. El Sitemap Checker & Finder gratuito de RepGet puede localizar y comprobar el sitemap de un sitio en pocos segundos.
Los errores que bloquean a Google sin querer
Casi todos los archivos robots.txt perjudiciales no se escribieron para causar daño. Se escribieron para una situación y luego se dejaron para otra.
Un bloqueo sobrante de un sitio de pruebas
Los sitios de desarrollo y de pruebas suelen tener una regla general como Disallow: /, que indica a todos los rastreadores que se alejen de todo el sitio. Eso tiene sentido mientras el sitio se construye.
Es un problema serio si ese mismo archivo se copia al dominio real durante el lanzamiento y nadie elimina después el bloqueo general.
Bloquear las carpetas donde están tus CSS e imágenes
Algunas plantillas antiguas bloquean carpetas como /wp-includes/ o el directorio de recursos de un tema, suponiendo que los rastreadores solo se preocupan por el texto. La documentación de Google deja claro que bloquear recursos que una página necesita para mostrarse, como los archivos CSS y JavaScript, puede impedir que Google entienda bien la página.
Rutas sensibles a mayúsculas y erratas
Las rutas en robots.txt distinguen entre mayúsculas y minúsculas, así que Disallow: /Contact no coincidirá con una URL en /contact. Una simple errata en el nombre de una carpeta también puede hacer que el bloqueo no sirva para nada, mientras que un carácter suelto en otro lugar puede bloquear mucho más de lo previsto.
Error | Qué provoca en el rastreo | Cómo solucionarlo |
|---|---|---|
Bloqueo sobrante del sitio de pruebas ( | Oculta todo el sitio real a los rastreadores | Elimina la regla general en cuanto el sitio esté en línea |
Bloquear carpetas de CSS o JavaScript | Impide que Google renderice y entienda bien las páginas | Permite las carpetas que contienen los estilos y scripts que tus páginas necesitan |
Mayúsculas incorrectas o erratas en una ruta | Bloquea la URL equivocada, o no bloquea la que se pretendía | Copia las rutas directamente de la barra de direcciones del navegador y revisa con cuidado las mayúsculas |
Bloquear todo el blog por accidente | Elimina con el tiempo una sección completa de contenido de los resultados de búsqueda | Comprueba que cada carpeta bloqueada esté nombrada con precisión y de forma intencionada |
Nuestra lista de comprobación sobre cómo hacer que Google indexe tu sitio web merece una revisión si hay páginas que parecen faltar en la búsqueda por motivos que van más allá de robots.txt.
Decidir si permitir o bloquear los rastreadores de IA
Junto a Googlebot y Bingbot, ahora visita los sitios un nuevo grupo de rastreadores que trabaja en nombre de los asistentes de IA. GPTBot recopila páginas para los modelos de OpenAI, ClaudeBot hace algo similar para Anthropic y PerplexityBot rastrea las páginas de las que podrían nutrirse las respuestas de Perplexity.
Ninguno de estos es un rastreador de buscadores en el sentido tradicional. Permitirlos o bloquearlos no afecta a si su sitio aparece en Google. Lo que sí afecta es si estas empresas pueden acceder a sus páginas, sea cual sea el uso que hagan de ese acceso.
Por qué un negocio podría bloquear un rastreador de IA
Algunas empresas prefieren que sus textos originales, precios y fotografías no se usen para entrenar un modelo con el que no tienen ninguna relación. Es una postura razonable, y robots.txt es la forma documentada de expresarla.
Un negocio con contenido de pago, o con páginas llenas de datos propios que no quiere que se copien, tiene un motivo igual de claro para bloquear.
Por qué un negocio podría permitir uno
Un negocio que quiere aparecer cuando alguien pide a un asistente de IA que recomiende una empresa como la suya necesita, en general, dejar que el rastreador correspondiente lea su sitio primero. Si GPTBot no puede acceder a sus páginas de servicios, hay menos probabilidades de que ChatGPT las haya visto siquiera.
Nuestra guía sobre cómo aparecer mencionado en ChatGPT profundiza en esto, incluyendo de qué depende y de qué no depende aparecer en una respuesta de IA.
Nombre del rastreador | Operado por | Qué hace el bloqueo |
|---|---|---|
GPTBot | OpenAI | Impide que OpenAI rastree el sitio para sus fines documentados, incluido el entrenamiento de modelos |
ClaudeBot | Anthropic | Impide que el rastreador de Anthropic acceda a las páginas del sitio |
PerplexityBot | Perplexity | Impide que el rastreador de Perplexity acceda a las páginas que podría usar en una respuesta |
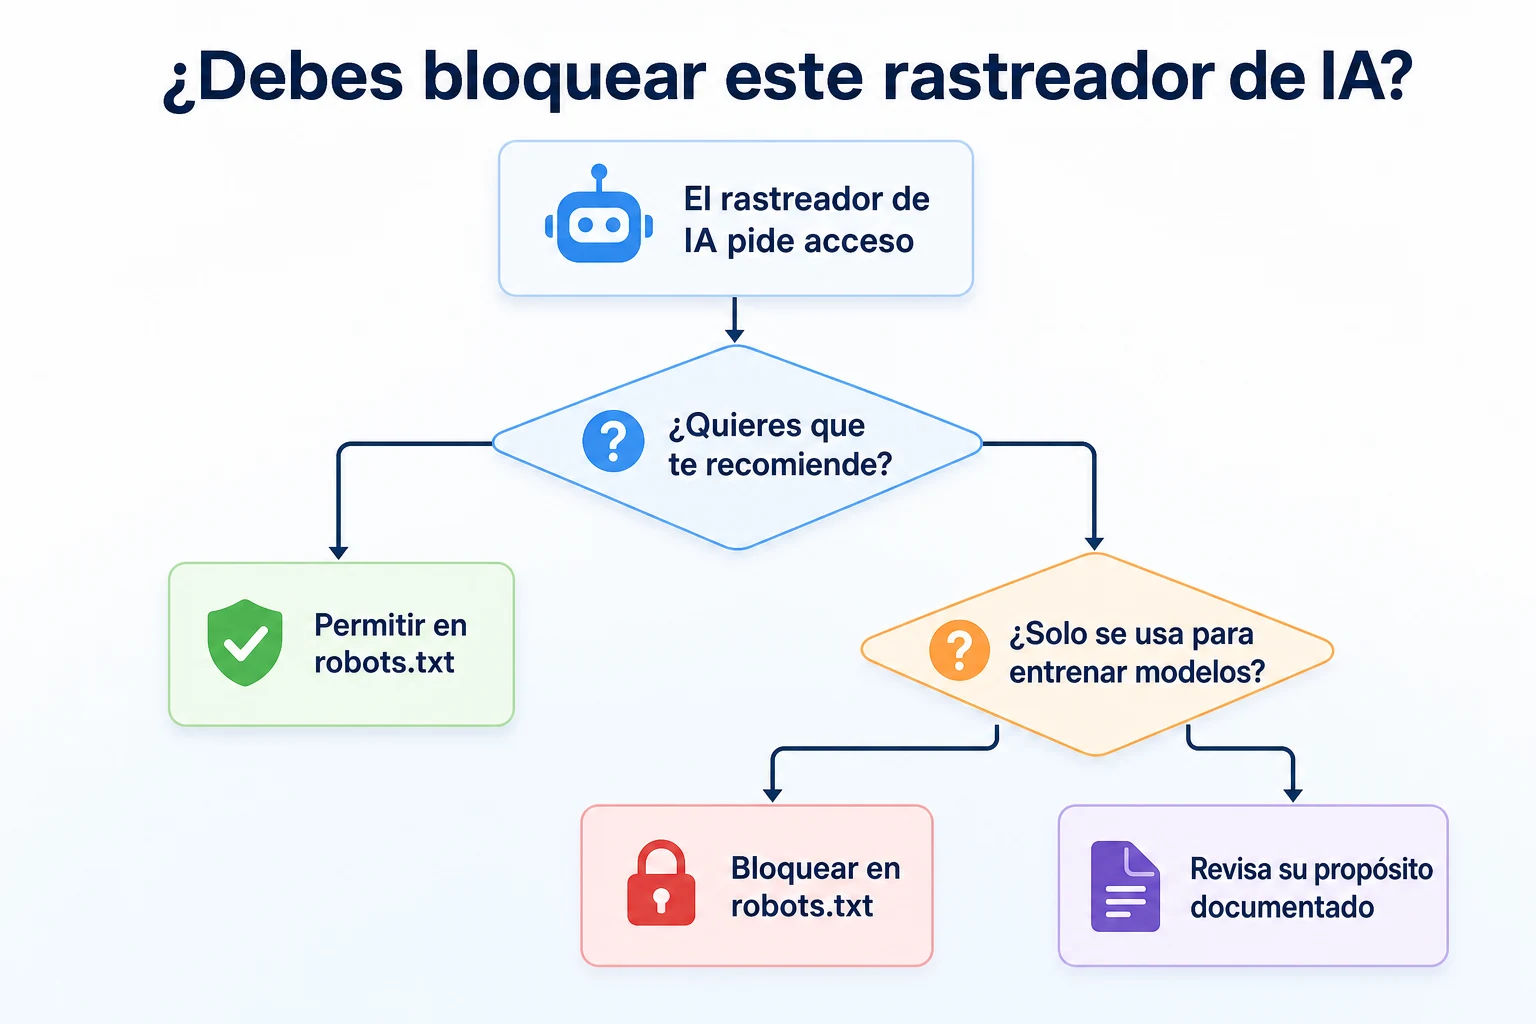
OpenAI documenta el comportamiento de GPTBot y cómo controlarlo en su documentación de rastreadores, que conviene leer directamente en lugar de depender de un resumen de segunda mano, ya que los nombres y las políticas de los rastreadores sí cambian.
Antes de decidir nada, conviene saber qué permite su sitio en este momento. La AI Crawler Checker gratuita de RepGet comprueba si GPTBot, ClaudeBot y PerplexityBot pueden llegar actualmente a un sitio determinado.
Ejemplos de sintaxis de robots.txt para rastreadores de IA sin bloquear buscadores
El problema que más confunde a la gente es mezclar las reglas de los rastreadores de IA en el mismo bloque que rige a Googlebot y Bingbot. Una sola línea mal colocada puede acabar bloqueando mucho más de lo que se pretendía.
Cada rastreador que quiera tratar de forma distinta necesita su propio bloque User-agent. Las reglas escritas bajo User-agent: * se aplican a cualquier rastreador que no tenga un bloque más específico, así que un rastreador nombrado por separado ignora por completo las reglas generales y solo sigue las que se han escrito para él por su nombre.
Ejemplo: bloquear rastreadores de IA en robots.txt y permitir Google y Bing
Imagine un sitio que quiere seguir totalmente abierto a los buscadores mientras mantiene fuera a los rastreadores de IA. Estas reglas son ilustrativas.
User-agent: Googlebot
Disallow:
User-agent: Bingbot
Disallow:
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: PerplexityBot
Disallow: /
Sitemap: https://example.com/sitemap.xml
Cada rastreador nombrado aquí solo sigue el bloque que se escribió para él. Googlebot y Bingbot ven una línea de disallow vacía, lo que significa que no hay nada prohibido. Los tres rastreadores de IA ven Disallow: /, lo que bloquea todo el sitio solo para ellos.
Ejemplo: permitir que todo rastree el sitio
Un negocio que se siente cómodo con la visita de rastreadores de IA no necesita bloques separados para ellos. Una única sección User-agent: * con poco o nada prohibido ya cubre a todos los rastreadores, nombrados o no.
User-agent: *
Disallow:
Sitemap: https://example.com/sitemap.xml
Es el archivo más sencillo y un punto de partida razonable para un negocio que no intenta excluir a ningún rastreador en particular. Añadir bloques con nombre solo tiene sentido cuando hay un rastreador concreto que realmente quiere tratar de forma distinta al resto.
Cómo usar un generador de robots.txt de forma segura
Un generador puede ahorrar tiempo, pero conviene entender qué hace antes de fiarse de lo que devuelve.
Qué produce realmente un generador
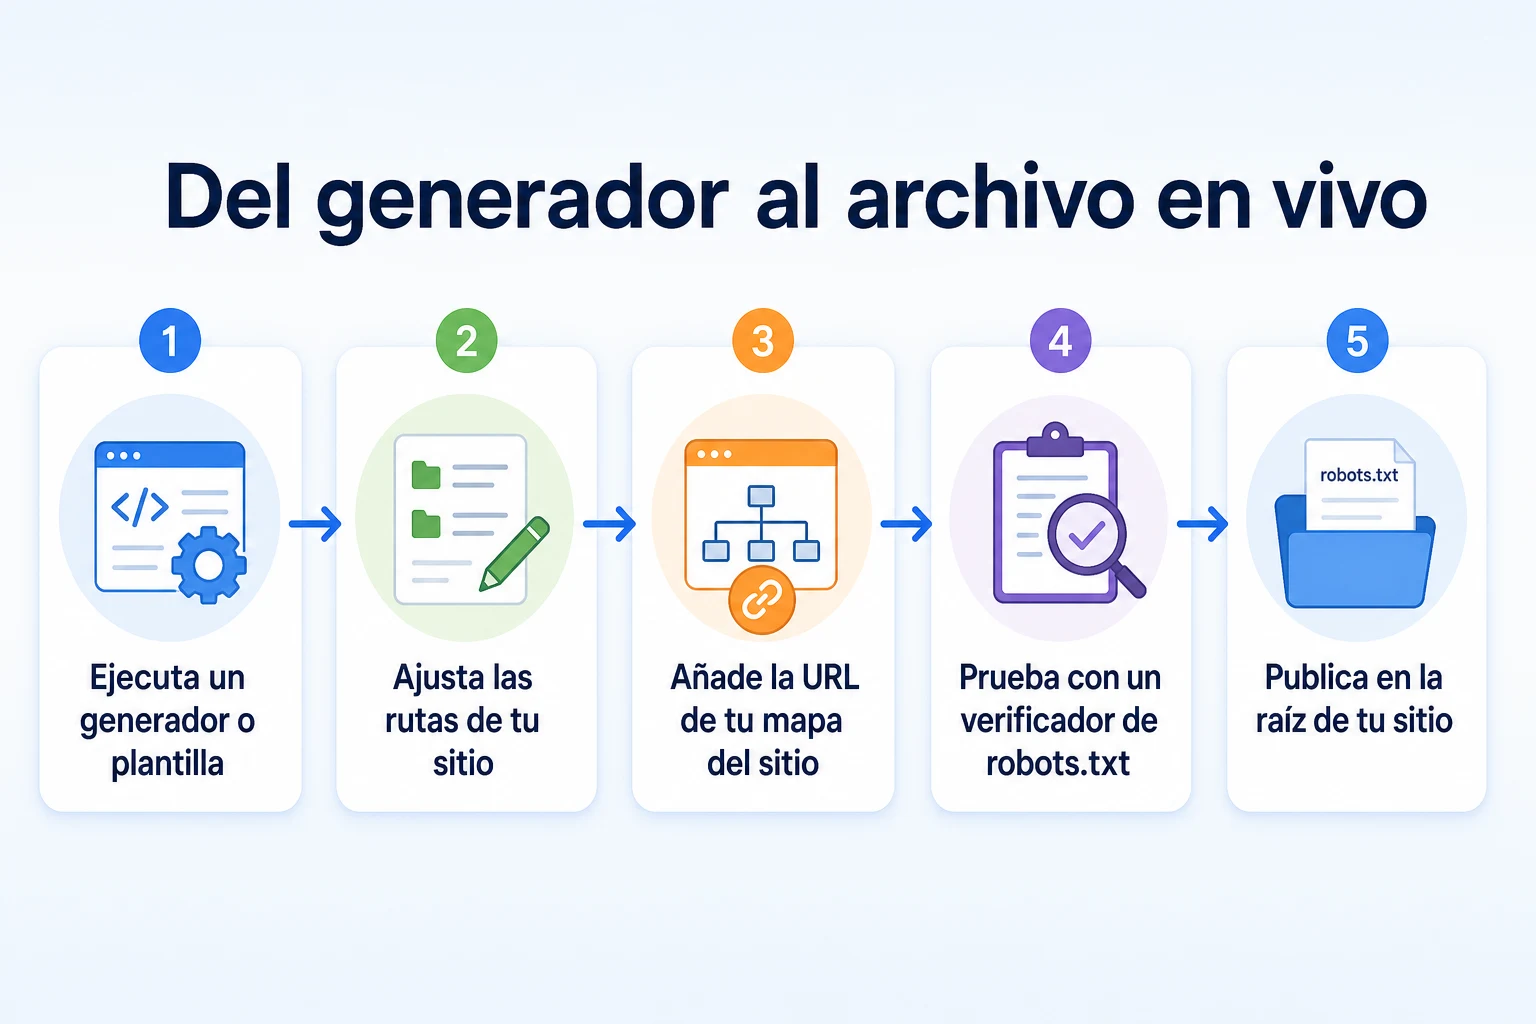
La mayoría de los generadores hacen unas pocas preguntas, como qué carpetas bloquear y qué rastreadores nombrar, y después montan un archivo con esas respuestas usando sintaxis estándar. Algunos ofrecen plantillas predefinidas para plataformas habituales como WordPress o Shopify.
Eso es realmente útil para acertar con la sintaxis. Pocas personas recuerdan de memoria si importa la barra final o cómo se comparan los comodines, y un generador elimina esas dudas.
Lo que un generador no puede hacer es saber qué carpetas de su sitio concreto deberían bloquearse. No conoce su estructura de URL, la ruta de acceso de su personal ni qué partes del sitio importan para su negocio. Esas respuestas solo las puede dar alguien que conozca el sitio.
Qué revisar antes de fiarse del resultado
Lea cada línea que produce el generador antes de publicarla, en lugar de tratar el resultado como algo terminado. Confirme que cada ruta bloqueada existe realmente en su sitio y que realmente merece estar bloqueada.
Compruebe que la línea del sitemap apunta a la dirección real de su sitemap y no a un marcador de posición que quedó de la plantilla por defecto de la herramienta. Compruebe también que nada bloquea sus carpetas de CSS, JavaScript o imágenes, ya que algunas plantillas antiguas siguen arrastrando ese consejo por defecto.
Cuando el archivo tenga buena pinta, confirme que se comporta como espera antes de publicarlo. El Robots.txt Checker gratuito de RepGet ofrece un veredicto para buscadores y rastreadores de IA a la vez, lo que permite detectar un error más rápido que leer el texto línea por línea. Es una forma sencilla de probar robots.txt antes de publicar.
Dónde colocar el archivo y cómo publicarlo
Un archivo robots.txt solo funciona si los rastreadores pueden encontrarlo en el único lugar donde están diseñados para buscarlo.
Debe estar en la raíz de su dominio, como un archivo de texto plano llamado exactamente robots.txt, accesible en una dirección como https://example.com/robots.txt. Una copia guardada en una subcarpeta, o con otro nombre de archivo, no la leerá ningún rastreador.
WordPress
WordPress genera automáticamente un archivo robots.txt virtual básico, visible en la dirección habitual incluso sin un archivo físico en el servidor. La mayoría de los plugins de SEO le permiten editar su contenido directamente desde el panel, lo que es más sencillo que gestionar un archivo aparte mediante el acceso al alojamiento.
Si ya existe un archivo robots.txt físico en la carpeta raíz del sitio, normalmente tiene prioridad sobre el virtual, así que conviene comprobar qué versión se está sirviendo realmente antes de dar por hecho que un cambio en el plugin ha surtido efecto.
Shopify y otras plataformas alojadas
Shopify y otras plataformas alojadas generan automáticamente un robots.txt por defecto y, según la plataforma, pueden permitir cambios mediante un archivo de plantilla o un ajuste del tema en lugar de una subida directa. El método exacto varía según la plataforma y, a veces, según el plan, así que conviene consultar la documentación de ayuda de la plataforma en lugar de suponer que una edición al estilo de WordPress funcionará igual.
En cualquier plataforma la prueba es la misma: visite la dirección en vivo directamente en un navegador y lea exactamente lo que está publicado allí, ya que es la única versión que los rastreadores llegan a ver.
Cómo probar tu robots.txt antes de publicarlo
Un archivo robots.txt puede parecer correcto y, aun así, comportarse de una forma que no pretendías. La única manera de estar seguro es probarlo, no solo leerlo.
Revisar el archivo manualmente
Empieza escribiendo la dirección del archivo directamente en el navegador, en una ruta como https://example.com/robots.txt. Lo que se carga ahí es exactamente lo que ve cada rastreador, así que conviene leerlo tal cual está en lugar de confiar en el archivo que crees haber subido.
Comprueba que la línea del mapa del sitio lleva a un mapa del sitio real y que funciona. Revisa que cada ruta bloqueada sea una que realmente quisiste bloquear, y que nada importante quede dentro por accidente. Si el archivo se editó desde un plugin o una opción del tema, confirma que la versión en vivo coincide con lo que guardaste, ya que una copia en caché a veces tarda más de lo esperado en actualizarse.
Revisarlo con un comprobador de robots.txt
Leer el archivo detecta erratas y errores evidentes, pero no siempre te dirá cómo interpreta un rastreador concreto las reglas que se superponen. Un comprobador hace ese trabajo por ti.
El Comprobador de Robots.txt gratuito de RepGet ofrece un veredicto para los buscadores y los rastreadores de IA a la vez, así que puedes confirmar en una sola pasada que Googlebot y Bingbot están permitidos donde esperas y que cualquier rastreador de IA que hayas nombrado se trata como pretendías, ya sea permitido o bloqueado.
Vuelve a ejecutar la comprobación después de cualquier cambio en el archivo, incluso uno pequeño. Basta con que una sola línea acabe en el bloque equivocado para deshacer lo que el resto del archivo hace bien.
Lista de revisión de 20 minutos para un archivo robots.txt existente
La mayoría de los sitios de pequeñas empresas ya tienen un archivo robots.txt, aunque nadie recuerde haberlo escrito. Merece la pena dedicarle un repaso breve y programado en lugar de dar por hecho que sigue haciendo lo que debía.
Paso | Qué revisar | Tiempo |
|---|---|---|
1. Cargar el archivo en vivo | Visita la dirección del archivo y lee lo que está publicado de verdad, no un borrador guardado | 2 minutos |
2. Buscar un bloqueo general | Confirma que no queda un | 2 minutos |
3. Revisar cada ruta bloqueada | Confirma que cada carpeta bloqueada sigue existiendo y sigue mereciendo estar bloqueada | 5 minutos |
4. Revisar el acceso a CSS y JavaScript | Confirma que nada bloquea las carpetas que necesitan tus páginas para mostrarse correctamente | 3 minutos |
5. Revisar los bloqueos de rastreadores de IA por nombre | Confirma que GPTBot, ClaudeBot y PerplexityBot están permitidos o bloqueados a propósito, no por defecto | 3 minutos |
6. Confirmar la línea del mapa del sitio | Comprueba que apunta a una dirección de mapa del sitio real y actual | 2 minutos |
7. Ejecutar una herramienta de comprobación | Confirma que los veredictos coinciden con lo que pretendías para cada rastreador | 3 minutos |
Veinte minutos bastan para detectar el tipo de error que, de otro modo, pasa desapercibido durante meses. Ponte un recordatorio en el calendario cada pocos meses, o cada vez que el sitio cambie de alojamiento, tema o plataforma, ya que esos cambios a veces reescriben el archivo sin que nadie lo decida.
Dónde encaja RepGet
Decidir qué carpetas merecen bloquearse y qué rastreadores de IA quiere realmente una empresa que lean sus páginas es una decisión de criterio que corresponde a quienes gestionan el sitio. Ninguna herramienta puede tomarla por ti, porque depende de lo que vende el negocio, de lo que le resulta cómodo y de lo que buscan sus clientes.
Lo que RepGet sí puede hacer es agilizar la comprobación del resultado de esa decisión. Su Comprobador de Robots.txt gratuito ofrece un veredicto para los buscadores y los rastreadores de IA a la vez, así que un archivo editado a mano o generado por una herramienta puede verificarse en pocos segundos en lugar de leerse línea por línea. Su auditoría web gratuita rastrea un sitio, le asigna una puntuación SEO de 0 a 100 y enumera los problemas técnicos que conviene investigar, lo que puede sacar a la luz un problema de robots.txt junto con otras cosas que merecen arreglarse en la misma visita. No se necesita cuenta ni tarjeta de crédito para ninguna de las dos.
RepGet no escribe el archivo robots.txt de una empresa por ella, no decide qué rastreadores de IA debería acoger un negocio y no garantiza que permitir un rastreador lleve a una mención en la respuesta de un asistente de IA ni a una posición concreta en Google. Esos resultados dependen de mucho más que de un pequeño archivo de texto, y nadie puede prometerlos.
Lo esencial
Un archivo robots.txt seguro es un archivo corto, escrito con intención, en el que cada ruta bloqueada tiene un motivo claro detrás.
Un generador o una plantilla es un buen punto de partida, pero el resultado aún necesita una lectura de alguien que conozca el sitio, una comprobación de que la línea del mapa del sitio es real y una prueba antes de publicarlo. El mismo cuidado se aplica a los rastreadores de IA: nombrar a uno en su propio bloque te permite permitirlo o bloquearlo de forma deliberada, sin tocar las reglas que mantienen a Google y Bing rastreando con normalidad.
Nada de esto garantiza un buen posicionamiento, un lugar en la respuesta de un asistente de IA ni una cantidad concreta de tráfico. Lo que sí hace es asegurarse de que el archivo no esté trabajando en silencio en contra del sitio que se supone que debe proteger.
Descubre primero lo que necesita tu sitio web
Antes de publicar un nuevo archivo robots.txt, mira qué permite tu sitio actualmente y qué otros aspectos podrían necesitar atención. Ejecuta una auditoría web gratuita con RepGet para revisar la configuración técnica de tu sitio junto con su contenido. No se necesita cuenta ni tarjeta de crédito.
Preguntas frecuentes
¿Puede un generador de robots.txt bloquear a Google por accidente?
Sí, si su resultado por defecto o una plantilla copiada incluye una regla general o una ruta mal escrita. Revisa siempre lo que produce un generador y pruébalo con un verificador antes de publicarlo en un sitio en vivo.
¿Necesito un archivo robots.txt si mi sitio es pequeño?
Un sitio pequeño puede funcionar sin uno, ya que los rastreadores lo seguirán rastreando por defecto. Aun así, un archivo corto merece la pena si quieres bloquear una carpeta específica o indicar a los rastreadores la ubicación de tu mapa del sitio.
¿Cómo bloqueo a ChatGPT para que no rastree mi sitio web?
Añade un bloque
User-agent: GPTBotconDisallow: /a tu archivo robots.txt. OpenAI documenta directamente el comportamiento de GPTBot, así que conviene revisar su documentación actual de rastreadores antes de confiar en esta regla.¿Dónde debo subir mi archivo robots.txt?
Debe estar en la raíz de tu dominio, como texto plano con el nombre exacto
robots.txt, accesible en una dirección comohttps://example.com/robots.txt. Una copia en una subcarpeta no la leerán los rastreadores.¿Bloquear a GPTBot impide que mi sitio aparezca en las respuestas de ChatGPT?
Bloquear a GPTBot impide que el rastreador de OpenAI acceda a tus páginas para sus usos documentados. No garantiza nada sobre si ni cómo se menciona a una empresa en la respuesta de un asistente de IA.
¿Con qué frecuencia debo revisar mi archivo robots.txt?
Una revisión rápida cada pocos meses es razonable, y conviene revisarlo de nuevo cada vez que el sitio cambie de alojamiento, de tema o de plataforma, ya que esos cambios a veces reescriben el archivo sin que nadie lo decida.
¿Cuál es la diferencia entre robots.txt y una etiqueta noindex?
Robots.txt pide a los rastreadores que no soliciten una URL en absoluto. Una etiqueta noindex permite el rastreo pero pide a los buscadores que no incluyan la página en sus resultados. Usar ambas en la misma página puede hacer que se contradigan.
¿Puedo tener reglas de robots.txt distintas para diferentes bots de IA?
Sí. Cada rastreador puede tener su propio bloque
User-agentcon sus propias reglas, así que puedes permitir un rastreador de IA y bloquear otro sin afectar en absoluto a Googlebot o Bingbot.