

KI-Webcrawler: So liest und indexiert er Ihre Website
Kurze Antwort
Ein KI-Webcrawler ist automatisierte Software, etwa GPTBot oder ClaudeBot, die Ihre Seiten aufruft, zuerst die robots.txt prüft und dann den rohen HTML-Code liest, um Text für einen KI-Assistenten zu sammeln. Er kann JavaScript meist nicht so ausführen wie ein Browser. Deshalb sind Skripte, die Text erst nach dem Öffnen der Seite laden, Logins und versehentliche Sperren in der robots.txt die häufigsten Gründe, warum diese Bots eine Website nicht lesen.
Ein Unternehmer fragt ChatGPT nach einem Unternehmen wie seinem.
Das eigene Geschäft taucht nie auf.
Die Website lädt im Browser einwandfrei. Sie rankt bei Google trotzdem gut. Nichts daran wirkt kaputt.
Die eigentliche Frage lautet also, ob ein KI-Webcrawler die Website überhaupt erreicht, oder ob etwas auf der Seite diesen Crawler still und leise fernhält, ohne dass jemand das bewusst entschieden hat.
So liest ein KI-Webcrawler eine Website, was ihn versehentlich blockiert und wie Sie prüfen, ob Ihre Seiten sowohl für Suchmaschinen-Bots als auch für KI-Assistenten lesbar sind.
Was als KI-Webcrawler gilt
Ein KI-Webcrawler ist automatisierte Software, die Webseiten im Auftrag eines KI-Unternehmens aufruft, so wie der Crawler einer Suchmaschine.
Er fordert eine Seite an, liest, was zurückkommt, und geht dann zur nächsten. Niemand sitzt an einer Tastatur und klickt sich durch Ihre Website. Ein Programm erledigt das nach Zeitplan, über Millionen von Seiten gleichzeitig.
Unterschiedlich ist der Zweck hinter dem Besuch. Ein Suchmaschinen-Crawler sammelt Seiten meist, um einen Ranking-Index aufzubauen. Ein KI-Crawler sammelt Seiten meist, um ein Modell zu trainieren, die Antworten eines Assistenten mit aktuellen Informationen zu untermauern oder es dem Assistenten zu ermöglichen, eine Quelle zu nennen, wenn er auf eine Frage antwortet.
KI-Crawler vs. klassische Suchmaschinen-Crawler
Googlebot und Bingbot sind Suchmaschinen-Crawler. Ihre Aufgabe ist es, Seiten zu finden, sie gut genug zu verstehen, um sie zu ranken, und für eine bestimmte Suche die passendsten anzuzeigen.
GPTBot, ClaudeBot und PerplexityBot sind KI-Crawler. Sie werden von OpenAI, Anthropic bzw. Perplexity betrieben, und jedes Unternehmen dokumentiert den Zweck des eigenen Crawlers, statt es dem Raten zu überlassen.
Der Ablauf eines einzelnen Besuchs sieht in beiden Fällen ähnlich aus: Seite anfordern, HTML lesen, entscheiden, ob einem Link gefolgt wird. Der Unterschied liegt in dem, was danach mit den Inhalten passiert. Das legt die jeweilige Richtlinie des Unternehmens fest und ist von außen nicht zu erkennen.
Warum das auch zählt, wenn Sie den Namen GPTBot noch nie gehört haben
Ein Unternehmer muss nicht jeden Crawler namentlich kennen, um sich dafür zu interessieren.
Entscheidend ist etwas Einfacheres: Wenn Ihre Kunden KI-Assistenten nach Empfehlungen fragen, statt eine Suche in Google einzugeben, dann entscheidet mit darüber, ob Ihr Unternehmen überhaupt gefunden wird, ob diese Crawler Ihre Website lesen können.
Das ist eine andere Frage als die, ob Ihre Website in Google gut rankt. Eine Seite kann in der Suche hervorragend ranken und trotzdem für einen KI-Crawler unsichtbar bleiben, weil die beiden Systeme nicht unbedingt dasselbe sehen.
Wie ein KI-Crawler eine Seite tatsächlich liest
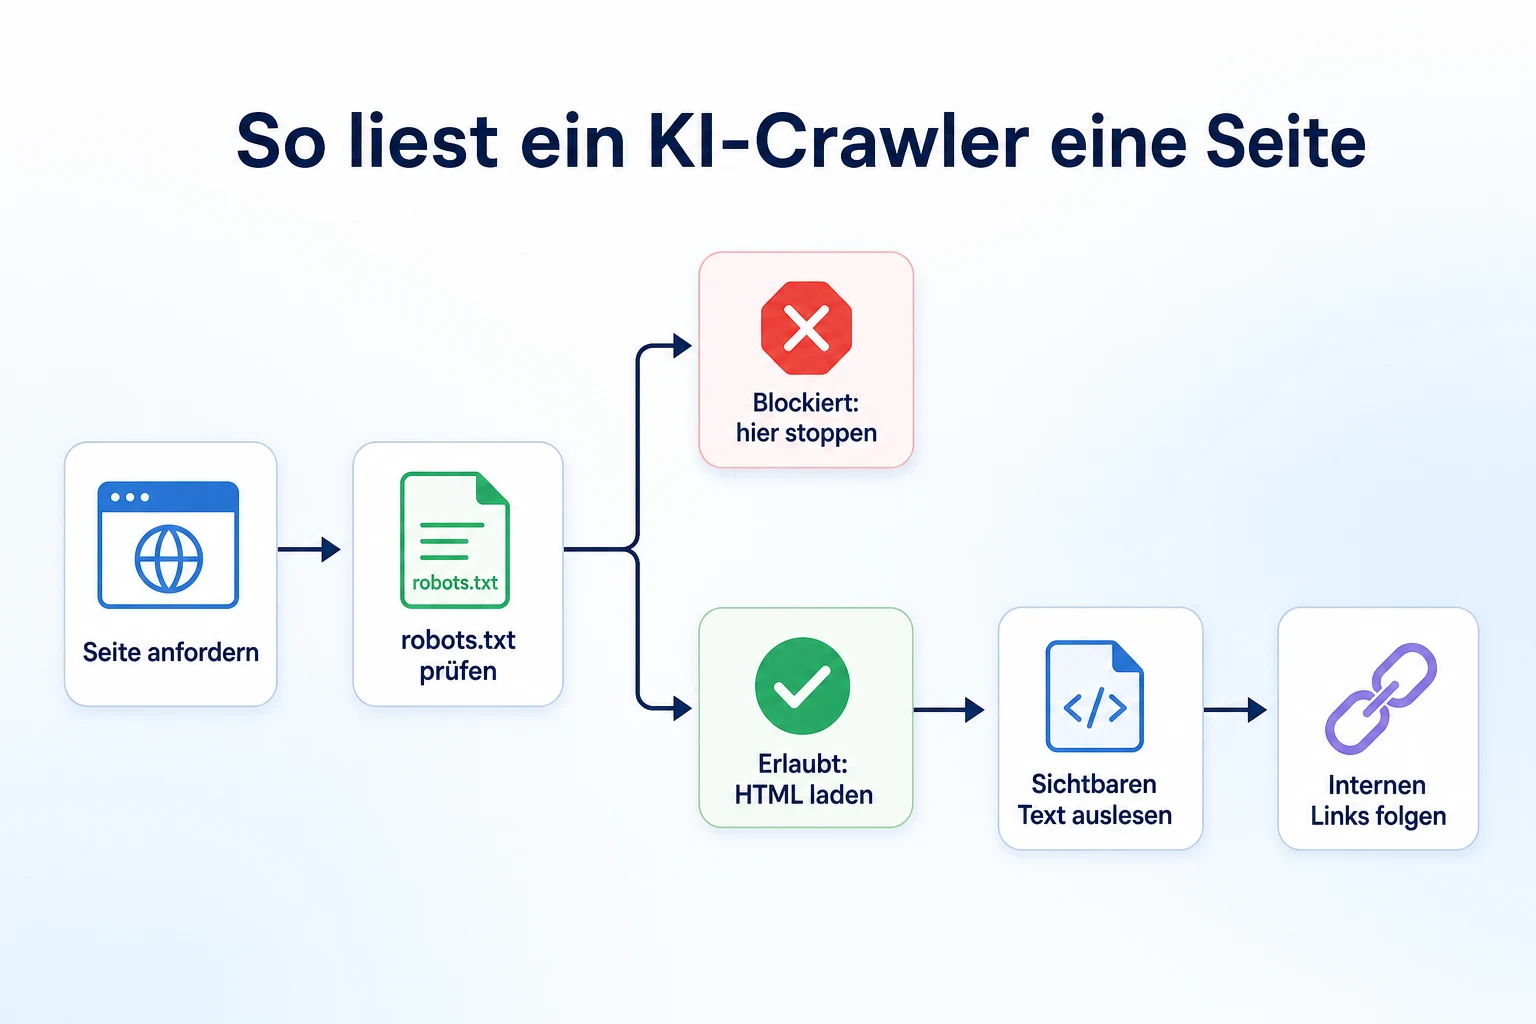
Auf die Mechanik heruntergebrochen folgt ein einzelner Crawler-Besuch einer kurzen, ziemlich mechanischen Abfolge. Wer diese Abfolge versteht, erkennt viel leichter, wo sie scheitern kann.
Zuerst die Regeln in der robots.txt prüfen
Bevor er eine Seite anfordert, prüft ein sauber arbeitender Crawler die Datei robots.txt Ihrer Website auf eine Regel, die ihn ausdrücklich nennt, oder auf eine allgemeine Regel, die für alle gilt.
Googles eigene Dokumentation zur robots.txt beschreibt die Datei als den Standard, über den Crawler erfahren, welche Bereiche einer Website sie abrufen dürfen. Ein KI-Crawler, der diesen Standard respektiert, überspringt jeden Pfad, der für seinen User-Agent untersagt ist, und die gesamte Website, wenn eine pauschale Regel alles untersagt.
Das ist der erste und häufigste Schwachpunkt. Wenn eine Regel, die für einen Crawler gedacht war, versehentlich für alle gilt, kommt der Crawler gar nicht über diesen Schritt hinaus.
HTML anfordern und auswerten
Erlaubt die robots.txt den Zugriff, ruft der Crawler die Seite so ab wie ein Browser, indem er die URL anfordert und HTML zurückbekommt.
Danach durchsucht er dieses HTML nach Text, Überschriften und anderen lesbaren Inhalten. Viele KI-Crawler tun das, ohne die Seite so zu rendern wie ein Browser. Sie arbeiten also in der Regel mit der rohen HTML-Antwort und nicht mit allem, was später per Skript auf der Seite ergänzt wird.
Dieser Unterschied ist wichtiger, als er klingt, und er ist Thema eines eigenen Abschnitts weiter unten in diesem Artikel.
Ob tiefer in die Website gefolgt wird
Sobald eine Seite gelesen ist, schaut ein Crawler in der Regel auf die Links darin und entscheidet, ob er einem davon zu anderen Seiten derselben Website folgt.
So entdeckt ein Crawler Seiten, von denen ihm niemand direkt erzählt hat, indem er einer Kette interner Links von Seiten folgt, die er bereits kennt. Eine Seite, auf die von keiner anderen Stelle der Website ein Link verweist, kann für einen Crawler deutlich schwerer von selbst zu finden sein.
Die KI-Crawler, auf die Sie wahrscheinlich stoßen
Eine Handvoll benannter Crawler macht den größten Teil dessen aus, was eine Website eines kleinen Unternehmens in ihren Server-Logs oder ihren Crawler-Zugriffsberichten sieht. Diese Beispiele zeigen, was jedes Unternehmen dokumentiert. Es lohnt sich, die Seiten der Unternehmen direkt zu prüfen, da sich Namen und Richtlinien ändern können.
Crawler-Name | Betrieben von | Dokumentierter Zweck |
|---|---|---|
GPTBot | OpenAI | Crawlt Seiten, die für die dokumentierten Zwecke von OpenAI verwendet werden dürfen, einschließlich des Modelltrainings |
ClaudeBot | Anthropic | Crawlt Seiten im Auftrag von Anthropic, wie in seinen veröffentlichten Crawler-Informationen beschrieben |
PerplexityBot | Perplexity | Crawlt Seiten, aus denen Antworten von Perplexity stammen oder auf die sie verweisen können |
Google-Extended | Steuert, ob Inhalte einer Website für Gemini-Apps und verwandte generative Funktionen genutzt werden dürfen, getrennt vom regulären Crawling für die Google-Suche |
Diese Beschreibungen fassen zusammen, was die einzelnen Unternehmen öffentlich angeben. Den aktuellen, maßgeblichen Wortlaut finden Sie in deren eigener Dokumentation.
Ob Sie einen dieser Crawler blockieren oder zulassen, ändert nichts daran, dass Googlebot Ihre Website weiterhin crawlen und für die normale Suche ranken kann. Jeder Crawler folgt seiner eigenen Regel in der robots.txt, und sie sind voneinander unabhängig.
Bevor Sie zu einem davon eine Entscheidung treffen, hilft es zu wissen, was Ihre Website derzeit erlaubt. Der kostenlose KI-Crawler-Checker von RepGet prüft, ob GPTBot, ClaudeBot und PerplexityBot eine bestimmte Website aktuell erreichen können.
Was dem Crawler sagt, welche Seiten er lesen soll
Ein Crawler kennt die Struktur Ihrer Website nicht im Voraus. Er stützt sich auf eine kleine Gruppe von Signalen, um herauszufinden, was erlaubt ist und wo sich alles befindet.
Ihre robots.txt-Datei
Das ist die Berechtigungsebene. Sie legt fest, welche Pfade ein Crawler abrufen darf und welche er auslassen soll, bei Bedarf auch crawler-spezifisch.
Unser Leitfaden zum Erstellen einer robots.txt-Datei, die für Google und KI sicher ist behandelt die Syntax ausführlicher, einschließlich der Frage, wie Sie einen benannten KI-Crawler zulassen oder blockieren, ohne die Regeln für Suchmaschinen anzutasten.
Ihre XML-Sitemap
Eine Sitemap ist eine Liste Ihrer Seiten, meist unter einer Adresse wie yoursite.com/sitemap.xml. Sie gibt einem Crawler ein direktes Verzeichnis dessen, was existiert, statt sich nur darauf zu verlassen, dass er Links folgt, um Seiten zu finden.
Sie erzwingt kein Crawling und ist kein Ranking-Signal. Sie macht die Entdeckung nur schneller und vollständiger. Der kostenlose Sitemap-Checker & Finder von RepGet kann bestätigen, ob eine Sitemap vorhanden und gültig ist.
Interne Links zwischen Ihren Seiten
Eine Seite ohne interne Links, die auf sie verweisen, ist für jeden Crawler schwerer zu finden, ob KI oder nicht. Wenn Ihre neueste Leistungsseite nur über das Suchfeld Ihrer eigenen Website erreichbar ist, hat ein Crawler, der Links folgt, keine Möglichkeit, darauf zu stoßen.
Wenn Sie von Ihrer Startseite, dem Navigationsmenü oder verwandten Artikeln auf wichtige Seiten verlinken, haben Crawler einen klaren Weg, dem sie folgen können.
llms.txt: ein neueres, optionales Signal
llms.txt ist ein neueres, vorgeschlagenes Dateiformat, das auf llmstxt dokumentiert ist. Es soll KI-Systemen eine kurze, strukturierte Zusammenfassung der wichtigsten Seiten einer Website in einfacher Sprache geben.
Es ist kein Standard, den jeder KI-Crawler nachweislich liest, und es ersetzt weder robots.txt noch eine Sitemap. Es ist ein zusätzliches Signal, das manche Unternehmen optional hinzufügen. Der kostenlose llms.txt-Generator von RepGet kann daraus für Unternehmen, die es ausprobieren möchten, eine Datei aus den bestehenden Seiten einer Website erstellen.
Die versehentlichen Sperren, die KI-Webcrawler fernhalten
Die meisten Websites, die einen KI-Webcrawler blockieren, haben das nicht absichtlich getan. Die Sperre wurde aus einem anderen Grund geschrieben oder standardmäßig hinzugefügt, und niemand hat bemerkt, was sonst noch davon erfasst wird.
Eine übrig gebliebene oder zu weit gefasste robots.txt-Regel
Eine Regel, die einen einzelnen Crawler blockieren soll, kann am Ende mehrere blockieren, besonders wenn sie unter einem allgemeinen User-agent: *-Block steht und nicht für einen bestimmten Crawler mit Namen geschrieben wurde.
Das passiert auch, wenn die pauschale Disallow: /-Regel einer Staging-Website beim Start auf die Live-Domain kopiert wird und niemand sie entfernt. Jeder Crawler liest diese Regel gleich, ob KI-Crawler oder nicht.
Die Lösung ist, jedem Crawler, den Sie anders behandeln möchten, einen eigenen benannten Block zu geben, damit eine Regel für einen Crawler nicht stillschweigend für alle gilt. Unser Leitfaden zum Erstellen einer sicheren robots.txt-Datei erklärt die Syntax dafür Schritt für Schritt.
Eine Firewall oder ein Sicherheitsplugin, das standardmäßig blockt
Sicherheitsplugins und Firewalls auf Hosting-Ebene werden oft mit einer Einstellung ausgeliefert, die unbekannte User-Agents automatisch blockiert. Die Annahme dahinter: Die meisten unbekannten Bots sind Scraper oder Schlimmeres.
Aus Sicht der Firewall kann ein KI-Crawler genau wie solcher Datenverkehr aussehen. Es ist ein Programm, das wiederholt Anfragen von einer Adresse stellt, die die Firewall nicht kennt, und genau dieses Muster sollen viele dieser Tools stoppen.
Das Ergebnis ist ein Crawler, der in der robots.txt vollständig erlaubt ist, aber trotzdem nie durchkommt, weil etwas weiter unten im Stack die Anfrage ablehnt, bevor die robots.txt überhaupt geprüft wird. Diese Art von Sperre zeigt sich nicht, wenn man nur die robots.txt liest. Deshalb lohnt es sich, den Zugriff direkt zu testen und nicht nur die Regeln zu lesen.
Inhalte hinter einem Login oder einer Paywall
Seiten, die einen Login, eine Mitgliedschaft oder auch nur eine E-Mail-Adresse verlangen, bevor der Inhalt geladen wird, sind für einen Crawler genauso unsichtbar wie für einen Besucher, der sich nicht angemeldet hat.
Manchmal ist das beabsichtigt, und bei wirklich geschütztem Inhalt ist das eine vernünftige Entscheidung. Zum Problem wird es, wenn ein Unternehmen nicht merkt, dass eine Seite, die gefunden werden soll, etwa eine Preisseite oder ein Ratgeber, hinter einer Sperre liegt, die aus einem ganz anderen Grund eingebaut wurde.
Fehler | Auswirkung auf das Crawling | So prüfen Sie es |
|---|---|---|
Zu weit gefasste robots.txt-Regel | Blockiert einen KI-Crawler zusammen mit anderen unter einer gemeinsamen Regel | Die live robots.txt-Datei lesen und prüfen, für welche Crawler jeder Block gilt |
Firewall oder Plugin blockt unbekannte Bots | Lehnt die Anfrage des Crawlers ab, bevor die robots.txt überhaupt gelesen wird | Den tatsächlichen Zugriff mit einem Prüftool testen statt nur Regeln zu lesen |
Inhalt hinter Login oder Paywall | Verhindert, dass jeder Crawler die geschützte Seite überhaupt lesen kann | Prüfen, ob Seiten, die gefunden werden sollen, wirklich zuerst einen Login verlangen |
Aggressives Rate-Limiting | Behandelt wiederholte Crawler-Anfragen als Angriff und blockiert die Quelle | In Server- oder Firewall-Protokollen nach blockierten Anfragen von bekannten Crawler-Namen suchen |
Die kostenlosen Tools Robots.txt Checker und AI Crawler Checker von RepGet testen beide den tatsächlichen Zugriff statt nur die Regeln zu lesen. So erkennen sie auch Sperren auf Firewall-Ebene, die eine einfache Textdatei nicht verrät.
Warum JavaScript-lastige Seiten ein häufiger blinder Fleck sind
Eine Seite kann im Browser vollständig aussehen und für einen Crawler trotzdem fast leer sein, wenn dieser die Skripte nie ausgeführt hat, die den Inhalt eingefügt hätten.
Was ein Crawler sieht und was ein Besucher sieht
Viele KI-Crawler lesen das rohe HTML, das der Server zurückschickt, ohne das JavaScript auszuführen, mit dem der Browser danach den Rest der Seite aufbaut.
Ein Besucher öffnet eine Produktseite und sieht eine vollständige Beschreibung, eine Preistabelle und eine Reihe von Bewertungen. Wenn ein Teil dieses Inhalts erst erscheint, nachdem ein Skript läuft, das Daten von anderswo lädt und in die Seite einfügt, sieht ein Crawler, der dieses Skript nicht ausführt, davon möglicherweise nichts. Er sieht nur, was schon vor dem Skript im HTML stand.
Das wird leicht übersehen, weil bei der eigenen Prüfung nichts falsch aussieht. Sie nutzen einen Browser, und ein Browser führt die Skripte aus. Der Crawler tut das nicht, und genau darin liegt die Lücke.
Ein schneller Weg zu prüfen, was tatsächlich im HTML steht
Die einfachste Prüfung ist, den Quelltext der Seite direkt anzusehen statt das, was auf dem Bildschirm angezeigt wird, und nach dem tatsächlichen Text zu suchen, den ein Crawler lesen soll.
Wenn eine Beschreibung, ein Preis oder eine wichtige Angabe nur in der gerenderten Seite auftaucht und nicht im rohen Quelltext, dann ist das der Inhalt, den ein JavaScript-abhängiger Crawler wahrscheinlich ganz übersieht. Der kostenlose LLM HTML Visibility Checker von RepGet übernimmt diese Prüfung für Sie. Er zeigt, wie viel vom Text einer Seite tatsächlich im HTML steht, das ein Crawler erhält.
Ihre Website für KI-Assistenten lesbar machen, nicht nur crawlbar
Dass ein Crawler an der robots.txt vorbeikommt und die Seite erreicht, ist erst die halbe Arbeit. Was tatsächlich auf der Seite steht, muss er auch lesen und verwenden können.
Wichtige Angaben als Text, nicht nur als Bild
Ein Foto einer Speisekarte, eine eingescannte Preisliste oder eine Grafik mit Einsatzgebieten sieht für Besucher gut aus, enthält für einen Crawler aber keinen lesbaren Text. Ein Crawler kann Wörter in einem Bild nicht lesen.
Die Lösung ist nicht, das Bild zu entfernen. Man schreibt dieselben Informationen zusätzlich als normalen Text irgendwo auf die Seite, damit die Angabe in einer Form vorliegt, die ein Crawler tatsächlich auswerten kann.
Klare Überschriften, die den Inhalt beschreiben
Überschriften, die genau sagen, was ein Abschnitt enthält, statt vage oder clever zu sein, helfen jedem System, das die Seite liest, schneller zu verstehen, worum es in jedem Teil geht.
Eine Überschrift wie „Unsere Preise“ sagt einem Crawler genau, was folgt. Eine Überschrift wie „Was es Sie kostet“ wirkt für einen Menschen vielleicht besser, gibt einem Auswertungssystem aber weniger zum Arbeiten.
Wichtige Informationen nicht hinter Klicks verstecken
Inhalte, die erst erscheinen, nachdem ein Besucher einen Tab anklickt, eine Akkordeon-Box aufklappt oder ein mehrstufiges Formular durchläuft, können für einen Crawler unsichtbar bleiben, der nicht wie ein Mensch mit der Seite interagiert.
Wenn eine Angabe so wichtig ist, dass sie gefunden werden soll, sollte sie in der Regel im Text stehen, der von Anfang an auf der Seite vorhanden ist, und nicht hinter einem zusätzlichen Klick. Das kostenlose Meta Tag Checker von RepGet prüft, was im Titel, in der Beschreibung und in anderen Tags einer Seite steht, die sowohl Suchmaschinen als auch KI-Systeme üblicherweise zuerst lesen.
Crawlen, Indexieren und in einer Antwort erscheinen sind drei verschiedene Dinge
Man nimmt leicht an, dass alles Weitere automatisch folgt, sobald ein Crawler eine Seite erreichen kann. Das stimmt nicht. Es sind drei getrennte Schritte, und das Abhaken eines Schritts garantiert den nächsten nicht.
Stufe | Was das bedeutet | Was nicht garantiert ist |
|---|---|---|
Seite wird gecrawlt | Ein Crawler hat das HTML der Seite erfolgreich abgerufen und gelesen | Dass der Inhalt gespeichert, indexiert oder danach irgendwie verwendet wurde |
Inhalt wird indexiert oder referenziert | Das System hat Informationen von der Seite behalten oder kann auf sie zugreifen | Dass die Seite in einer bestimmten Antwort zitiert oder erwähnt wird |
Unternehmen wird in einer Antwort genannt | Eine bestimmte Anfrage hat eine Antwort erzeugt, die das Unternehmen nennt | Dass dieselbe oder eine ähnliche Anfrage erneut dasselbe Ergebnis liefert |
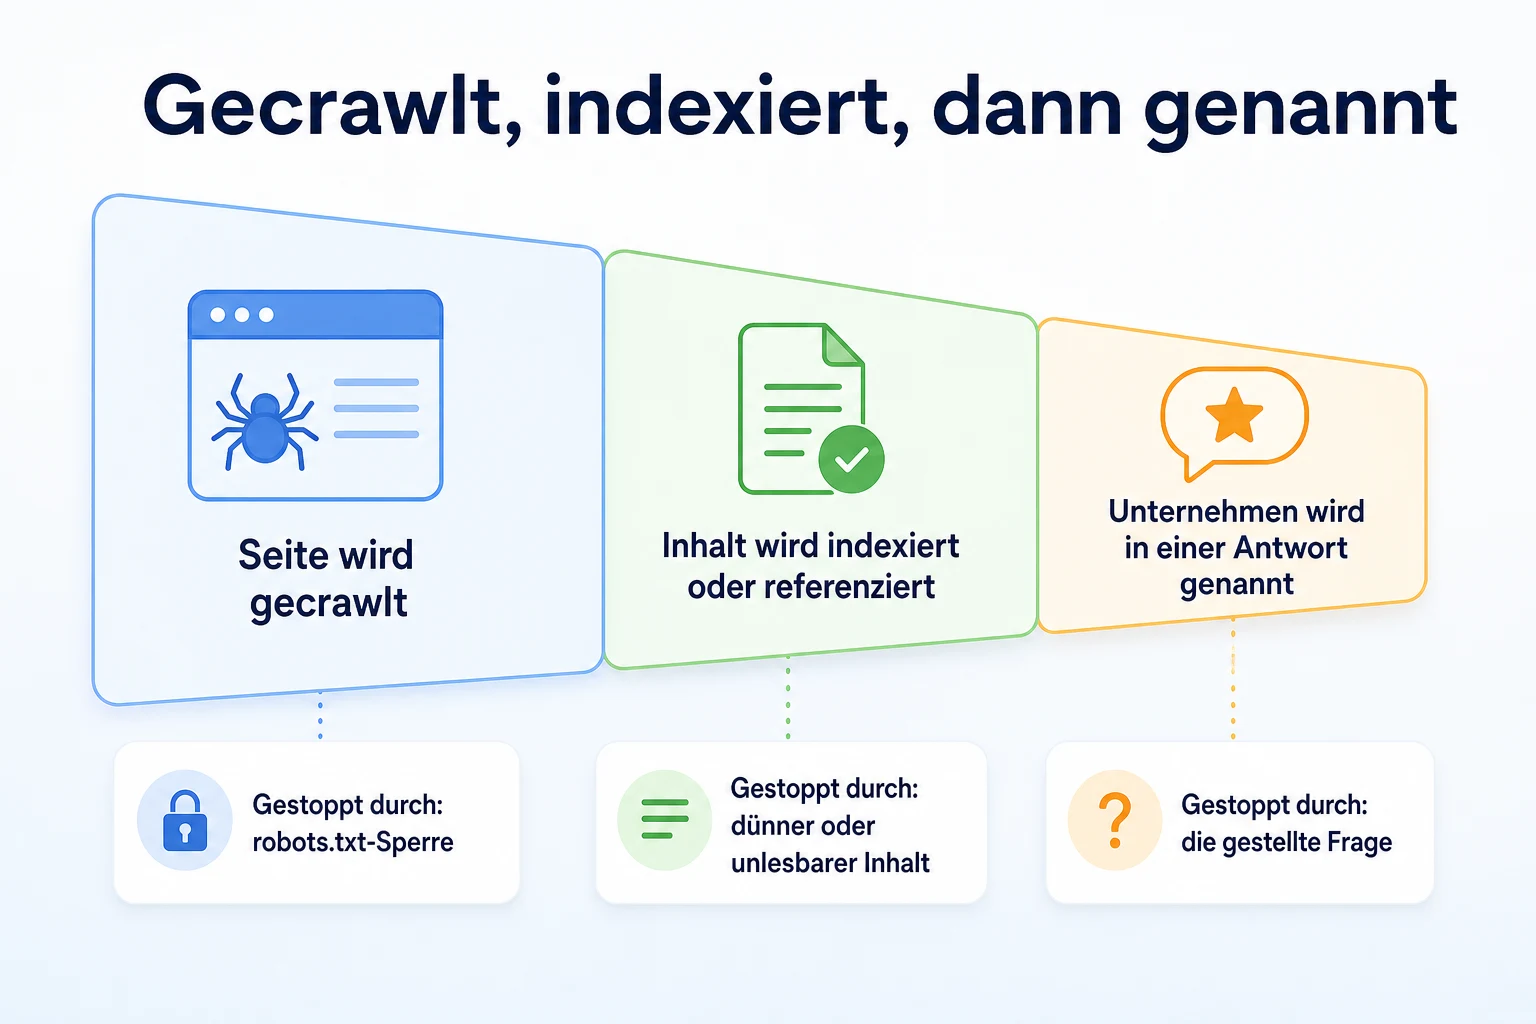
Eine Seite kann gecrawlt werden, ohne dass sie je wieder referenziert wird, genauso wie Googlebot eine Seite crawlen kann, die nie für etwas Nützliches rankt. Ob ein Unternehmen in einer bestimmten KI-Antwort genannt wird, hängt stark von der gestellten Frage, dem verwendeten Assistenten und Informationen ab, auf die das Unternehmen keinen Einfluss hat.
Unser Leitfaden, wie man in ChatGPT erwähnt wird, und unsere Erklärung, wie KI-Assistenten entscheiden, welche Unternehmen sie empfehlen, gehen beide genauer darauf ein, was nach einer lesbaren Seite passiert und was danach außerhalb jeder Kontrolle liegt.
Ein Praxisbeispiel: So sieht ein KI-Webcrawler eine Seite
Stellen Sie sich einen Landschaftsbau-Betrieb vor, der eine Seite für Rasenpflege unter einer Adresse wie example.com/services/lawn-care hat. Dieses Beispiel dient nur der Veranschaulichung.
GPTBot ruft die Seite auf. Zuerst prüft er die robots.txt, findet keine Regel, die ihn nennt oder den Pfad blockiert, und die Anfrage wird durchgelassen.
Der Crawler hat diese Seite nicht über einen Link von der Startseite gefunden. Einen solchen Link gibt es nicht. Er fand die URL in der Sitemap der Website. Nur dadurch wusste er überhaupt, dass die Seite existiert.
Sobald die Seite geladen ist, liest der Crawler das HTML, das er erhält. Die Leistungsbeschreibung steht in einfachen Absätzen direkt im Quelltext. Das gilt auch für die Überschriften: „Rasenpflege-Leistungen“, „Unsere Einsatzgebiete“ und „Was enthalten ist“. Das alles wird ohne Probleme gelesen.
Weiter unten auf der Seite gibt es eine Preistabelle. Auf der Live-Seite klickt ein Besucher auf einen Tab mit der Bezeichnung „Preise“, und ein Skript lädt den Inhalt der Tabelle kurz darauf nach.
Der Crawler klickt nie etwas an. Er liest, was beim ersten Laden der Seite bereits im HTML vorhanden war, und die Preistabelle war dort noch nicht enthalten. Soweit dieser Crawler erkennen kann, hat die Seite keine Preisinformationen, obwohl jeder Besucher, der auf den Tab klickt, sie klar sieht.
Niemand hat diesen Tab gebaut, um etwas vor einem Crawler zu verbergen. Er sollte die Seite übersichtlich halten. Die Wirkung auf einen KI-Crawler war bei der Entscheidung schlicht nie ein Thema.
Eine 20-Minuten-Checkliste, um zu prüfen, ob Ihre Website crawlbar ist
Das lohnt sich nach jeder Änderung an der Website, etwa nach einem neuen Plugin, einem Theme-Update oder einem Umzug zu einem neuen Hosting-Anbieter. Jede dieser Änderungen kann die Regeln, auf die sich ein Crawler verlässt, unbemerkt verändern.
Schritt | Was prüfen | Zeit |
|---|---|---|
1. Die live robots.txt-Datei lesen | Prüfen, ob es keine pauschale Sperre gibt und keine Regel versehentlich mehr Crawler erfasst als beabsichtigt | 3 Minuten |
2. Zugriff der benannten KI-Crawler testen | Prüfen, ob GPTBot, ClaudeBot und PerplexityBot absichtlich erlaubt oder gesperrt sind und nicht aus Versehen | 3 Minuten |
3. Sitemap auf Gültigkeit prüfen | Prüfen, ob sie Ihre aktuellen Seiten auflistet und fehlerfrei geladen wird | 3 Minuten |
4. Seitenquelltext wichtiger Seiten ansehen | Prüfen, ob Beschreibungen, Preise und andere wichtige Fakten tatsächlich im rohen HTML stehen und nicht nur auf der gerenderten Seite | 5 Minuten |
5. Firewall- oder Sicherheitsplugin-Einstellungen prüfen | Prüfen, ob unbekannte Crawler-User-Agents nicht standardmäßig blockiert werden | 3 Minuten |
6. Prüfen, ob öffentliche Seiten nicht hinter einem Login liegen | Prüfen, ob Seiten, die gefunden werden sollen, ohne Anmeldung oder E-Mail-Eingabe laden | 3 Minuten |
Zwanzig Minuten reichen, um die meisten der versehentlichen Sperren zu finden, die in diesem Artikel behandelt wurden. Mit dem kostenlosen KI-Crawler-Checker, dem Robots.txt-Checker, dem Sitemap-Checker & Finder und dem LLM-HTML-Sichtbarkeits-Checker von RepGet lassen sich die meisten dieser Schritte schneller erledigen, statt jeden einzeln von Hand zu prüfen.
Wo RepGet ins Spiel kommt
Herauszufinden, welcher Crawler welche Seite erreichen kann und welche Fakten tatsächlich im rohen HTML stehen, ist detaillierte, etwas technische Arbeit, die man leicht aufschiebt.
Das kostenlose Website-Audit von RepGet crawlt eine Website, vergibt einen SEO-Score von 0 bis 100 und listet technische und inhaltliche Probleme auf, die sich zu untersuchen lohnen. Dabei kann es ein Problem mit der robots.txt ebenso aufdecken wie eine dünne Seite, zusammen mit anderen Punkten, die bei demselben Besuch behoben werden können. Der kostenlose KI-Crawler-Checker testet, ob GPTBot, ClaudeBot und PerplexityBot eine bestimmte Website aktuell erreichen können, und der kostenlose LLM-HTML-Sichtbarkeits-Checker zeigt, wie viel vom Text einer Seite tatsächlich im HTML steht, das ein Crawler erhält. Für keines davon sind ein Konto oder eine Kreditkarte nötig.
Keines dieser Tools kann Ihnen sagen, ob ein bestimmter KI-Assistent Ihr Unternehmen in einer bestimmten Antwort nennt, und RepGet garantiert das auch nicht. Sie zeigen Ihnen aber in wenigen Minuten, ob Zugang und Inhalte überhaupt vorhanden sind. Genau dieser Teil liegt in Ihrer Hand als Unternehmen.
Das Fazit
Ein KI-Webcrawler ist nicht geheimnisvoll, wenn man ihn in seine Schritte zerlegt. Er prüft die robots.txt, ruft die Seite auf, liest das HTML, das er zurückbekommt, und folgt manchmal einem Link zur nächsten Seite.
Die meisten Hindernisse für diese Crawler sind nicht absichtlich entstanden. Eine übriggebliebene robots.txt-Regel, eine Firewall, die unbekannte Bots standardmäßig blockiert, eine Login-Sperre, die aus einem anderen Grund eingebaut wurde, oder eine Information, die erst nach einem Klick oder einem Skript erscheint: All das kann einen Crawler unbemerkt davon abhalten, Inhalte zu sehen, die ein Besucher problemlos sieht.
Das zu beheben ist eine Frage von Zugang und klar lesbarem Inhalt, eine Garantie für mehr ist es nicht. Gecrawlt zu werden heißt nicht, auch indexiert zu werden, und indexiert zu sein heißt nicht, in einer bestimmten KI-Antwort genannt zu werden. Diese letzten Schritte hängen von weit mehr ab, als eine einzelne Website beeinflussen kann.
Finden Sie zuerst heraus, was Ihre Website braucht
Bevor Sie eine bestimmte Crawler-Einstellung angehen, sehen Sie nach, was Ihre Website derzeit erlaubt und wo ihr Inhalt möglicherweise zu kurz kommt. Starten Sie ein kostenloses Website-Audit mit RepGet, um die technische Einrichtung Ihrer Website zusammen mit den Inhalten zu prüfen. Kein Konto und keine Kreditkarte nötig.
Häufige Fragen
Was ist ein KI-Webcrawler?
Es ist automatisierte Software, etwa GPTBot oder ClaudeBot, die Seiten einer Website abruft, um Text für die dokumentierten Zwecke eines KI-Unternehmens zu sammeln, zum Beispiel um ein Modell zu trainieren oder die Antworten eines Assistenten auf aktuelle Informationen zu stützen.
Wie erkenne ich, ob der Crawler von ChatGPT meine Website besucht hat?
Prüfen Sie Ihre Server-Logs auf Anfragen von GPTBot oder nutzen Sie ein Prüftool, das testet, ob GPTBot Ihre Website derzeit aufrufen kann. Logs zeigen tatsächliche frühere Besuche, ein Prüftool zeigt, ob der Zugriff im Moment erlaubt ist.
Kann ich KI-Crawler blockieren, ohne Google zu blockieren?
Ja. Geben Sie jedem Crawler einen eigenen benannten
User-agent-Block in der robots.txt. So gilt eine Regel für einen KI-Crawler nicht versehentlich auch für Googlebot oder einen anderen Crawler.Hindert JavaScript KI-Crawler daran, meine Website zu lesen?
Viele KI-Crawler lesen das rohe HTML, das der Server zurückschickt, ohne JavaScript so auszuführen wie ein Browser. Inhalte, die erst nach dem Ausführen eines Skripts erscheinen, können für sie unsichtbar bleiben, obwohl Besucher sie problemlos sehen.
Warum taucht mein Unternehmen nicht in ChatGPT auf, obwohl Google meine Website crawlen kann?
Googlebot und KI-Crawler folgen getrennten Regeln und können unabhängig voneinander erlaubt oder blockiert werden. Außerdem garantiert ein gecrawlter Seiteninhalt nicht, dass er in einer bestimmten KI-Antwort berücksichtigt oder namentlich genannt wird.
Brauche ich eine llms.txt-Datei für KI-Crawler?
Nein. Sie ist eine optionale, neuere Datei, und nicht jeder KI-Crawler ist dokumentiert so, dass er sie liest. Sie ersetzt weder robots.txt noch eine Sitemap, die beide weiterhin die wichtigsten Signale sind, auf die sich Crawler stützen.
Wie oft besuchen KI-Crawler eine Website?
Das hängt vom Crawler und von der Website ab, und Unternehmen veröffentlichen keinen festen Zeitplan. Die Server-Logs über einen längeren Zeitraum zu prüfen, ist der einzige verlässliche Weg, um zu sehen, wie oft ein bestimmter Crawler Ihre Website tatsächlich besucht.
Ist GPTBot dasselbe wie Googlebot?
Nein. Sie werden von verschiedenen Unternehmen für unterschiedliche Zwecke betrieben. GPTBot ist der Crawler von OpenAI, Googlebot crawlt für die Google-Suche, und jeder folgt seinen eigenen, getrennten Regeln in der robots.txt.