

Rastreador web con IA: cómo lee e indexa tu sitio web
Respuesta corta
Un rastreador web con IA es un software automatizado, como GPTBot o ClaudeBot, que solicita tus páginas, revisa primero el archivo robots.txt y luego lee el HTML sin procesar para reunir texto para un asistente de IA. Normalmente no puede ejecutar JavaScript como lo hace un navegador, así que los scripts que cargan texto después de abrirse la página, los inicios de sesión y los bloqueos accidentales en robots.txt son las causas más comunes por las que estos bots no leen un sitio.
Un dueño de negocio le pide a ChatGPT que recomiende una empresa como la suya.
Su propio negocio nunca aparece.
El sitio web carga bien en el navegador. Además, sigue posicionando bien en Google. Nada en él parece roto.
Así que la pregunta real es si un rastreador web con IA llega siquiera al sitio, o si algo en él está impidiendo discretamente el paso a ese rastreador sin que nadie lo haya decidido a propósito.
Aquí tienes cómo lee realmente un rastreador web con IA un sitio web, qué lo bloquea por accidente y cómo comprobar que tus páginas son legibles tanto para los bots de los buscadores como para los asistentes de IA.
Qué es un rastreador web con IA
Un rastreador web con IA es un software automatizado que visita páginas web en nombre de una empresa de IA, igual que lo hace el rastreador de un buscador.
Solicita una página, lee lo que recibe y pasa a la siguiente. Nadie está frente a un teclado haciendo clic por tu sitio. Lo hace un programa, de forma programada, en millones de páginas a la vez.
Lo que cambia es el propósito de la visita. Un rastreador de buscador suele recopilar páginas para construir un índice de resultados ordenados. Un rastreador de IA suele recopilar páginas para entrenar un modelo, para basar las respuestas de un asistente en información actual o para que ese asistente pueda citar una fuente al responder una pregunta.
Rastreadores de IA frente a rastreadores de buscadores tradicionales
Googlebot y Bingbot son rastreadores de buscadores. Su trabajo es encontrar páginas, entenderlas lo suficiente como para posicionarlas y mostrar las más relevantes para una búsqueda concreta.
GPTBot, ClaudeBot y PerplexityBot son rastreadores de IA. Los operan OpenAI, Anthropic y Perplexity respectivamente, y cada empresa documenta el propósito de su propio rastreador en lugar de dejarlo a la suposición.
La mecánica de una sola visita se parece en ambos casos: solicitar una página, leer el HTML y decidir si sigue un enlace. La diferencia está en lo que ocurre después con el contenido, y eso lo fija la política declarada de cada empresa, no algo que se vea desde fuera.
Por qué importa aunque nunca hayas oído el nombre GPTBot
Un negocio no necesita conocer por su nombre a todos los rastreadores para que le importe esto.
Lo esencial es más simple: si tus clientes empiezan a pedir recomendaciones a los asistentes de IA en lugar de escribir una búsqueda en Google, que estos rastreadores puedan leer tu sitio pasa a ser parte de si tu negocio puede encontrarse en absoluto.
Esa es una pregunta distinta de si tu sitio posiciona bien en Google. Una página puede posicionar perfectamente en la búsqueda y seguir siendo invisible para un rastreador de IA, porque los dos sistemas no necesariamente ven lo mismo.
Cómo lee realmente una página un rastreador de IA
Reducido a su mecánica, una sola visita de un rastreador sigue una secuencia corta y bastante mecánica. Entender esa secuencia facilita mucho detectar dónde puede fallar.
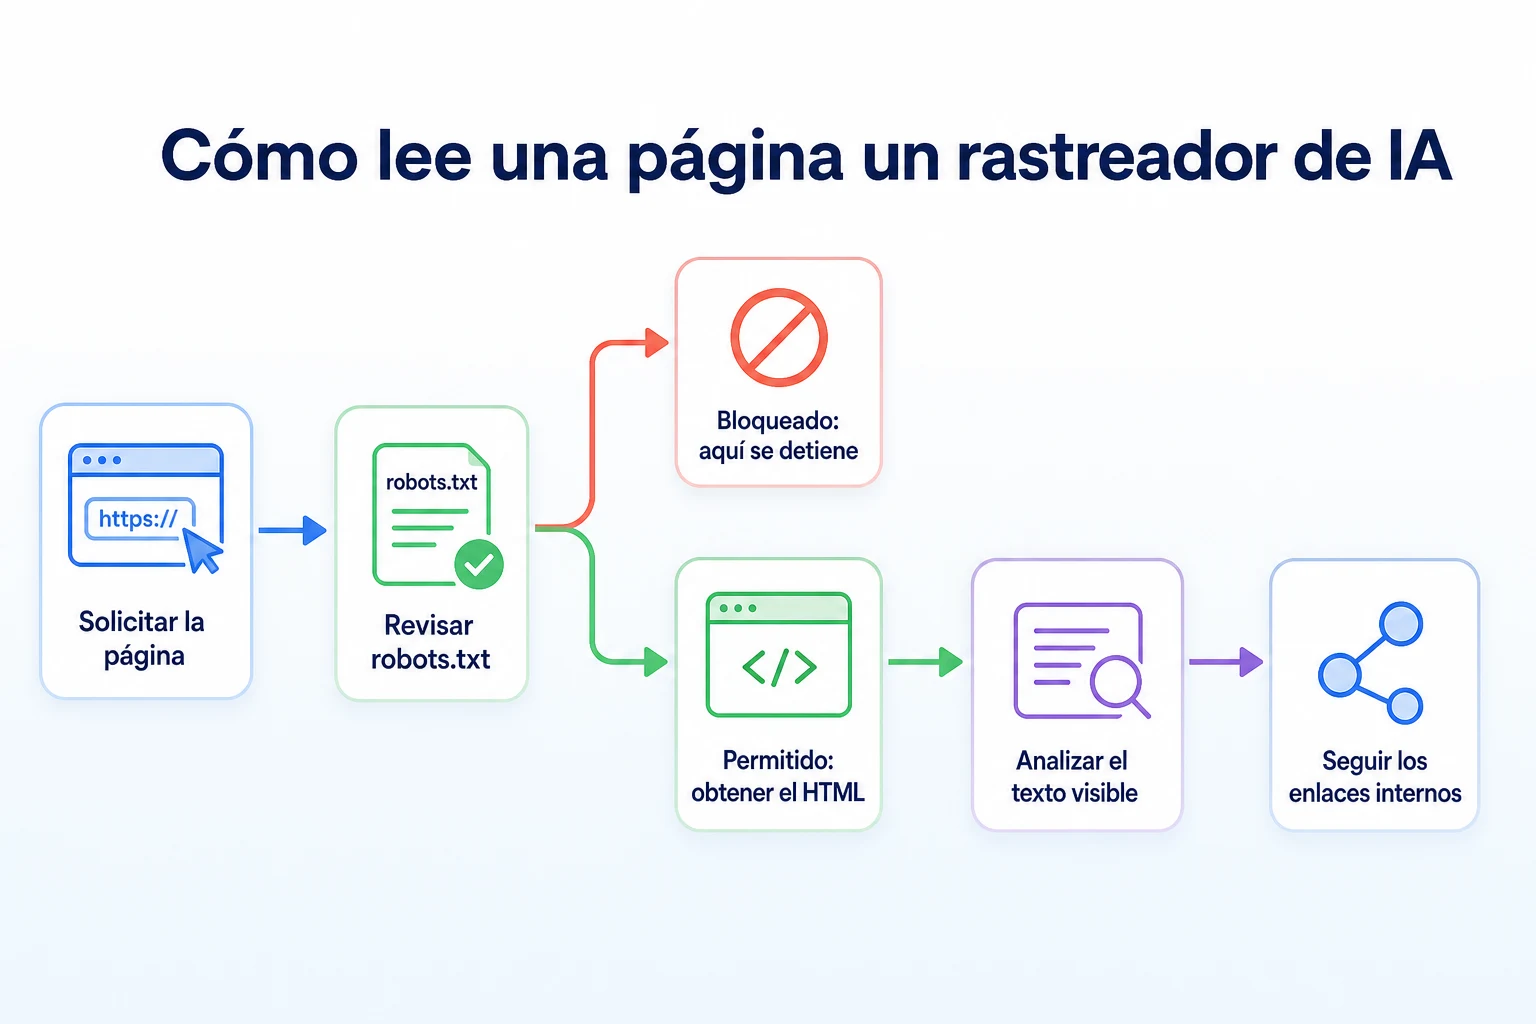
Primero, comprobar las reglas en robots.txt
Antes de solicitar una página, un rastreador bien comportado revisa el archivo robots.txt de tu sitio en busca de una regla que lo nombre específicamente o de una regla general que se aplique a todos.
La documentación oficial de Google sobre cómo funciona robots.txt lo describe como la forma estándar en que los rastreadores saben qué partes de un sitio pueden solicitar. Un rastreador de IA que respete el estándar omitirá cualquier ruta que esté bloqueada para su user-agent, y omitirá el sitio entero si una regla general lo bloquea todo.
Este es el primer punto de fallo y también el más habitual. Si una regla pensada para un solo rastreador se aplica por error a todos, el rastreador nunca llega más allá de este paso.
Solicitar y analizar el HTML
Si robots.txt permite la solicitud, el rastreador descarga la página igual que lo haría un navegador: pide la URL y recibe el HTML a cambio.
A partir de ahí, analiza ese HTML buscando texto, encabezados y otro contenido legible. Muchos rastreadores de IA hacen esto sin renderizar la página como lo hace un navegador, lo que significa que, en general, trabajan con la respuesta HTML sin procesar y no con nada que se haya añadido a la página después.
Esa distinción importa más de lo que parece, y tiene su propia sección más adelante en este artículo.
Si sigue enlaces hacia el interior del sitio
Una vez leída la página, un rastreador normalmente mira los enlaces que contiene y decide si seguir alguno hacia otras páginas del mismo sitio.
Así descubre páginas de las que nadie le habló directamente, siguiendo un rastro de enlaces internos desde páginas que ya conoce. Una página a la que no apunta ningún enlace desde el resto del sitio puede resultar mucho más difícil de encontrar para un rastreador por sus propios medios.
Los rastreadores de IA que probablemente verás
Un puñado de rastreadores con nombre propio explica la mayor parte de lo que verá un sitio de pequeña empresa en sus registros del servidor o en sus informes de acceso de rastreadores. Estos ejemplos ilustran lo que documenta cada empresa, y conviene consultar directamente sus páginas, ya que los nombres y las políticas cambian.
Nombre del rastreador | Operado por | Propósito documentado |
|---|---|---|
GPTBot | OpenAI | Rastrea páginas que pueden usarse para los fines documentados de OpenAI, incluido el entrenamiento de modelos |
ClaudeBot | Anthropic | Rastrea páginas en nombre de Anthropic, según se describe en su información publicada sobre rastreadores |
PerplexityBot | Perplexity | Rastrea páginas de las que las respuestas de Perplexity pueden extraer información o citarla |
Google-Extended | Controla si el contenido de un sitio puede usarse para las apps de Gemini y funciones generativas relacionadas, por separado del rastreo habitual de Búsqueda de Google |
Estas descripciones resumen lo que cada empresa declara públicamente; consulta su propia documentación para conocer la redacción actual y oficial.
Bloquear o permitir cualquiera de estos rastreadores no cambia el hecho de que Googlebot pueda seguir rastreando y posicionando tu sitio en la búsqueda habitual. Cada rastreador sigue su propia regla en robots.txt, y son independientes entre sí.
Antes de decidir algo sobre cualquiera de ellos, conviene saber qué permite tu sitio actualmente. El Comprobador de rastreadores de IA gratuito de RepGet prueba si GPTBot, ClaudeBot y PerplexityBot pueden llegar actualmente a un sitio determinado.
Qué le indica a un rastreador qué páginas leer
Un rastreador no conoce de antemano la estructura de tu sitio. Se apoya en un pequeño conjunto de señales para saber qué está permitido y dónde está todo.
Tu archivo robots.txt
Es la capa de permisos. Indica a un rastreador qué rutas puede solicitar y cuáles debe dejar en paz, y puede hacerlo rastreador por rastreador si es necesario.
Nuestra guía para crear un archivo robots.txt seguro para Google y la IA explica la sintaxis con más detalle, incluido cómo permitir o bloquear un rastreador de IA concreto sin tocar las reglas que se aplican a los buscadores.
Tu sitemap XML
Un sitemap es una lista de tus páginas, normalmente en una dirección como tusitio.com/sitemap.xml, que da al rastreador un índice directo de lo que existe, en lugar de depender solo de seguir enlaces para encontrarlo.
No obliga a rastrear nada y no es una señal de posicionamiento. Solo hace que el descubrimiento sea más rápido y completo. El Comprobador y buscador de sitemaps gratuito de RepGet puede confirmar que un sitemap existe y es válido.
Los enlaces internos entre tus páginas
Una página sin enlaces internos que apunten a ella es más difícil de encontrar para cualquier rastreador, de IA o no. Si tu página de servicio más nueva solo se puede llegar a través del buscador de tu propio sitio, un rastreador que sigue enlaces no tiene forma de topar con ella.
Enlazar a las páginas importantes desde tu página de inicio, el menú de navegación o los artículos relacionados le da a los rastreadores un camino evidente que seguir.
llms.txt: una señal nueva y opcional
llms.txt es un formato de archivo nuevo y propuesto, documentado en llmstxt, que pretende ofrecer a los sistemas de IA un resumen breve y estructurado de las páginas más importantes de un sitio, en lenguaje sencillo.
No es un estándar que todos los rastreadores de IA estén documentados para leer, y no sustituye a robots.txt ni a un sitemap. Es una señal adicional que algunos negocios deciden añadir. El Generador de llms.txt gratuito de RepGet puede crear uno a partir de las páginas existentes de un sitio para los negocios que quieran probarlo.
Los bloqueos accidentales que mantienen fuera a los rastreadores de IA
La mayoría de los sitios que bloquean un rastreador de IA no lo pretendían. La regla se escribió por otro motivo, o se añadió por defecto, y nadie se dio cuenta de lo que más estaba capturando.
Una regla sobrante o demasiado amplia en robots.txt
Una regla escrita para bloquear un solo rastreador puede acabar bloqueando varios, sobre todo si está bajo un bloque general User-agent: * en lugar de uno escrito para un rastreador específico por su nombre.
Esto también ocurre cuando la regla Disallow: / de un sitio de pruebas (staging) se copia al dominio en vivo durante el lanzamiento y nadie la elimina. Todos los rastreadores leen esa regla de la misma manera, sean de IA o no.
La solución es dar a cada rastreador que quieras tratar de forma distinta su propio bloque con nombre, para que una regla pensada para uno no se aplique en silencio a todos. Nuestra guía sobre cómo crear un archivo robots.txt seguro explica paso a paso la sintaxis para hacerlo correctamente.
Un cortafuegos o un plugin de seguridad que bloquea por defecto
Los plugins de seguridad y los cortafuegos a nivel de alojamiento suelen traer una opción que bloquea automáticamente los user-agents desconocidos, con la lógica razonable de que la mayoría de los bots no reconocidos son scrapers o algo peor.
Desde el punto de vista del cortafuegos, un rastreador de IA puede parecer exactamente ese tipo de tráfico. Es un programa que hace peticiones repetidas desde una dirección que el cortafuegos no reconoce, justo el patrón que muchas de estas herramientas están diseñadas para frenar.
El resultado es un rastreador que está permitido por completo en robots.txt pero que nunca llega a entrar, porque algo más abajo en la pila rechaza la petición antes de que se consulte robots.txt. Este tipo de bloqueo no aparece al leer robots.txt, por eso merece la pena probar el acceso directamente en lugar de limitarse a revisar las reglas.
Contenido detrás de un inicio de sesión o de un muro de pago
Las páginas que exigen un inicio de sesión, una membresía o incluso una dirección de correo antes de cargar el contenido son invisibles para un rastreador, de la misma forma que lo son para un visitante que no ha iniciado sesión.
A veces es intencionado, y es una decisión razonable para contenido realmente restringido. Se convierte en un problema cuando una empresa no se da cuenta de que una página que quiere que la encuentren, como una página de precios o una guía de recursos, está tras una barrera que se añadió por un motivo no relacionado.
Error | Qué provoca en el rastreo | Cómo comprobarlo |
|---|---|---|
Regla de robots.txt demasiado amplia | Bloquea un rastreador de IA junto con otros bajo una regla compartida | Lee el archivo robots.txt en vivo y comprueba a qué rastreadores afecta cada bloque |
Cortafuegos o plugin que bloquea bots desconocidos | Rechaza la petición del rastreador antes de que se lea robots.txt | Prueba el acceso real con un comprobador en lugar de leer solo las reglas |
Contenido detrás de un inicio de sesión o de un muro de pago | Impide que cualquier rastreador lea la página restringida | Confirma si las páginas que quieres que encuentren requieren antes un inicio de sesión |
Limitación de velocidad agresiva | Trata las peticiones repetidas del rastreador como un ataque y bloquea el origen | Revisa los registros del servidor o del cortafuegos en busca de peticiones bloqueadas de rastreadores conocidos por su nombre |
El Comprobador de Robots.txt y el Comprobador de Rastreadores de IA gratuitos de RepGet prueban el acceso real en lugar de limitarse a leer las reglas, lo que detecta los bloqueos a nivel de cortafuegos que un archivo de texto simple no revela.
Por qué las páginas con mucho JavaScript son un punto ciego habitual
Una página puede verse completa en el navegador y, aun así, estar casi vacía para un rastreador que nunca ejecutó los scripts que la completan.
Lo que ve un rastreador frente a lo que ve un visitante
Muchos rastreadores de IA leen el HTML bruto que envía el servidor, sin ejecutar el JavaScript que el navegador corre después para construir el resto de la página.
Un visitante abre una página de producto y ve una descripción completa, una tabla de precios y un conjunto de reseñas. Si parte de ese contenido solo aparece después de que se ejecuta un script que carga datos de otro lugar y los inserta en la página, un rastreador que no ejecuta ese script puede no ver nada de ello. Solo ve lo que ya estaba en el HTML antes de que se disparara el script.
Esto es fácil de pasar por alto porque, al comprobar la página uno mismo, nada parece estar mal. Usas un navegador, y el navegador ejecuta los scripts. El rastreador no, y esa es toda la diferencia.
Una forma rápida de comprobar qué hay realmente en el HTML
La comprobación más sencilla es ver el HTML fuente de la página directamente, en lugar de lo que se muestra en pantalla, y buscar el texto concreto que esperas que un rastreador lea.
Si una descripción, un precio o un dato clave solo aparece en la página renderizada y no en el código fuente, ese es el contenido que un rastreador que depende de JavaScript probablemente no verá. El Comprobador de Visibilidad HTML para LLM gratuito de RepGet hace esta comprobación por ti, y muestra qué parte del texto de una página está realmente presente en el HTML que recibe un rastreador.
Hacer tu contenido legible, no solo rastreable
Lograr que un rastreador supere robots.txt y llegue a la página es solo la mitad del trabajo. Lo que hay en la página también tiene que ser algo que pueda leer y usar.
Pon los datos clave en texto, no solo en imágenes
Una foto de una carta, una lista de precios escaneada o un gráfico con las zonas de servicio se ven bien para un visitante, pero no contienen texto legible para un rastreador, que no puede leer palabras incrustadas en una imagen.
La solución no es quitar la imagen. Es escribir también la misma información como texto plano en algún lugar de la página, para que el dato exista en una forma que un rastreador pueda procesar.
Usa encabezados claros que describan el contenido
Los encabezados que dicen lo que realmente contiene una sección, en lugar de algo vago o ingenioso, facilitan que cualquier sistema que lea la página entienda de qué trata cada parte.
Un encabezado como "Nuestros precios" le dice a un rastreador exactamente qué sigue. Un encabezado como "Lo que te cuesta" puede sonar mejor para una persona, pero da menos información a un sistema de análisis.
Evita ocultar información esencial tras clics
El contenido que solo aparece cuando el visitante hace clic en una pestaña, despliega un acordeón o avanza por un formulario de varios pasos puede ser invisible para un rastreador que no interactúa con la página como lo haría una persona.
Si un dato es lo bastante importante como para que quieras que lo encuentren, normalmente debe estar en texto presente en la página desde el principio, no detrás de un clic adicional. El Comprobador de Metaetiquetas gratuito de RepGet puede confirmar qué hay en el título, la descripción y otras etiquetas de la página que tanto los buscadores como los sistemas de IA suelen leer primero.
Rastreo, indexación y aparición en una respuesta son tres cosas distintas
Es fácil suponer que, una vez que un rastreador puede llegar a una página, lo demás sigue automáticamente. No es así. Son tres pasos separados, y superar uno no garantiza el siguiente.
Etapa | Qué significa | Qué no garantiza |
|---|---|---|
La página es rastreada | Un rastreador pidió y leyó correctamente el HTML de la página | Que el contenido se haya guardado, indexado o usado para algo después |
El contenido es indexado o referenciado | El sistema conserva o puede usar información de la página | Que la página vaya a citarse o mencionarse en una respuesta concreta |
El negocio aparece nombrado en una respuesta | Un prompt concreto produjo una respuesta que menciona el negocio | Que el mismo prompt o uno parecido vuelva a dar el mismo resultado |
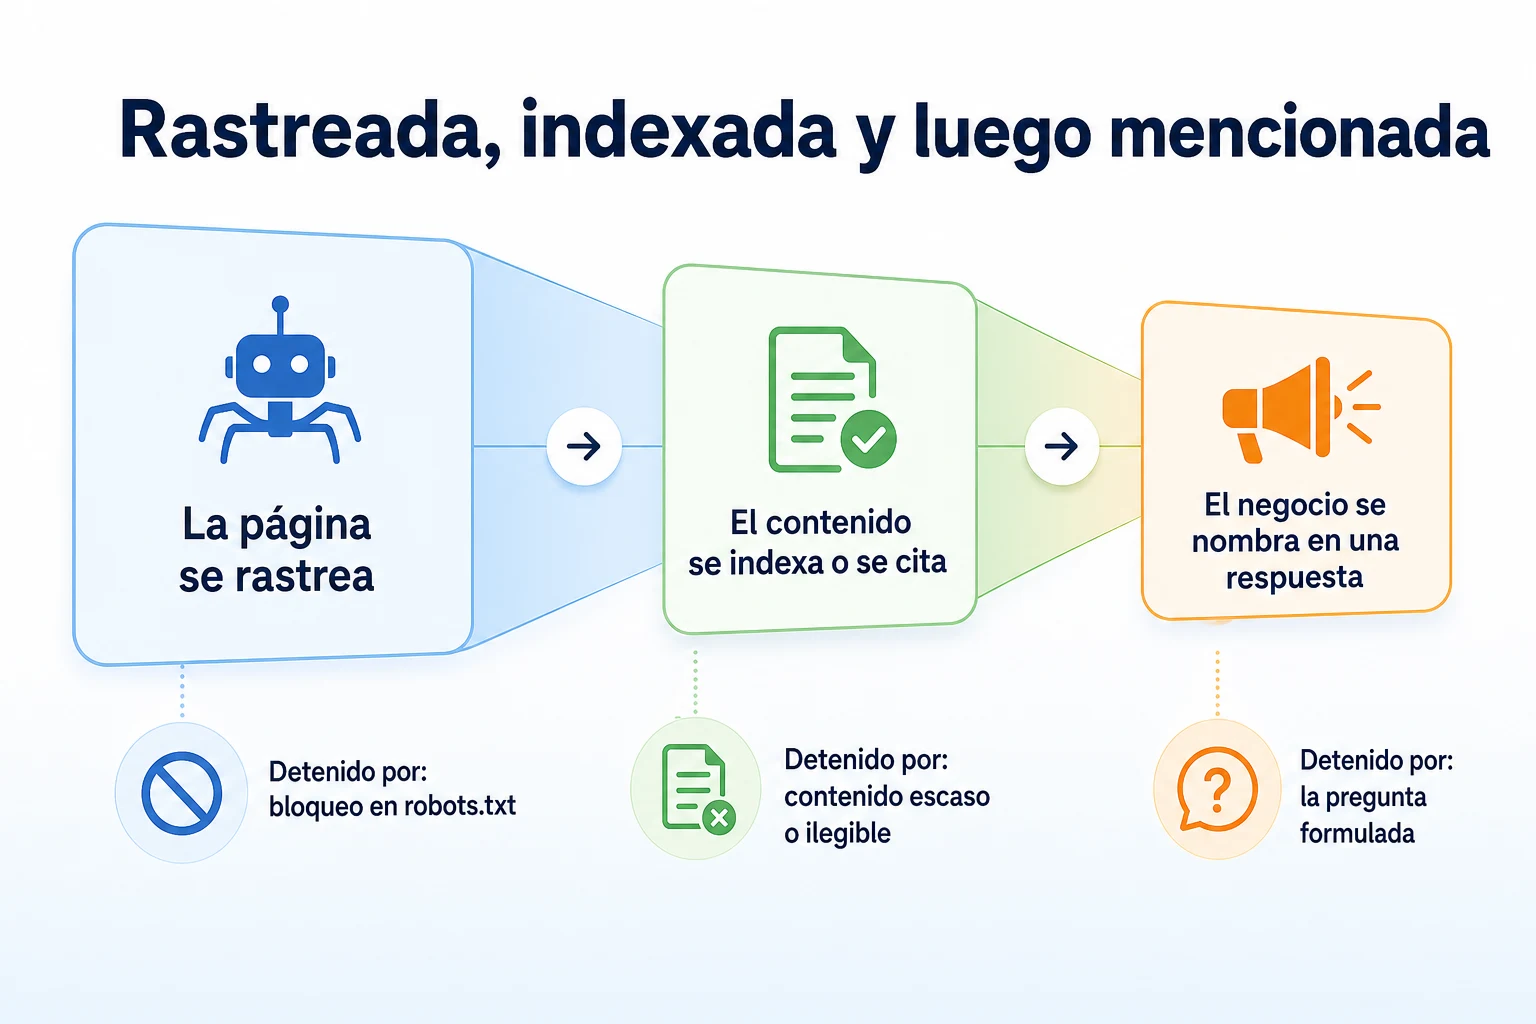
Una página puede ser rastreada sin volver a ser referenciada nunca, igual que Googlebot puede rastrear una página que nunca posiciona por nada útil. Que un negocio aparezca nombrado en una respuesta de IA concreta depende en gran medida de la pregunta formulada, del asistente utilizado y de información sobre la que el negocio no tiene ningún control.
Nuestra guía sobre cómo aparecer mencionado en ChatGPT y nuestra explicación de cómo los asistentes de IA deciden qué negocios recomendar profundizan en lo que ocurre después de que una página es legible, y en lo que escapa al control de cualquiera una vez que lo es.
Un ejemplo práctico: seguimos una página a través de los ojos de un rastreador web con IA
Imagine una empresa de jardinería con una página de servicio de cuidado de césped en una dirección como example.com/services/lawn-care. Este ejemplo es ilustrativo.
GPTBot solicita la página. Primero consulta el archivo robots.txt, no encuentra ninguna regla que lo mencione ni que bloquee la ruta, y la solicitud continúa.
El rastreador no encontró esta página siguiendo un enlace desde la página de inicio. No hay ninguno. Encontró la URL en el mapa del sitio, que es el único motivo por el que sabía que la página existía.
Una vez cargada la página, el rastreador lee el HTML que recibe. La descripción del servicio está en párrafos sencillos, justo ahí en el código fuente. Lo mismo ocurre con los encabezados: «Servicios de cuidado de césped», «Zonas de servicio que cubrimos» y «Qué incluye». Todo eso se lee sin ningún problema.
Más abajo en la página hay una tabla de precios. En la web en vivo, el visitante hace clic en una pestaña llamada «Precios» y un script carga el contenido de la tabla un momento después.
El rastreador nunca hace clic en nada. Lee lo que ya estaba presente en el HTML cuando la página se cargó por primera vez, y la tabla de precios todavía no estaba. Según este rastreador, la página no tiene información de precios, aunque cada visitante que hace clic en la pestaña la ve con claridad.
Nadie creó esa pestaña para ocultar nada a un rastreador. Se hizo para mantener la página ordenada. El efecto sobre un rastreador de IA nunca formó parte de la decisión.
Lista de verificación de 20 minutos para confirmar que tu sitio es rastreable
Conviene hacerla después de cualquier cambio en el sitio, como un nuevo plugin, una actualización del tema o un cambio de proveedor de alojamiento, ya que cualquiera de estos puede modificar en silencio las reglas de las que depende un rastreador.
Paso | Qué revisar | Tiempo |
|---|---|---|
1. Lee el archivo robots.txt en vivo | Confirma que no hay un bloqueo general ni una regla que cubra por accidente más rastreadores de los previstos | 3 minutos |
2. Prueba el acceso de los rastreadores de IA por nombre | Confirma que GPTBot, ClaudeBot y PerplexityBot están permitidos o bloqueados a propósito, no por accidente | 3 minutos |
3. Confirma que el mapa del sitio es válido | Revisa que incluya tus páginas actuales y que cargue sin errores | 3 minutos |
4. Mira el código fuente de las páginas clave | Confirma que las descripciones, los precios y otros datos clave aparecen realmente en el HTML sin procesar, no solo en la página renderizada | 5 minutos |
5. Revisa la configuración del cortafuegos o del plugin de seguridad | Confirma que los user-agents de rastreadores desconocidos no están bloqueados por defecto | 3 minutos |
6. Confirma que las páginas públicas no están detrás de un inicio de sesión | Revisa que las páginas que deben encontrarse carguen sin iniciar sesión ni introducir un correo electrónico | 3 minutos |
Veinte minutos bastan para detectar la mayoría de los bloqueos accidentales que trata este artículo. Las herramientas gratuitas de RepGet, el Comprobador de rastreadores de IA, el Comprobador de robots.txt, el Comprobador y buscador de mapas del sitio y el Comprobador de visibilidad HTML para LLM, pueden agilizar la mayoría de estos pasos en lugar de revisarlos uno a uno a mano.
Dónde encaja RepGet
Averiguar qué rastreador puede llegar a qué página, y qué datos están realmente en el HTML sin procesar, es un trabajo detallado y algo técnico que es fácil de postergar.
La auditoría web gratuita de RepGet rastrea un sitio, le asigna una puntuación SEO de 0 a 100 y enumera los problemas técnicos y de contenido que vale la pena investigar, lo que puede revelar un problema en robots.txt o una página con poco contenido junto con otras cosas que conviene corregir en la misma visita. Su Comprobador de rastreadores de IA gratuito comprueba si GPTBot, ClaudeBot y PerplexityBot pueden acceder actualmente a un sitio determinado, y su Comprobador de visibilidad HTML para LLM gratuito muestra qué parte del texto de una página está realmente presente en el HTML que recibe un rastreador. No se necesita cuenta ni tarjeta de crédito para ninguno de ellos.
Ninguna de estas herramientas puede decirte si un asistente de IA concreto mencionará tu negocio en una respuesta específica, y RepGet no garantiza que lo haga. Lo que sí pueden hacer es mostrarte en unos minutos si el acceso y el contenido están presentes en primer lugar, que es la parte que un negocio realmente controla.
En resumen
Un rastreador web con IA no es misterioso una vez que se desglosa. Consulta robots.txt, solicita la página, lee el HTML que recibe y, a veces, sigue un enlace a la siguiente.
La mayoría de lo que mantiene alejados a estos rastreadores no es deliberado. Una regla antigua en robots.txt, un cortafuegos que bloquea bots desconocidos por defecto, un muro de inicio de sesión añadido por un motivo no relacionado, o un dato que solo aparece después de un clic o de un script, todo ello puede impedir en silencio que un rastreador vea contenido que un visitante ve sin dificultad.
Solucionarlo es cuestión de acceso y de contenido claro y legible, no una garantía de nada más. Que un sitio sea rastreado no garantiza que sea indexado, y que sea indexado no garantiza que se le mencione en una respuesta concreta de IA. Esos últimos pasos dependen de mucho más de lo que un solo sitio web puede controlar.
Averigua primero qué necesita tu sitio web
Antes de buscar un ajuste concreto para un rastreador, mira qué permite hoy tu sitio y dónde su contenido podría quedarse corto. Haz una auditoría web gratuita con RepGet para revisar la configuración técnica de tu sitio junto con su contenido. No se necesita cuenta ni tarjeta de crédito.
Preguntas frecuentes
¿Qué es un rastreador web con IA?
Es un software automatizado, como GPTBot o ClaudeBot, que solicita páginas de un sitio web para reunir texto con los fines documentados de una empresa de IA, como entrenar un modelo o basar las respuestas de un asistente en información actual.
¿Cómo sé si el rastreador de ChatGPT ha visitado mi sitio?
Revisa los registros de tu servidor en busca de solicitudes de GPTBot, o usa una herramienta de comprobación que pruebe si GPTBot puede acceder hoy a tu sitio. Los registros muestran las visitas reales que ya ocurrieron; una herramienta de comprobación muestra si el acceso está permitido en este momento.
¿Puedo bloquear los rastreadores de IA sin bloquear Google?
Sí. Asigna a cada rastreador su propio bloque
User-agentcon nombre en robots.txt, para que una regla escrita para un rastreador de IA no afecte por accidente a Googlebot ni a otro rastreador.¿JavaScript impide que los rastreadores de IA lean mi sitio?
Muchos rastreadores de IA leen el HTML sin procesar que envía el servidor, sin ejecutar JavaScript como lo hace un navegador. El contenido que solo aparece después de ejecutarse un script puede ser invisible para ellos, aunque los visitantes sí lo vean bien.
¿Por qué mi negocio no aparece en ChatGPT si Google puede rastrear mi sitio?
Googlebot y los rastreadores de IA siguen reglas separadas y pueden permitirse o bloquearse de forma independiente. Además, que una página sea rastreada no garantiza que sea citada ni mencionada en una respuesta de IA concreta.
¿Necesito un archivo llms.txt para los rastreadores de IA?
No. Es un archivo opcional y más reciente, y no todos los rastreadores de IA están documentados como lectores de este archivo. No reemplaza a robots.txt ni a un mapa del sitio, que siguen siendo las señales principales en las que confían los rastreadores.
¿Con qué frecuencia visitan los rastreadores de IA un sitio web?
Depende del rastreador y del sitio, y las empresas no publican un calendario fijo. Revisar los registros de tu servidor a lo largo del tiempo es la única forma fiable de ver con qué frecuencia visita tu sitio un rastreador concreto.
¿GPTBot es lo mismo que Googlebot?
No. Son operados por empresas distintas para fines distintos. GPTBot es el rastreador de OpenAI, Googlebot rastrea para la Búsqueda de Google, y cada uno sigue sus propias reglas separadas en robots.txt.