

Motores de búsqueda: cómo funcionan en realidad, explicado de forma sencilla
Respuesta corta
Los motores de búsqueda funcionan en tres etapas. El rastreo encuentra tus páginas siguiendo enlaces, la indexación guarda y organiza de qué tratan esas páginas, y el posicionamiento decide qué páginas indexadas responden mejor a una búsqueda concreta. Google y Bing documentan públicamente este proceso, y asistentes de IA como ChatGPT se nutren en buena parte del mismo contenido rastreado. Por eso sigue importando que tu sitio sea rastreable y esté bien escrito.
Un propietario de negocio busca el nombre de su propia empresa.
Pasa de largo dos competidores y luego encuentra su propia web en la segunda página.
No tiene ni idea de por qué Google la ha puesto ahí, ni de qué tendría que cambiar para subir.
La mayoría de consejos sobre esto van directos a las tácticas: añadir palabras clave, conseguir backlinks, escribir más artículos de blog. Ninguno explica qué está pasando realmente por dentro, así que es difícil saber qué táctica importa y cuál es solo ruido.
Los motores de búsqueda no son un proceso único. Son tres trabajos distintos, realizados en orden, y la mayoría de consejos confusos que hay por ahí son, en realidad, consejos dirigidos a uno de esos tres trabajos sin decirlo. Así es como funcionan realmente el rastreo, la indexación y el posicionamiento, en términos sencillos, y por qué entender el orden explica la mayoría de las preguntas de «¿por qué no funciona esto?» que se hace una pequeña empresa.
Qué hace realmente un motor de búsqueda
Un motor de búsqueda es un software diseñado para realizar tres trabajos separados, uno tras otro. Si se omite cualquiera de ellos, nada de lo que viene después ocurre, por muy buena que sea tu web.
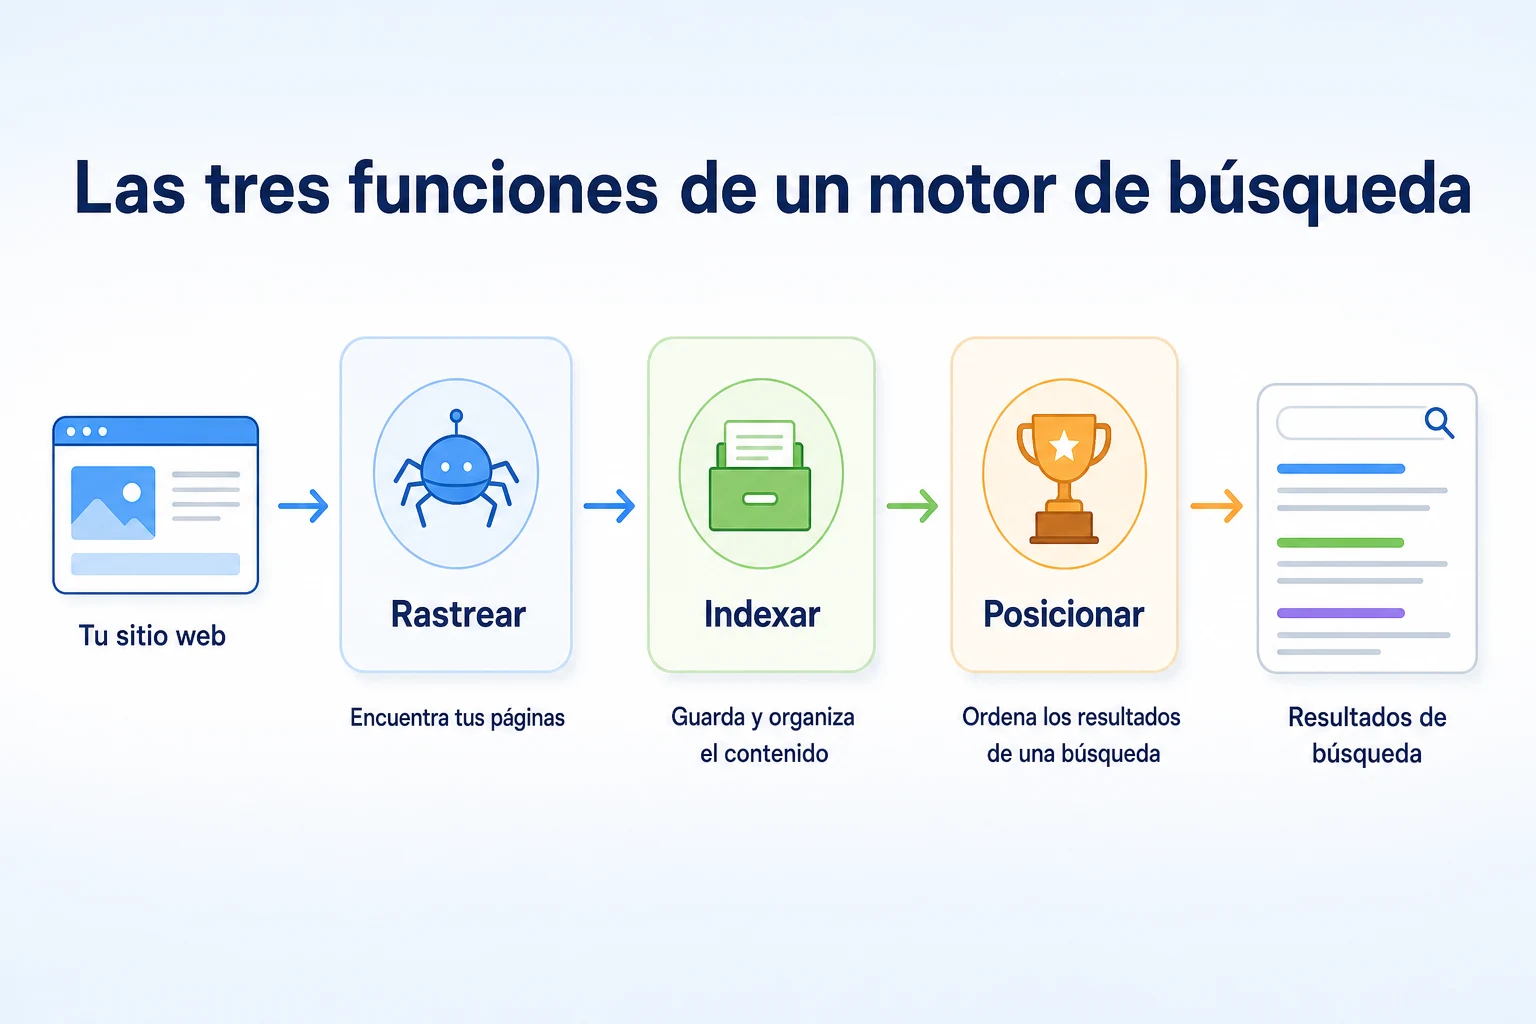
Los tres trabajos: rastrear, indexar, posicionar
El primer trabajo es el rastreo: encontrar páginas que existen en la web. El segundo es la indexación: leer esas páginas y guardar un registro organizado de lo que contienen. El tercero es el posicionamiento: cuando alguien busca algo, decidir qué páginas guardadas mostrar y en qué orden.
Una forma sencilla de imaginarlo: rastrear es un bibliotecario que recorre una ciudad recogiendo todos los libros que encuentra. Indexar es ese bibliotecario leyendo cada libro y archivándolo por tema. Posicionar es lo que ocurre en el momento en que un visitante pide un libro sobre un tema concreto, y el bibliotecario saca de la estantería las mejores coincidencias.
Por qué el orden importa más que cualquier truco
Estos tres trabajos se producen en secuencia, y cada uno depende del anterior. Una página que nunca fue rastreada no puede indexarse. Una página que nunca fue indexada no puede posicionarse para nada, por muy bien escrita que esté. Por eso muchos consejos de SEO que parecen tratar de escribir mejor contenido solo son útiles una vez que el rastreo y la indexación ya funcionan.
También explica por qué dos negocios pueden seguir el mismo consejo y obtener resultados distintos. Uno puede tener un problema de rastreo oculto bajo todo lo demás, de modo que una mejor redacción nunca llega a importar. El otro puede tener el rastreo y la indexación funcionando bien, así que la redacción es realmente lo siguiente que hay que mejorar. Mismo consejo, distinto punto de partida.
Rastreo: cómo encuentran los buscadores las webs nuevas o modificadas
El rastreo es la fase de descubrimiento. Antes de que un motor de búsqueda pueda hacer algo con tu web, alguien tiene que encontrarla primero.
Cómo un rastreador encuentra una página que nunca ha visto
Un motor de búsqueda usa programas automáticos, a menudo llamados rastreadores o arañas, que se desplazan de página en página siguiendo enlaces. El rastreador propio de Google se llama Googlebot. Parte de páginas que ya conoce, sigue los enlaces de esas páginas hasta otras nuevas y repite el proceso constantemente. Una página nueva suele encontrarse de dos maneras: mediante un enlace desde algún lugar que Googlebot ya visita, o mediante un mapa del sitio que enumera la página directamente y se la indica al rastreador.
Esto significa que una página sin enlaces que apunten a ella y sin mención en un mapa del sitio puede permanecer en tu web indefinidamente sin que ningún rastreador llegue a encontrarla. No está siendo rechazada. Simplemente nunca se ha descubierto.
Qué puede bloquear a un rastreador antes de que empiece
Un puñado de problemas comunes de configuración bloquean a un rastreador por completo. Un archivo robots.txt puede indicar explícitamente a un rastreador que se mantenga alejado de una página o de una sección entera del sitio. Una página puede llevar una instrucción noindex que le dice al motor de búsqueda que no la conserve aunque sea rastreada. Una estructura de enlaces internos rota, donde una página existe pero nada más en el sitio enlaza a ella, deja al rastreador sin camino que seguir. La documentación propia de Google sobre cómo rastrea Googlebot un sitio explica exactamente qué busca y qué puede interponerse en su camino.
Comprobar si un rastreador puede llegar a tu web
No necesitas adivinarlo. Nuestro Comprobador de Robots.txt gratuito lee el archivo robots.txt de tu web y da un veredicto claro sobre si los rastreadores de búsqueda y de IA tienen permiso para entrar, en lugar de dejarte interpretar las reglas del archivo por tu cuenta. Tarda un par de minutos y responde a la pregunta más básica de todo este proceso: ¿puede algo siquiera entrar por la puerta?
Indexación: cómo los motores de búsqueda deciden de qué trata una página
Una vez encontrada una página, todavía tiene que ganarse un lugar en el índice. Ser rastreada y ser indexada son dos resultados distintos, y confundirlos causa mucha preocupación innecesaria.
Por qué «rastreada» no significa «indexada»
Un motor de búsqueda puede visitar una página, leerla y, aun así, decidir no guardarla en su índice. Esto ocurre por muchas razones: el contenido es demasiado escaso para merecer almacenarse, es casi un duplicado de otra página del mismo sitio o se bloqueó su indexación aunque el rastreador pudiera técnicamente llegar a ella. Una página en este estado aparece en los registros del servidor como rastreada, pero no se muestra en absoluto en los resultados de búsqueda. Nuestra guía sobre cómo conseguir que Google indexe una web explica este vacío con más detalle, incluido cómo comprobar qué páginas tuyas han llegado realmente al índice.
Qué leen realmente los motores de búsqueda en una página
Cuando una página sí se indexa, un motor de búsqueda almacena algo más que las palabras que contiene. Lee el título de la página, los encabezados, el texto principal y el marcado de datos estructurados que describe qué es la página: un producto, un negocio local, una receta, un artículo. Un mapa del sitio también ayuda aquí, al ofrecer al motor de búsqueda una lista directa de las páginas del sitio que merecen revisarse, en lugar de depender por completo de los enlaces para encontrarlas. La documentación de Google sobre mapas del sitio explica qué hace uno y cuándo ayuda.
Aquí es también donde el contenido escaso o vago causa un problema real. Una página que dice casi nada concreto da al motor de búsqueda muy poco con lo que catalogarla, lo que dificulta que esa página aparezca para algo más allá de la búsqueda más genérica.
Posicionamiento: cómo los motores de búsqueda ordenan los resultados de una búsqueda
El posicionamiento es la última fase y es en la que la mayoría de la gente piensa primero. Solo ocurre entre las páginas que ya superaron las dos primeras fases.
Qué significa «relevancia» para un sistema de posicionamiento
Cuando alguien escribe una búsqueda, un sistema de posicionamiento compara esa búsqueda con todo lo que hay en el índice e intenta mostrar las páginas que mejor la responden. La documentación de Search Essentials de Google describe esto como una combinación de factores: cuánta relación tiene el contenido de una página con la búsqueda, qué tan fiable y útil parece la página, y señales de experiencia de página como la velocidad de carga y la usabilidad en móviles. No hay un único factor que decida la posición de un resultado. Es una combinación, aplicada de nuevo en cada búsqueda concreta.
Nuestra guía sobre cómo decide Google qué sitios posicionar recorre en detalle los factores documentados, y merece la pena leerla una vez que se confirma que el rastreo y la indexación funcionan, porque ahí es cuando los consejos de posicionamiento empiezan realmente a aplicar.
Por qué tu posición puede cambiar sin que toques tu web
La posición de una página en los resultados puede cambiar aunque no se modifique nada en esa página. Un competidor puede publicar una página más sólida sobre el mismo tema. Un motor de búsqueda puede actualizar cómo pondera una señal concreta. La redacción exacta de una búsqueda también puede cambiar lo que cuenta como la mejor respuesta, ya que «fontanero cerca de mí» y «fontanero de urgencias» pueden mostrar un orden de resultados distinto incluso para el mismo negocio. Nada de esto significa que algo se haya roto por tu parte. El posicionamiento es relativo a todo lo demás que compite por la misma búsqueda en ese momento, y esa competencia sigue moviéndose por sí sola, como se explica en la documentación de Search Essentials de Google.
Un ejemplo práctico: qué ocurre cuando alguien busca « plomero cerca de mí »
Las tres etapas se entienden mejor cuando se recorre una búsqueda real de principio a fin. Este ejemplo es ilustrativo, pero refleja el orden que se describió antes.
Cómo se relaciona la búsqueda con lo que ya está indexado
Imagínese un plomero en Austin que tiene una web con una página de inicio, una página de servicios y varias páginas específicas por ciudad, una de las cuales se centra en la fontanería de urgencia. Semanas antes de que alguien busque nada, Googlebot ya ha rastreado esas páginas siguiendo los enlaces internos y el mapa del sitio. Después, cada página entró en el índice, clasificada según de qué trata a partir de su título, sus encabezados y su texto, además de cualquier dato estructurado de negocio local que tenga el sitio.
Ahora alguien cercano busca « plomero cerca de mí » en su teléfono. Ninguno de los procesos de rastreo o indexación ocurre en este momento. Todo eso ya sucedió antes. Lo que ocurre ahora es el paso de posicionamiento: Google compara la ubicación de la persona y las palabras de la búsqueda con todo lo que ya está guardado en su índice, y decide qué páginas, de entre todas las webs de plomeros que ha almacenado para esa zona, responden mejor a esta búsqueda concreta en este momento.
Etapa | Qué ocurre en este ejemplo | Qué puede revisar una empresa |
|---|---|---|
Rastreo | Googlebot sigue un enlace o una entrada del mapa del sitio para encontrar la página de servicios de urgencia del plomero | Si la página está enlazada desde otras partes del sitio y aparece en el mapa del sitio |
Indexación | La página se guarda y se clasifica como « fontanería de urgencia, Austin » según su título y contenido | Si el título y el texto de la página dicen realmente qué servicio y qué zona cubre |
Posicionamiento | Google compara la ubicación y las palabras de la persona con cada página de plomería indexada cercana, y luego ordena los resultados | Lo completa y específica que es la página en comparación con las páginas de otros plomeros de la zona |
Estas cifras son ilustrativas.
Nuestra guía de SEO local para pequeñas empresas profundiza en lo que necesita una página como esta para competir por una búsqueda vinculada a una zona concreta, una vez confirmado que las piezas de rastreo e indexación están bien implantadas.
¿Funcionan Google, Bing y otros motores de búsqueda de la misma manera?
El modelo de tres etapas no es exclusivo de Google. Describe lo que un motor de búsqueda tiene que hacer a nivel estructural, y por eso Bing y otros motores siguen la misma forma básica, aunque sean sistemas independientes creados por empresas distintas.
Lo que está documentado como similar
Tanto Google como Bing publican guías que describen una secuencia de rastreo, indexación y posicionamiento. Ambos usan rastreadores automáticos que siguen enlaces y leen mapas del sitio. Los dos guardan lo que encuentran en un índice antes de mostrar nada a quien busca. Ambos aplican un paso de posicionamiento en el momento de la búsqueda, sopesando señales de relevancia y calidad en lugar de mostrar los resultados en un orden fijo. La estructura es lo bastante coherente como para que un consejo dirigido a una de las tres etapas, como corregir un bloqueo de rastreo o escribir un título de página más claro, tienda a ayudar en más de un motor de búsqueda a la vez.
Lo que cada motor mantiene en privado
En lo que se diferencian es en el detalle que ninguno publica por completo. El peso exacto de una señal concreta, es decir, cuánto importa un factor en relación con otro para una búsqueda determinada, no es público ni en Google ni en Bing. Cada empresa documenta las categorías de cosas que tiene en cuenta, no una fórmula. Es una decisión deliberada por su parte, no un vacío en este artículo.
Etapa | Bing | |
|---|---|---|
Rastreo | Usa Googlebot, que sigue enlaces y mapas del sitio, según documenta en su guía de rastreo | Usa Bingbot, que sigue enlaces y mapas del sitio, según documenta en sus directrices para webmasters |
Indexación | Guarda el contenido que considera valioso, teniendo en cuenta la calidad de la página y la duplicación | Guarda el contenido de forma similar, filtrando también las páginas pobres en contenido o duplicadas |
Posicionamiento | Sopesa categorías documentadas: relevancia, experiencia de página y fiabilidad | Sopesa sus propias categorías documentadas, incluidas la relevancia y la calidad de la página |
En la práctica, una pequeña empresa normalmente no necesita una estrategia distinta para cada motor de búsqueda. Corregir un bloqueo de rastreo o una página pobre en contenido suele ayudar con ambos a la vez, porque el problema de fondo es el mismo sea cual sea el motor que intenta leer la página.
¿Dónde encajan los asistentes de IA como ChatGPT en este panorama?
Los asistentes de IA añaden un cuarto nombre a esta conversación, pero no sustituyen al modelo de tres etapas. En la mayoría de los casos, dependen de él.
Lo que necesita un rastreador de IA para leer tu sitio
Algunos sistemas de IA ejecutan sus propios rastreadores, distintos de Googlebot o Bingbot, para recopilar contenido directamente de la web. Otros dependen más de un índice de búsqueda ya existente para encontrar y resumir información al responder una pregunta. En cualquier caso, el requisito básico no cambia: el rastreador que intervenga, sea cual sea, tiene que poder llegar a tu página y leer su texto real. Si una página está bloqueada en robots.txt, o si su contenido solo aparece después de que se ejecute un script en el navegador, un rastreador de IA puede encontrarse con el mismo muro que un rastreador de buscador. Nuestra guía sobre cómo un rastreador web de IA lee e indexa un sitio web explica con más detalle en qué consiste realmente ese acceso.
Por qué estar indexado y aparecer en una IA no son lo mismo
Que Google indexe una página no garantiza que un asistente de IA la mencione en sus respuestas, y a la inversa también es cierto. Son sistemas separados, creados y operados de forma independiente, y ninguna documentación oficial vincula la presencia de una página en el índice de Google con que un asistente de IA concreto la cite. Lo que sí se cumple en ambos casos es que una página tiene que ser legible y específica antes de que cualquiera de los dos pueda hacer algo útil con ella. Una página vaga y pobre en contenido da poco que clasificar a un motor de búsqueda y poco que resumir con precisión a un asistente de IA, por la misma razón de fondo.
¿Por qué tu sitio podría no aparecer? Relacionar el síntoma con la etapa
Una vez que sabes que hay tres etapas diferenciadas, la mayoría de las situaciones de « ¿por qué no funciona esto? » son más fáciles de resolver. El truco está en relacionar lo que realmente estás viendo con la etapa más probablemente responsable, en lugar de adivinar una solución antes de saber qué problema tienes.
Interpreta bien tus propios síntomas antes de empezar a corregir nada
Una búsqueda en el sitio como site:tudominio.com escrita en Google es una primera lectura rápida: si una página no aparece ahí en absoluto, conviene revisar el rastreo y la indexación antes de preocuparse por el posicionamiento. Una página que sí aparece en una búsqueda en el sitio pero nunca se muestra para un término de búsqueda relevante apunta a otro lugar, normalmente al contenido o al posicionamiento más que al acceso.
Lo que estás viendo | Etapa probable | Qué revisar primero |
|---|---|---|
La página no aparece ni con una búsqueda | Rastreo | Robots.txt, enlaces internos, si la página está en el mapa del sitio |
La página se publicó hace poco y sigue sin aparecer semanas después | Rastreo o indexación | Informe de cobertura de Search Console, envío del mapa del sitio |
La página aparece con una búsqueda | Posicionamiento | Contenido de la página, título y lo bien que coincide con lo que los usuarios escriben realmente |
La página solía posicionarse bien y hace poco ha caído | Posicionamiento | Nuevas páginas competidoras, una actualización de contenido en otra parte del sitio o un cambio amplio del algoritmo |
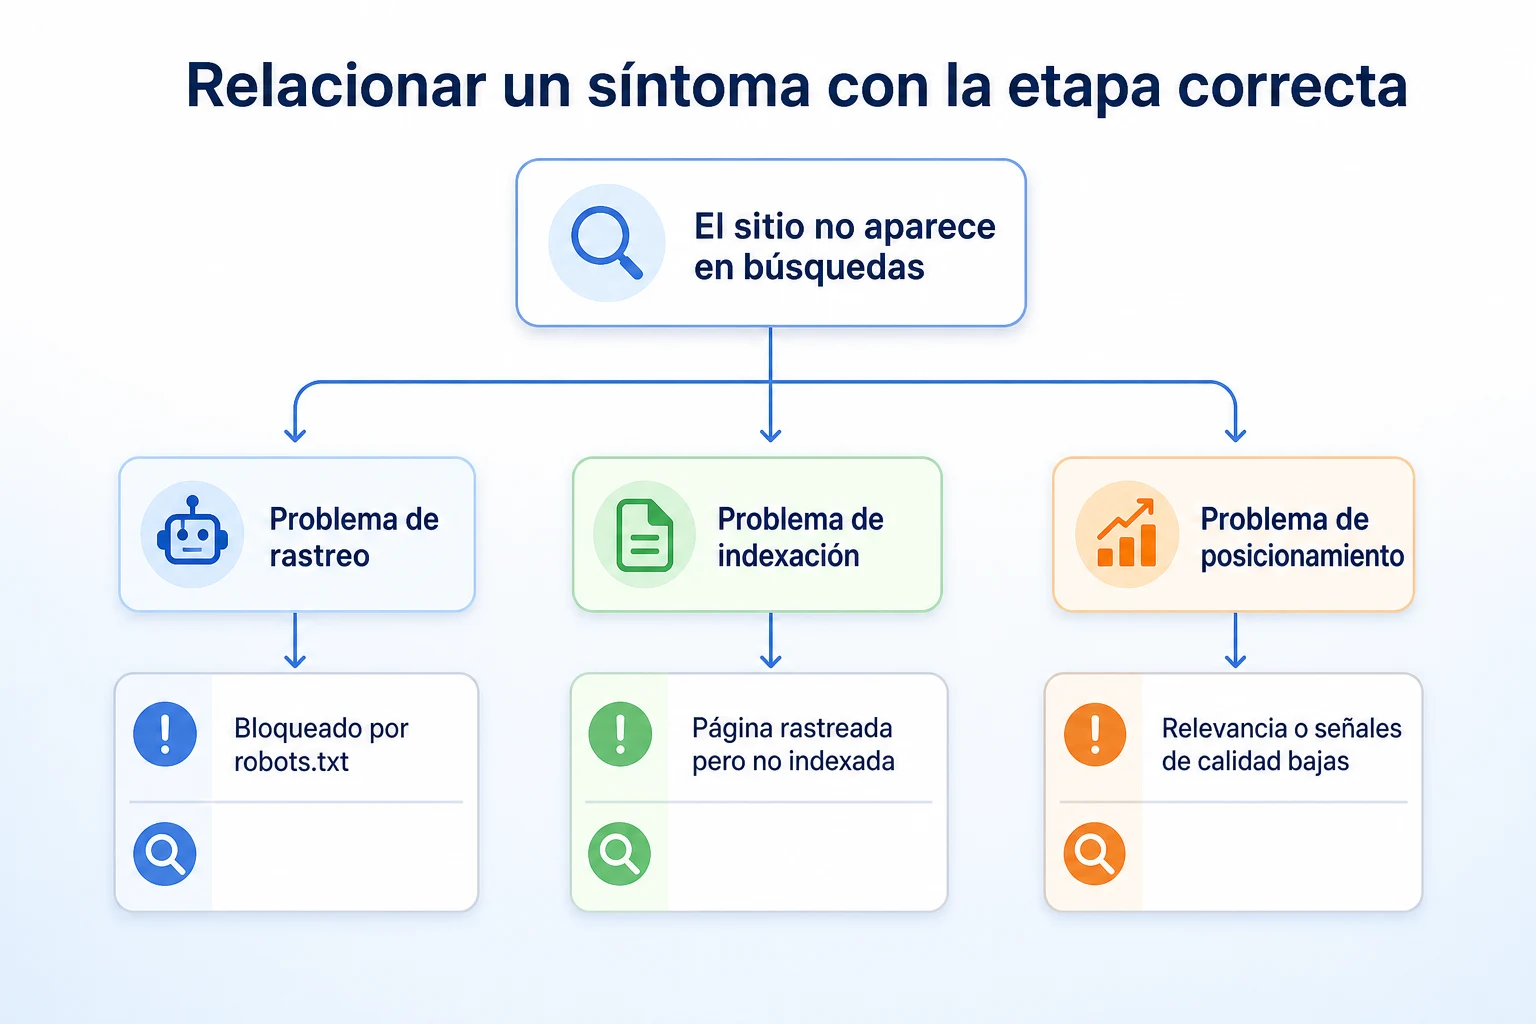
Unos minutos con nuestro Comprobador de Robots.txt gratuito descarta el problema de rastreo más básico en menos de un minuto, algo que conviene hacer antes de suponer que el fallo es algo más complicado más adelante en la cadena.
Una comprobación de 20 minutos para ver cómo los motores de búsqueda ven tu web actualmente
No necesitas conocimientos técnicos para hacerte una primera idea real de en qué punto está tu web. Veinte minutos y un navegador bastan para revisar las tres etapas, una a una.
Lo que necesitarás antes de empezar
Solo la dirección de la página de inicio de tu web y, si ya la tienes configurada, acceso a Google Search Console. Si no tienes Search Console conectada, aun así puedes hacer casi toda la comprobación; solo omitirás el paso que la necesita.
Paso | Tiempo | Qué te indica |
|---|---|---|
Busca | 3 minutos | Si tus páginas clave han llegado al índice |
Revisa tu web con el Robots.txt Checker | 5 minutos | Si un bloqueo de rastreo impide que los rastreadores de búsqueda o de IA empiecen siquiera |
Consulta el informe de Páginas o de Cobertura en Search Console | 7 minutos | Qué páginas ha rastreado, indexado o excluido Google, y por qué |
Busca la frase exacta por la que quieres que te encuentren | 5 minutos | Si una página indexada está posicionando realmente por el término que te importa |
Seguir estos cuatro pasos en orden refleja el propio modelo de tres etapas. Si los dos primeros pasos revelan un problema, no tiene mucho sentido dedicar aún tiempo al cuarto, ya que una mejora de posicionamiento no puede hacer nada por una página que nunca llegó a indexarse.
Malentendidos habituales sobre cómo funcionan los motores de búsqueda
Algunas ideas sobre los motores de búsqueda siguen circulando mucho después de dejar de ser precisas, si es que alguna vez lo fueron. Aclarar unas cuantas ahorra mucho esfuerzo inútil.
Invertir en Google Ads mejora tu posicionamiento orgánico. No es así. Los anuncios de pago y los resultados orgánicos proceden de sistemas separados dentro de Google, y gastar en uno no tiene ningún efecto documentado sobre el otro.
Repetir una palabra clave muchas veces en una página ayuda a posicionarla. Los motores de búsqueda leen para detectar el tema y la relevancia, no el número de palabras. Una página llena de la misma frase una y otra vez tiende a leerse peor para un visitante real, y el buscador no le da ningún crédito extra por la repetición.
Enviar un mapa del sitio garantiza que una página se indexe. Un mapa del sitio solo ayuda a que un buscador encuentre una página más rápido. Que esa página llegue realmente al índice depende de si supera el listón de calidad y originalidad descrito antes en este artículo.
Más páginas siempre significa más visibilidad en buscadores. Un gran número de páginas finas y casi duplicadas puede producir el efecto contrario, ya que ninguna de ellas da a un buscador motivo suficiente para indexarla o posicionarla por encima de las demás. Un número menor de páginas concretas y bien escritas suele funcionar mejor que muchas páginas vagas.
Compartir una página en redes sociales aumenta directamente su posicionamiento. Las publicaciones en redes pueden atraer visitas y, de forma indirecta, más enlaces con el tiempo, pero ningún factor de posicionamiento documentado considera el número de veces que se ha compartido como un factor que determine dónde aparece una página en los resultados.
Dónde encaja RepGet
RepGet no cambia cómo funcionan el rastreo, la indexación ni el posicionamiento, y usarlo no permite saltarse ninguna de las tres etapas descritas en este artículo. Lo que hace es ayudarte a ver en qué punto está realmente tu web respecto a ellas y a resolver los problemas que se interponen.
La auditoría web gratuita de RepGet rastrea tu web y le asigna una puntuación SEO de 0 a 100, señalando los problemas de rastreabilidad y de contenido que determinan si una página supera las dos primeras etapas: cosas como páginas que un rastreador no puede alcanzar, contenido escaso que un buscador tiene poco que indexar y carencias técnicas básicas. No se requiere cuenta ni tarjeta de crédito.
Más allá de la auditoría, RepGet reúne en un mismo flujo de trabajo la investigación de palabras clave, la planificación de contenidos, la redacción de artículos, la publicación y los informes de rendimiento en búsquedas procedentes de Google Search Console. Esto resulta útil una vez confirmados el rastreo y la indexación, cuando el trabajo pasa a centrarse en las señales de contenido y relevancia que afectan al posicionamiento. RepGet no controla el algoritmo de ningún buscador, y no garantiza un posicionamiento, una posición en Google Maps ni una mención en la respuesta de un asistente de IA.
En resumen
El trabajo de un motor de búsqueda se divide en tres etapas que se realizan en orden: el rastreo encuentra tus páginas, la indexación almacena y organiza lo que contienen, y el posicionamiento decide qué páginas indexadas responden mejor a una búsqueda concreta. Un problema en cualquiera de estas etapas puede mantener una web invisible, sin importar cuánto esfuerzo se dedique a las etapas posteriores.
Google y Bing documentan esta misma secuencia básica, aunque ninguno publica la ponderación exacta detrás de sus decisiones de posicionamiento. Los asistentes de IA se nutren en gran medida del mismo contenido rastreado, por eso seguir siendo legible y concreto sigue importando aunque cada vez más contenido llegue a las personas a través de una respuesta de chat en lugar de una página de resultados.
Una vez que sabes en qué etapa está un problema, el siguiente paso suele ser evidente, y muchos consejos que antes parecían contradictorios empiezan a tener sentido en su lugar adecuado.
Averigua primero qué necesita tu web
Antes de perseguir consejos de posicionamiento, averigua si tu web está siendo rastreada e indexada correctamente. Haz una auditoría web gratuita con RepGet para ver primero los problemas técnicos y de contenido que merece la pena corregir. No se requiere cuenta ni tarjeta de crédito.
Preguntas frecuentes
¿Cómo funcionan los motores de búsqueda en pocas palabras?
Un motor de búsqueda encuentra páginas rastreando enlaces, guarda y organiza lo que encuentra mediante la indexación, y después posiciona las páginas indexadas que mejor coinciden con una búsqueda concreta cuando alguien escribe una.
¿Cuál es la diferencia entre rastreo e indexación?
El rastreo es el momento en que un motor de búsqueda encuentra y visita una página. La indexación es un paso aparte en el que decide almacenar y archivar esa página, y no siempre ocurre, aunque la página se haya rastreado correctamente.
¿Por qué mi web no aparece en Google?
Normalmente se debe a una de tres cosas: un rastreador no puede llegar a la página, la página se rastreó pero no se indexó, o se indexó pero no se posiciona bien para las palabras que estás revisando.
¿Todos los motores de búsqueda usan el mismo sistema de posicionamiento?
No. Google, Bing y otros tienen cada uno su propio sistema de posicionamiento, con una ponderación propia que no hacen pública, aunque todos documentan la misma estructura básica de rastreo, indexación y posicionamiento por debajo.
¿Cómo encuentra ChatGPT información sobre un negocio?
Depende del sistema. Algunos asistentes de IA usan sus propios rastreadores para recopilar contenido web directamente, mientras que otros se apoyan más en índices de búsqueda existentes, pero ambos necesitan poder leer el texto real de una página.
¿Cuánto tarda Google en rastrear una web nueva?
No hay un plazo fijo, y Google no ha documentado una velocidad garantizada. Un mapa del sitio y enlaces internos desde páginas que Google ya visita pueden ayudar a que una página nueva se encuentre antes.
¿Se puede pagar a un motor de búsqueda para que rastree o indexe una página más rápido?
No. Los anuncios de pago funcionan por un sistema separado del rastreo, la indexación y el posicionamiento orgánicos, y no existe ninguna forma documentada de pagar para que una página se incluya más rápido o con garantía en el índice orgánico.