

Suchmaschinen: So funktionieren sie wirklich, einfach erklärt
Kurze Antwort
Suchmaschinen arbeiten in drei Schritten. Crawling findet Ihre Seiten, indem es Links folgt. Indexierung speichert und ordnet, worum es auf diesen Seiten geht, und Ranking entscheidet, welche indexierten Seiten eine bestimmte Suche am besten beantworten. Google und Bing dokumentieren diesen Ablauf öffentlich, und KI-Assistenten wie ChatGPT greifen auf große Teile derselben gecrawlten Inhalte zurück. Deshalb ist eine crawlbare, gut geschriebene Website weiterhin wichtig.
Ein Unternehmer sucht nach dem eigenen Firmennamen.
Er scrollt an zwei Konkurrenten vorbei und findet dann die eigene Website auf Seite zwei.
Warum Google sie dort einordnet, weiß er nicht. Und er weiß auch nicht, was er ändern müsste, um nach oben zu kommen.
Die meisten Ratschläge dazu springen direkt zu Taktiken: Keywords ergänzen, Backlinks sammeln, mehr Blogbeiträge schreiben. Keiner davon erklärt, was im Hintergrund tatsächlich passiert. Deshalb ist schwer zu erkennen, welche Taktik wirklich zählt und welche nur Ballast ist.
Suchmaschinen sind kein einzelner Prozess. Es sind drei getrennte Aufgaben, die nacheinander erledigt werden. Der größte Teil der verwirrenden Ratschläge zielt in Wahrheit nur auf eine dieser drei Aufgaben, ohne das zu sagen. Hier erfahren Sie, wie Crawling, Indexierung und Ranking tatsächlich funktionieren, in einfachen Worten, und warum das Verständnis der Reihenfolge die meisten Fragen der Art „Warum funktioniert das nicht?“ erklärt, mit denen ein kleines Unternehmen zu tun hat.
Was eine Suchmaschine wirklich macht
Eine Suchmaschine ist eine Software, die drei getrennte Aufgaben nacheinander erledigt. Fällt eine davon weg, passiert danach nichts mehr, egal wie gut Ihre Website ist.
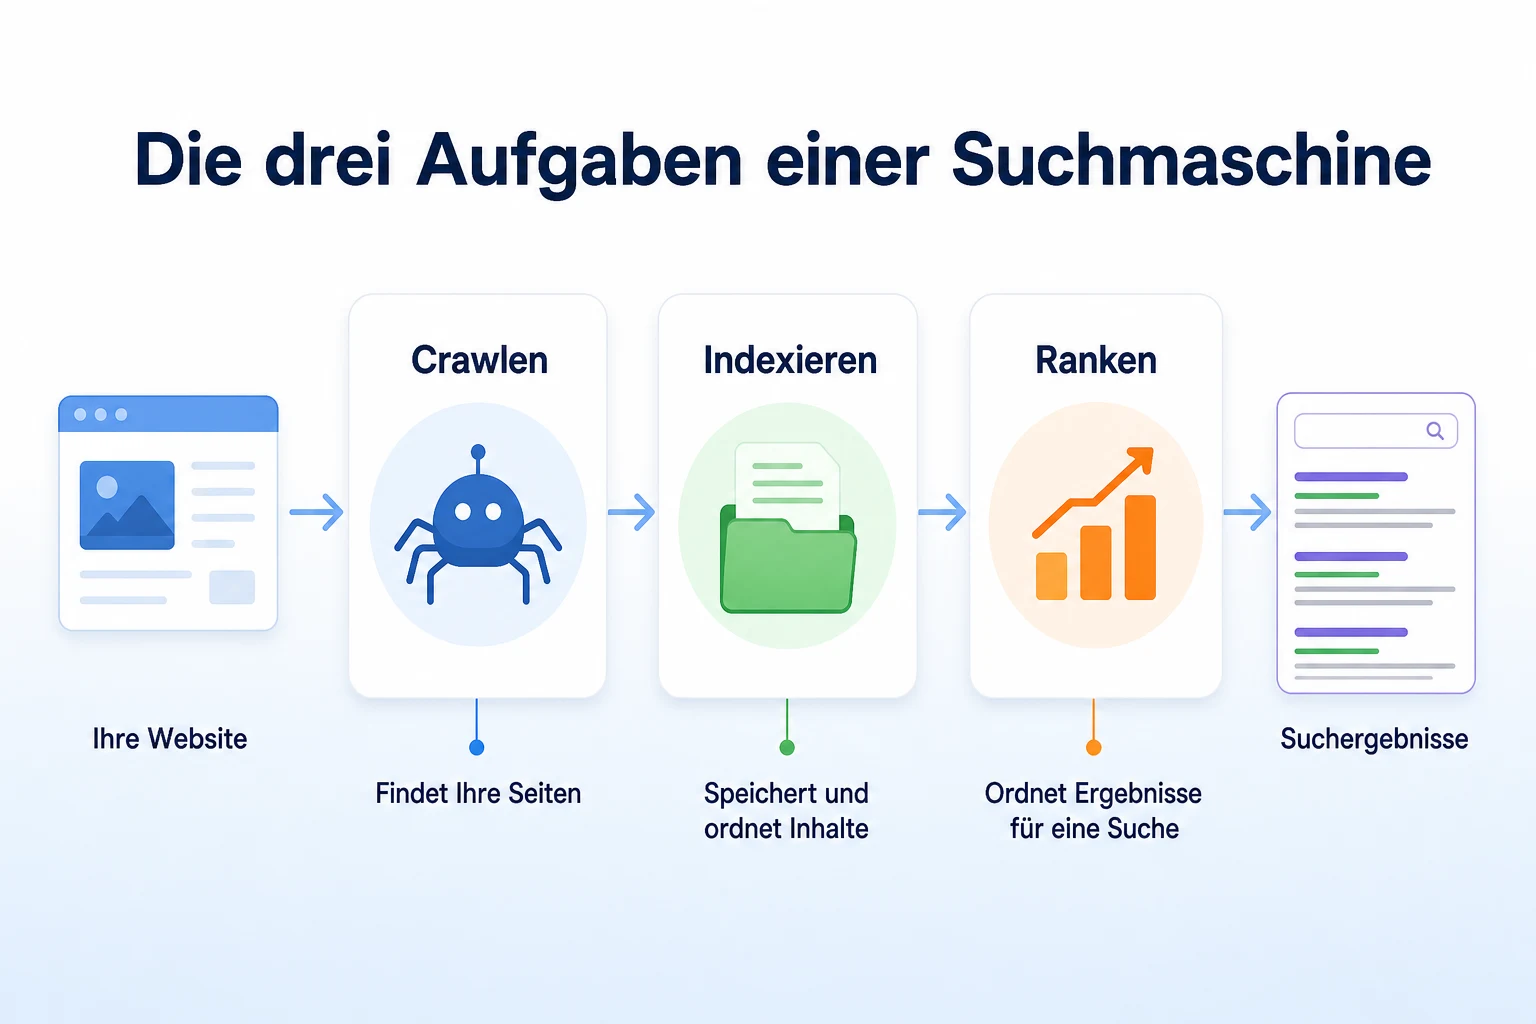
Die drei Aufgaben: Crawling, Indexierung, Ranking
Die erste Aufgabe ist das Crawling: das Finden von Seiten, die im Web existieren. Die zweite ist die Indexierung: das Lesen dieser Seiten und das Speichern eines strukturierten Eintrags über ihren Inhalt. Die dritte ist das Ranking: Wenn jemand tatsächlich etwas sucht, entscheidet die Suchmaschine, welche gespeicherten Seiten angezeigt werden und in welcher Reihenfolge.
Man kann es sich so vorstellen: Crawling ist eine Bibliothekarin, die durch eine Stadt geht und jedes Buch einsammelt, das sie findet. Indexierung bedeutet, dass sie jedes Buch liest und nach Thema einordnet. Ranking passiert in dem Moment, in dem ein Besucher nach einem Buch zu einem bestimmten Thema fragt, und die Bibliothekarin die besten Treffer aus dem Regal holt.
Warum die Reihenfolge wichtiger ist als jeder einzelne Trick
Diese drei Aufgaben laufen nacheinander ab, und jede hängt von der vorherigen ab. Eine Seite, die nie gecrawlt wurde, kann nicht indexiert werden. Eine Seite, die nie indexiert wurde, kann für nichts ranken, egal wie gut sie geschrieben ist. Deshalb ist viel SEO-Rat, der nach besserem Content klingt, erst dann wirklich nützlich, wenn Crawling und Indexierung bereits funktionieren.
Das erklärt auch, warum zwei Unternehmen mit denselben Ratschlägen unterschiedliche Ergebnisse haben können. Das eine hat vielleicht ein verborgenes Crawling-Problem, sodass besseres Schreiben nie zum Tragen kommt. Das andere hat Crawling und Indexierung im Griff, dann ist das Schreiben tatsächlich der nächste Punkt, den es zu verbessern gilt. Gleicher Rat, anderer Ausgangspunkt.
Crawling: So finden Suchmaschinen Ihre neuen oder geänderten Seiten
Crawling ist die Entdeckungsphase. Bevor eine Suchmaschine mit Ihrer Website etwas anfangen kann, muss sie sie zuerst finden.
Wie ein Crawler eine Seite findet, die er noch nie gesehen hat
Suchmaschinen nutzen automatisierte Programme, die oft Crawler oder Spider genannt werden. Sie wandern von Seite zu Seite, indem sie Links folgen. Der Crawler von Google heißt Googlebot. Er startet bei Seiten, die er bereits kennt, folgt den Links auf diesen Seiten zu neuen Seiten und wiederholt das ständig. Eine neue Seite wird meist auf einem von zwei Wegen gefunden: über einen Link von einer Seite, die der Googlebot ohnehin besucht, oder über eine Sitemap, die die Seite direkt auflistet und den Crawler dorthin führt.
Das bedeutet: Eine Seite, auf die kein Link zeigt und die in keiner Sitemap erwähnt wird, kann auf Ihrer Website unbegrenzt liegen, ohne dass ein Crawler sie je zufällig findet. Sie wird nicht abgelehnt. Sie wurde einfach noch nie entdeckt.
Was einen Crawler schon vor dem Start stoppen kann
Einige typische Einrichtungsprobleme blockieren einen Crawler komplett. Eine robots.txt-Datei kann einem Crawler ausdrücklich verbieten, eine Seite oder einen ganzen Bereich der Website aufzurufen. Eine Seite kann eine noindex-Anweisung tragen, die der Suchmaschine sagt, sie nicht zu behalten, auch wenn sie gecrawlt wurde. Eine fehlerhafte interne Linkstruktur, bei der eine Seite existiert, aber nirgendwo sonst auf der Website verlinkt ist, lässt dem Crawler keinen Weg dorthin. Die Dokumentation von Google zu dem Crawling einer Website durch den Googlebot erklärt genau, worauf er achtet und was ihm im Weg stehen kann.
Prüfen, ob ein Crawler Ihre Website erreichen kann
Sie müssen das nicht raten. Unser kostenloser Robots.txt Checker liest die robots.txt-Datei Ihrer Website und gibt ein klares Urteil darüber ab, ob Such- und KI-Crawler tatsächlich zugelassen sind. Sie müssen die Regeln der Datei nicht selbst interpretieren. Die Prüfung dauert ein paar Minuten und beantwortet die grundlegendste Frage in diesem ganzen Prozess: Kommt überhaupt irgendetwas hinein?
Indexierung: So entscheiden Suchmaschinen, worum es auf einer Seite geht
Sobald eine Seite gefunden ist, muss sie sich trotzdem einen Platz im Index verdienen. Gecrawlt zu werden und indexiert zu werden sind zwei verschiedene Ergebnisse, und sie zu verwechseln verursacht viel unnötige Sorge.
Warum „gecrawlt“ nicht „indexiert“ bedeutet
Eine Suchmaschine kann eine Seite besuchen, sie lesen und trotzdem entscheiden, sie nicht im Index zu behalten. Dafür gibt es viele Gründe: Der Inhalt ist zu dünn, um gespeichert zu werden, er ist ein fast identisches Duplikat einer anderen Seite derselben Website, oder die Indexierung wurde blockiert, obwohl der Crawler technisch darauf zugreifen konnte. Eine Seite in diesem Zustand taucht in den Server-Logs als gecrawlt auf, erscheint aber überhaupt nicht in den Suchergebnissen. Unser Leitfaden, wie Sie eine Website von Google indexieren lassen, geht auf diese Lücke genauer ein, einschließlich der Frage, wie Sie prüfen, welche Ihrer Seiten es tatsächlich in den Index geschafft haben.
Was Suchmaschinen auf einer Seite tatsächlich lesen
Wird eine Seite indexiert, speichert die Suchmaschine mehr als nur die Wörter darauf. Sie liest den Seitentitel, die Überschriften, den Haupttext und strukturierte Daten-Markups, die beschreiben, worum es auf der Seite geht: ein Produkt, ein lokales Unternehmen, ein Rezept, ein Artikel. Auch eine Sitemap hilft hier, indem sie der Suchmaschine eine direkte Liste der Seiten einer Website gibt, die sich zu prüfen lohnen, statt sich ganz auf Links zu verlassen. Die Dokumentation von Google zu Sitemaps erklärt, was eine Sitemap genau macht und wann sie hilft.
Hier entsteht auch das eigentliche Problem mit dünnem oder vagem Content. Eine Seite, die kaum etwas Konkretes sagt, gibt der Suchmaschine sehr wenig, unter dem sie die Seite einordnen kann. Das macht es schwer, dass diese Seite für mehr als die allgemeinste Suche auftaucht.
Ranking: So ordnen Suchmaschinen die Ergebnisse für eine einzelne Suche
Ranking ist die letzte Stufe, und an sie denken die meisten Menschen zuerst. Sie findet nur unter Seiten statt, die die ersten beiden Stufen bereits bestanden haben.
Was „Relevanz“ für ein Ranking-System bedeutet
Wenn jemand eine Suche eingibt, vergleicht ein Ranking-System diese Suche mit allem, was im Index steht, und versucht, die Seiten nach oben zu holen, die sie am besten beantworten. Die Dokumentation Google Search Essentials beschreibt das als Abwägung verschiedener Faktoren: wie relevant der Inhalt einer Seite für die Suche ist, wie verlässlich und hilfreich die Seite wirkt, und Signale zur Seitenerfahrung wie Ladegeschwindigkeit und Nutzbarkeit auf dem Smartphone. Es gibt nicht den einen Faktor, der über die Position entscheidet. Es ist eine Kombination, die bei jeder einzelnen Suche neu angewendet wird.
Unser Leitfaden, wie Google entscheidet, welche Websites ranken geht die dokumentierten Faktoren vollständig durch. Er lohnt sich, sobald bestätigt ist, dass Crawling und Indexierung funktionieren, denn dann beginnt Ranking-Rat wirklich zu greifen.
Warum sich Ihre Position ändern kann, ohne dass Sie etwas an Ihrer Website tun
Die Position einer Seite in den Ergebnissen kann sich verschieben, auch wenn sich auf dieser Seite gar nichts ändert. Ein Konkurrent veröffentlicht vielleicht eine stärkere Seite zum gleichen Thema. Eine Suchmaschine passt womöglich an, wie sie ein bestimmtes Signal gewichtet. Schon die genaue Formulierung einer Suche kann verändern, was als beste Antwort gilt, denn „Klempner in meiner Nähe“ und „Notfall-Klempner“ können selbst für dasselbe Unternehmen eine unterschiedliche Reihenfolge der Ergebnisse liefern. Das bedeutet nicht, dass auf Ihrer Seite etwas kaputt gegangen ist. Ranking ist relativ zu allem, was in genau diesem Moment um dieselbe Suche konkurriert, und dieser Wettbewerb bewegt sich von selbst weiter, wie in der Dokumentation Google Search Essentials beschrieben.
Ein praktisches Beispiel: Was passiert, wenn jemand nach „Klempner in der Nähe“ sucht
Die drei Stufen lassen sich leichter nachvollziehen, wenn man eine echte Suche von Anfang bis Ende durchgeht. Dieses Beispiel dient der Veranschaulichung, entspricht aber der oben beschriebenen Reihenfolge.
Die Suche mit dem abgleichen, was bereits im Index steht
Stellen Sie sich vor, ein Klempner in Austin hat eine Website mit einer Startseite, einer Leistungsseite und einer Handvoll stadtspezifischer Seiten, von denen eine auf Notfall-Klempnerarbeiten abzielt. Lange bevor jemand etwas sucht, hat der Googlebot diese Seiten bereits gecrawlt, indem er internen Links und der Sitemap der Website gefolgt ist. Jede Seite wurde dann in den Index aufgenommen und anhand von Titel, Überschriften und Fließtext unter ihrem Thema abgelegt, dazu kommen alle lokalen strukturierten Unternehmensdaten der Website.
Jetzt sucht jemand in der Nähe auf seinem Handy nach „Klempner in der Nähe“. Crawling und Indexierung finden in diesem Moment nicht statt. Das alles ist schon früher passiert. Jetzt folgt der Ranking-Schritt: Google vergleicht den Standort des Suchenden und die Wörter der Suche mit allem, was bereits im Index liegt, und entscheidet, welche Seiten von allen Klempner-Websites, die es für diese Region gespeichert hat, genau diese Suche im Moment am besten beantworten.
Stufe | Was in diesem Beispiel passiert | Was ein Unternehmen prüfen kann |
|---|---|---|
Crawling | Der Googlebot folgt einem Link oder einem Sitemap-Eintrag, um die Notfall-Leistungsseite des Klempners zu finden | Ob die Seite von anderen Stellen der Website verlinkt und in der Sitemap aufgeführt ist |
Indexierung | Die Seite wird gespeichert und anhand von Titel und Inhalt unter „Notfall-Klempner, Austin“ eingeordnet | Ob Titel und Text der Seite tatsächlich sagen, welche Leistung und welches Gebiet sie abdeckt |
Ranking | Google vergleicht Standort und Wortlaut des Suchenden mit jeder indexierten Klempner-Seite in der Nähe und sortiert dann die Ergebnisse | Wie vollständig und konkret die Seite im Vergleich mit den Seiten anderer lokaler Klempner ist |
Diese Angaben dienen nur der Veranschaulichung.
Unser Leitfaden zur lokalen Suchmaschinenoptimierung für kleine Unternehmen erklärt ausführlicher, was eine Seite wie diese braucht, um bei einer ortsbezogenen Suche zu konkurrieren, sobald Crawling und Indexierung sicher funktionieren.
Funktionieren Google, Bing und andere Suchmaschinen gleich?
Das Drei-Stufen-Modell gilt nicht nur für Google. Es beschreibt, was Suchmaschinen strukturell leisten müssen. Deshalb folgen Bing und andere Suchmaschinen trotz getrennter Systeme verschiedener Unternehmen im Grunde demselben Aufbau.
Was dokumentiert ähnlich ist
Sowohl Google als auch Bing veröffentlichen Hinweise, die eine Abfolge aus Crawling, Indexierung und Ranking beschreiben. Beide nutzen automatisierte Crawler, die Links folgen und Sitemaps auslesen. Beide speichern gefundene Inhalte in einem Index, bevor etwas einem Suchenden angezeigt wird. Beide wenden bei jeder Suche einen Ranking-Schritt an, bei dem Relevanz- und Qualitätssignale gewichtet werden, statt die Ergebnisse in einer festen Reihenfolge anzuzeigen. Die Struktur ist so einheitlich, dass Tipps für eine der drei Stufen, etwa die Behebung einer Crawling-Sperre oder ein klarerer Seitentitel, meist mehreren Suchmaschinen gleichzeitig helfen.
Was jede Suchmaschine für sich behält
Unterschiede bestehen bei Details, die keiner der beiden vollständig veröffentlicht. Die genaue Gewichtung eines bestimmten Signals, also wie stark ein Faktor im Verhältnis zu einem anderen bei einer bestimmten Suche zählt, ist für Google und Bing nicht öffentlich. Jedes Unternehmen dokumentiert die Kategorien dessen, was es berücksichtigt, aber keine Formel. Das ist eine bewusste Entscheidung der Unternehmen und keine Lücke in diesem Artikel.
Stufe | Bing | |
|---|---|---|
Crawling | Nutzt den Googlebot, der Links und Sitemaps folgt, dokumentiert in den Crawling-Richtlinien | Nutzt den Bingbot, der Links und Sitemaps folgt, dokumentiert in den Webmaster-Richtlinien |
Indexierung | Speichert Inhalte, die es für aufbewahrenswert hält, und berücksichtigt dabei Seitenqualität und Duplikate | Speichert Inhalte ähnlich und filtert zusätzlich dünne oder doppelte Seiten heraus |
Ranking | Gewichtet dokumentierte Kategorien: Relevanz, Seitenerfahrung, Verlässlichkeit | Gewichtet eigene dokumentierte Kategorien, darunter Relevanz und Seitenqualität |
In der Praxis braucht ein kleines Unternehmen meist keine eigene Strategie für jede Suchmaschine. Die Behebung einer Crawling-Sperre oder einer dünnen Seite hilft oft bei beiden, weil das zugrunde liegende Problem dasselbe ist, egal welche Suchmaschine die Seite gerade lesen will.
Welche Rolle KI-Assistenten wie ChatGPT in diesem Bild spielen
KI-Assistenten fügen diesem Thema einen vierten Namen hinzu, ersetzen aber nicht das Drei-Stufen-Modell. In den meisten Fällen setzen sie darauf auf.
Was ein KI-Crawler braucht, um Ihre Website zu lesen
Einige KI-Systeme betreiben eigene Crawler, getrennt vom Googlebot oder Bingbot, um Inhalte direkt aus dem Web zu sammeln. Andere stützen sich stärker auf einen bestehenden Suchindex, um Informationen zu finden und zusammenzufassen, wenn sie eine Frage beantworten. In beiden Fällen bleibt die Grundvoraussetzung gleich: Der jeweilige Crawler muss Ihre Seite erreichen und ihren tatsächlichen Text lesen können. Ist eine Seite in der robots.txt blockiert oder erscheinen ihre Inhalte erst, nachdem ein Skript im Browser läuft, kann ein KI-Crawler auf dieselbe Hürde stoßen wie ein Crawler einer Suchmaschine. Unser Leitfaden wie ein KI-Webcrawler eine Website liest und indexiert beschreibt ausführlicher, was dieser Zugriff tatsächlich erfordert.
Warum Indexierung und eine Erwähnung durch KI nicht dasselbe sind
Dass Google eine Seite indexiert hat, garantiert keine Erwähnung in der Antwort eines KI-Assistenten, und umgekehrt gilt das ebenso. Dies sind getrennte Systeme, die unabhängig voneinander entwickelt und betrieben werden. Keine offizielle Dokumentation verknüpft die Präsenz einer Seite im Google-Index damit, ob ein bestimmter KI-Assistent sie erwähnt. Für beide gilt jedoch: Eine Seite muss lesbar und konkret sein, bevor eine der beiden etwas Sinnvolles damit anfangen kann. Eine vage, dünne Seite gibt einer Suchmaschine wenig zum Ranken und einem KI-Assistenten wenig, um sie korrekt zusammenzufassen, und das aus demselben Grund.
Warum Ihre Website möglicherweise nicht erscheint: Das Symptom der richtigen Stufe zuordnen
Sobald Sie wissen, dass es drei getrennte Stufen gibt, lassen sich die meisten Fragen nach dem Muster „Warum funktioniert das nicht?“ leichter einordnen. Der Trick ist, das, was Sie tatsächlich sehen, der Stufe zuzuordnen, die am wahrscheinlichsten verantwortlich ist, statt eine Lösung zu raten, bevor Sie wissen, welches Problem vorliegt.
Die eigenen Symptome richtig deuten, bevor Sie etwas reparieren
Eine Site-Suche wie site:ihredomain.de in Google ist eine schnelle erste Prüfung: Wenn eine Seite dort gar nicht auftaucht, lohnt sich ein Blick auf Crawling und Indexierung, bevor Sie sich um das Ranking sorgen. Eine Seite, die bei einer Site-Suche zwar erscheint, aber nie bei einem passenden Suchbegriff, weist ganz woanders hin, meist eher auf Inhalt oder Ranking als auf den Zugriff.
Was Sie sehen | Wahrscheinliche Stufe | Was Sie zuerst prüfen sollten |
|---|---|---|
Seite erscheint auch bei einer | Crawling | robots.txt, interne Links, ob die Seite in der Sitemap steht |
Seite wurde kürzlich veröffentlicht und taucht Wochen später immer noch nicht auf | Crawling oder Indexierung | Abdeckungsbericht der Search Console, Einreichung der Sitemap |
Seite erscheint bei einer | Ranking | Seiteninhalt, Titel und wie gut sie zu dem passt, was Suchende tatsächlich eingeben |
Seite rankte früher gut und ist kürzlich abgerutscht | Ranking | Neue konkurrierende Seiten, eine Inhaltsänderung an anderer Stelle der Website, eine allgemeine Algorithmus-Änderung |
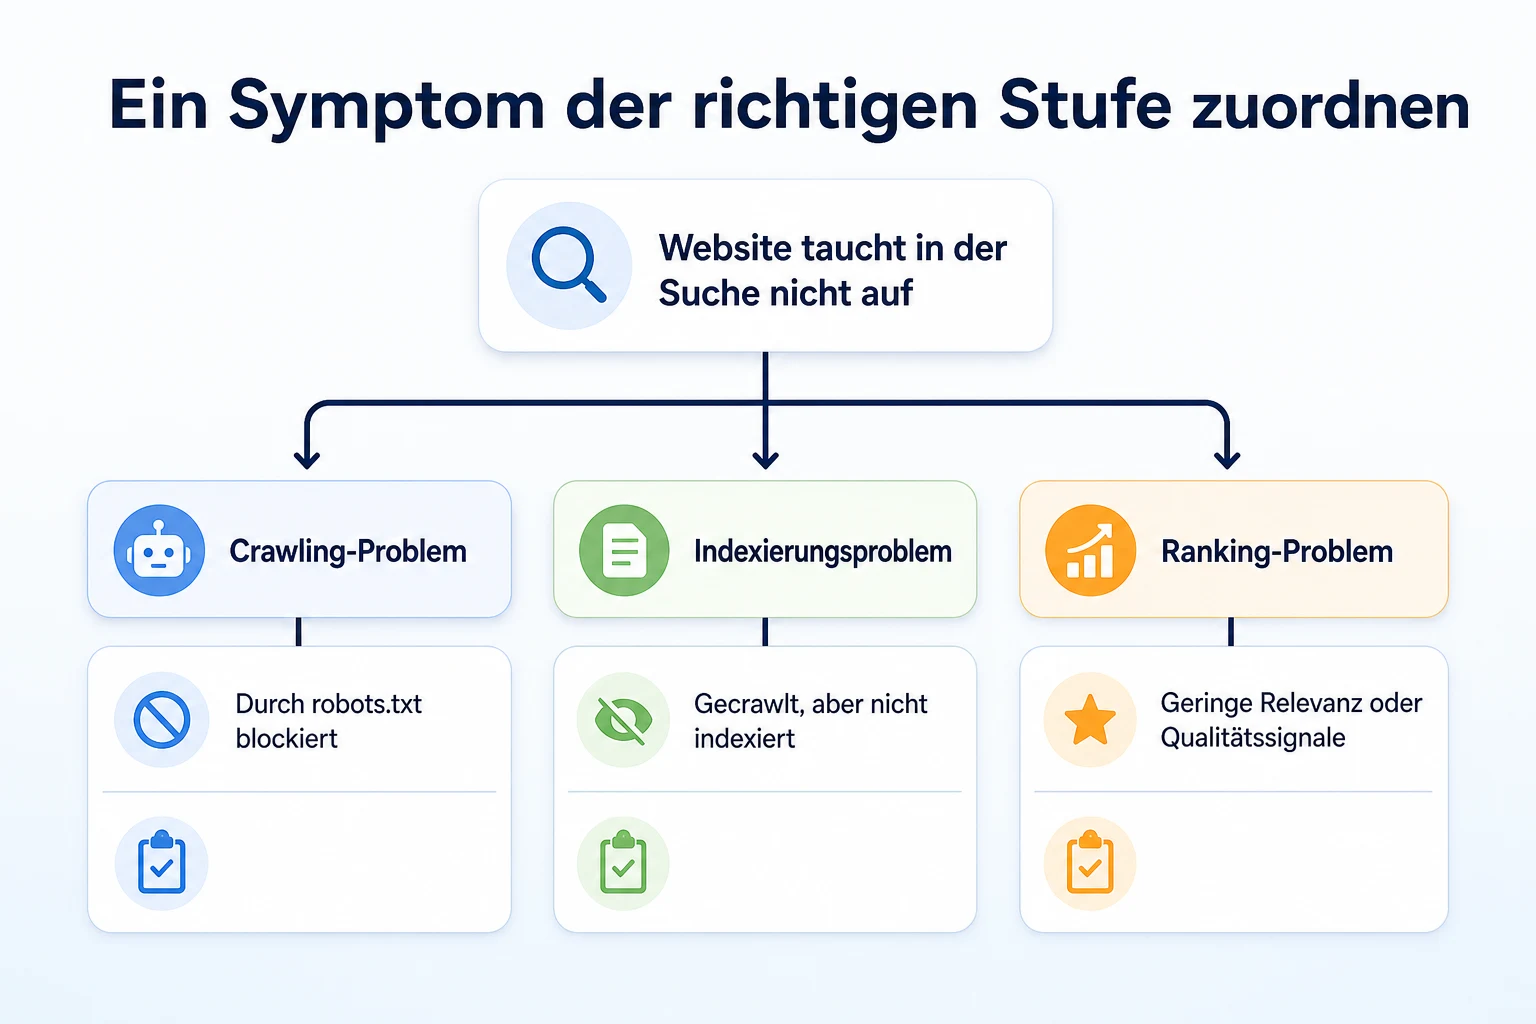
Mit wenigen Minuten im kostenlosen Robots.txt Checker lässt sich das häufigste grundlegende Crawling-Problem in unter einer Minute ausschließen. Das lohnt sich, bevor Sie annehmen, dass das Problem weiter unten in der Kette komplizierter ist.
Ein 20-Minuten-Check: So sehen Suchmaschinen Ihre Website derzeit
Sie brauchen kein technisches Vorwissen, um einen ersten echten Eindruck davon zu bekommen, wo Ihre Website steht. Zwanzig Minuten und ein Browser reichen aus, um alle drei Stufen nacheinander zu prüfen.
Was Sie vor dem Start brauchen
Sie benötigen nur die Adresse Ihrer Startseite und, falls Sie bereits eine Einrichtung haben, Zugang zur Google Search Console. Wenn Sie die Search Console noch nicht verbunden haben, können Sie den Großteil dieses Checks trotzdem durchführen. Sie überspringen dann nur den einen Schritt, der sie benötigt.
Schritt | Zeit | Was er Ihnen zeigt |
|---|---|---|
Suchen Sie nach | 3 Minuten | Ob Ihre wichtigsten Seiten überhaupt in den Index aufgenommen wurden |
Prüfen Sie Ihre Website mit dem Robots.txt-Checker | 5 Minuten | Ob eine Crawling-Sperre Such- oder KI-Crawler schon vor dem Start aufhält |
Prüfen Sie den Bericht Seiten bzw. Abdeckung in der Search Console | 7 Minuten | Welche Seiten Google gecrawlt, indexiert oder ausgeschlossen hat, und warum |
Suchen Sie die genaue Wortfolge, für die Sie gefunden werden möchten | 5 Minuten | Ob eine indexierte Seite tatsächlich für den Begriff rankt, der für Sie wichtig ist |
Wenn Sie diese vier Schritte der Reihe nach durchgehen, folgen Sie dem Drei-Stufen-Modell selbst. Wenn die ersten beiden Schritte ein Problem aufdecken, lohnt es sich kaum, jetzt schon Zeit in den vierten zu investieren, denn eine Ranking-Korrektur kann einer Seite nichts nützen, die nie indexiert wurde.
Häufige Missverständnisse darüber, wie Suchmaschinen funktionieren
Einige Vorstellungen über Suchmaschinen halten sich hartnäckig, lange nachdem sie aufgehört haben, zutreffend zu sein, falls sie es je waren. Wenn Sie einige davon klären, sparen Sie viel verschwendete Mühe.
Google Ads verbessert Ihr organisches Ranking. Das stimmt nicht. Bezahlte Anzeigen und organische Ergebnisse stammen aus getrennten Systemen innerhalb von Google, und Ausgaben für das eine haben nachweislich keinen dokumentierten Einfluss auf das andere.
Das Wiederholen eines Keywords auf einer Seite hilft beim Ranking. Suchmaschinen lesen auf Thema und Relevanz, nicht auf Wortanzahl. Eine Seite, die mit derselben Wendung immer wieder vollgestopft ist, wirkt auf echte Besucher meist schlechter, und die Suchmaschine belohnt die Wiederholung nicht zusätzlich.
Eine Sitemap einzureichen garantiert die Indexierung einer Seite. Eine Sitemap hilft einer Suchmaschine nur, eine Seite schneller zu finden. Ob diese Seite tatsächlich in den Index aufgenommen wird, hängt weiterhin davon ab, ob sie die weiter oben in diesem Artikel beschriebene Hürde für Qualität und Einzigartigkeit nimmt.
Mehr Seiten bedeuten immer mehr Sichtbarkeit in der Suche. Eine große Zahl dünner, nahezu doppelter Seiten kann genau das Gegenteil bewirken, denn keine davon gibt einer Suchmaschine einen großen Grund, sie gegenüber den anderen zu indexieren oder zu ranken. Eine kleinere Zahl gezielter, gut geschriebener Seiten schneidet meist besser ab als viele vage.
Eine Seite in sozialen Medien zu teilen, verbessert direkt ihr Ranking. Geteilte Beiträge können Besucher und mit der Zeit indirekt auch mehr Links bringen, aber kein dokumentierter Ranking-Faktor behandelt die Anzahl der Shares selbst als Eingabe dafür, wo eine Seite in den Ergebnissen landet.
Wo RepGet ins Bild passt
RepGet verändert nicht, wie Crawling, Indexierung oder Ranking funktionieren, und die Nutzung der Plattform überspringt keine der drei Stufen, die in diesem Artikel beschrieben werden. Sie hilft Ihnen dabei zu sehen, wo Ihre eigene Website bei diesen Stufen tatsächlich steht, und die Probleme abzuarbeiten, die im Weg stehen.
Das kostenlose Website-Audit von RepGet crawlt Ihre Website und vergibt einen SEO-Score von 0 bis 100. Dabei werden Crawlbarkeits- und Inhaltsprobleme markiert, die darüber entscheiden, ob eine Seite die ersten beiden Stufen überhaupt schafft: etwa Seiten, die ein Crawler nicht erreichen kann, dünne Inhalte, die eine Suchmaschine kaum indexieren kann, und fehlende technische Grundlagen. Kein Konto und keine Kreditkarte nötig.
Über das Audit hinaus bringt RepGet Keyword-Recherche, Content-Planung, Artikelerstellung, Veröffentlichung und Berichte zur Suchleistung aus der Google Search Console in einem Workflow zusammen. Das ist nützlich, sobald Crawling und Indexierung bestätigt sind und sich die Arbeit auf die Inhalts- und Relevanzsignale verlagert, die das Ranking beeinflussen. RepGet steuert keinen Suchalgorithmus, und die Plattform garantiert weder ein Ranking, eine Position in Google Maps noch eine Erwähnung in der Antwort eines KI-Assistenten.
Das Fazit
Die Aufgabe einer Suchmaschine lässt sich in drei Stufen gliedern, die nacheinander ablaufen: Crawling findet Ihre Seiten, Indexierung speichert und ordnet deren Inhalte, und Ranking entscheidet, welche indexierten Seiten eine bestimmte Suche am besten beantworten. Ein Problem auf einer einzelnen Stufe kann eine Website unsichtbar halten, egal wie viel Mühe in die nachfolgenden Stufen fließt.
Google und Bing dokumentieren beide diese grundlegende Abfolge, auch wenn keiner von beiden die genaue Gewichtung hinter seinen Ranking-Entscheidungen veröffentlicht. KI-Assistenten greifen auf weitgehend dieselben gecrawlten Inhalte zurück. Deshalb bleibt es wichtig, lesbar und konkret zu schreiben, auch wenn immer mehr dieser Inhalte die Menschen über eine Chat-Antwort statt über eine Ergebnisseite erreichen.
Wenn Sie wissen, auf welcher Stufe ein Problem liegt, ist der nächste Schritt meist offensichtlich, und vieles von dem, was früher widersprüchlich klang, ergibt an seinem richtigen Platz plötzlich Sinn.
Finden Sie zuerst heraus, was Ihre Website braucht
Bevor Sie Ranking-Tipps nachjagen, finden Sie heraus, ob Ihre Website überhaupt richtig gecrawlt und indexiert wird. Führen Sie mit RepGet ein kostenloses Website-Audit durch, um die technischen und inhaltlichen Probleme zu sehen, die sich zuerst lohnen. Kein Konto und keine Kreditkarte nötig.
Häufige Fragen
Wie funktionieren Suchmaschinen einfach erklärt?
Eine Suchmaschine findet Seiten, indem sie Links verfolgt. Durch die Indexierung speichert und ordnet sie, was sie findet. Wenn jemand eine Suchanfrage eingibt, rankt sie die indexierten Seiten, die am besten zu dieser Suche passen.
Was ist der Unterschied zwischen Crawling und Indexierung?
Crawling bedeutet, dass eine Suchmaschine eine Seite findet und besucht. Indexierung ist ein eigener Schritt, in dem sie entscheidet, ob sie die Seite speichert und einordnet. Das passiert nicht immer, auch wenn die Seite erfolgreich gecrawlt wurde.
Warum wird meine Website bei Google nicht angezeigt?
Meist liegt es an einem von drei Gründen: Ein Crawler kann die Seite nicht erreichen, die Seite wurde gecrawlt, aber nicht indexiert, oder sie ist indexiert, rankt aber nicht gut für die Suchbegriffe, die Sie prüfen.
Nutzen alle Suchmaschinen dasselbe Ranking-System?
Nein. Google, Bing und andere betreiben jeweils eigene Ranking-Systeme mit eigener, nicht offengelegter Gewichtung. Sie dokumentieren aber alle dieselbe grundlegende Struktur aus Crawling, Indexierung und Ranking.
Wie findet ChatGPT Informationen über ein Unternehmen?
Das hängt vom System ab. Manche KI-Assistenten betreiben eigene Crawler, um Webinhalte direkt zu sammeln. Andere stützen sich stärker auf bestehende Suchindizes. Beide müssen aber den tatsächlichen Text einer Seite lesen können.
Wie lange braucht Google, um eine neue Website zu crawlen?
Es gibt keinen festen Zeitraum, und Google hat keine garantierte Geschwindigkeit dokumentiert. Eine Sitemap und interne Links von Seiten, die Google bereits besucht, können helfen, dass eine neue Seite schneller gefunden wird.
Kann man eine Suchmaschine bezahlen, damit sie eine Seite schneller crawlt oder indexiert?
Nein. Bezahlte Anzeigen laufen über ein separates System, getrennt von organischem Crawling, Indexierung und Ranking. Es gibt keinen dokumentierten Weg, eine schnellere oder garantierte Aufnahme in den organischen Index zu kaufen.