

Moteurs de recherche : comment ils fonctionnent vraiment, expliqué simplement
Réponse courte
Les moteurs de recherche fonctionnent en trois étapes. L'exploration trouve vos pages en suivant les liens, l'indexation stocke et organise ce que ces pages traitent, et le classement détermine quelles pages indexées répondent le mieux à une recherche précise. Google et Bing documentent publiquement ce processus, et des assistants IA comme ChatGPT s'appuient en grande partie sur le même contenu exploré. C'est pourquoi un site accessible aux robots et bien rédigé reste essentiel.
Un propriétaire d'entreprise tape le nom de sa propre société dans Google.
Il fait défiler deux concurrents, puis trouve son propre site en page deux.
Il ne comprend pas pourquoi Google l'a placé là, ni ce qu'il devrait changer pour remonter.
La plupart des conseils sur le sujet vont directement aux tactiques : ajouter des mots-clés, obtenir des backlinks, rédiger davantage d'articles de blog. Aucun ne explique ce qui se passe réellement en coulisses, il est donc difficile de savoir quelle tactique compte et laquelle n'est que du bruit.
Les moteurs de recherche ne fonctionnent pas comme un processus unique. Ce sont trois tâches distinctes, réalisées dans l'ordre, et la plupart des conseils confus qui circulent visent simplement l'une de ces trois tâches sans le dire. Voici comment fonctionnent concrètement l'exploration, l'indexation et le classement, en termes simples, et pourquoi comprendre cet ordre explique la plupart des questions du type « pourquoi ça ne marche pas ? » qu'une petite entreprise se pose.
Ce que fait vraiment un moteur de recherche
Un moteur de recherche est un logiciel conçu pour accomplir trois tâches distinctes, l'une après l'autre. Si l'une d'elles n'est pas réalisée, rien de ce qui suit ne se produit, quelle que soit la qualité de votre site.
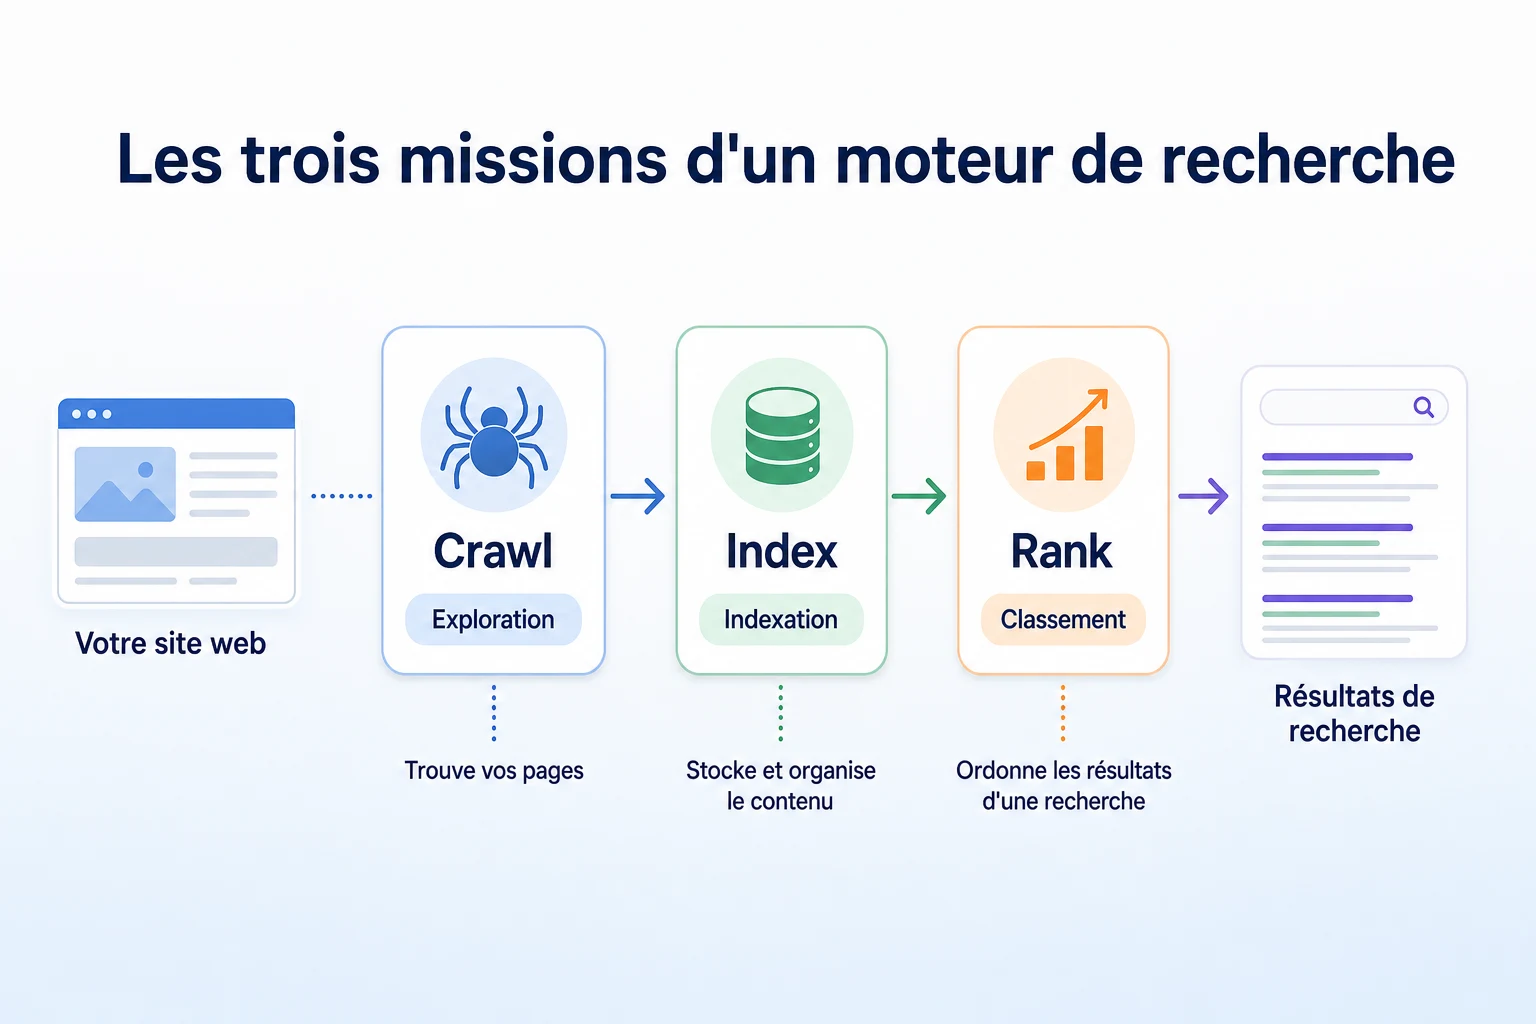
Les trois tâches : explorer, indexer, classer
La première tâche est l'exploration : trouver les pages qui existent sur le web. La deuxième est l'indexation : lire ces pages et stocker une fiche organisée de leur contenu. La troisième est le classement : lorsqu'une personne effectue une recherche, décider quelles pages stockées afficher, et dans quel ordre.
Pour se représenter cela simplement : explorer, c'est un bibliothécaire qui parcourt une ville pour collecter tous les livres qu'il trouve. Indexer, c'est ce même bibliothécaire qui lit chaque livre et le classe par sujet. Classer, c'est ce qui se passe au moment où un visiteur demande un livre sur un sujet précis, et où le bibliothécaire sort de l'étagère les meilleures correspondances.
Pourquoi l'ordre compte plus que n'importe quelle astuce
Ces trois tâches se succèdent, et chacune dépend de la précédente. Une page qui n'a jamais été explorée ne peut pas être indexée. Une page qui n'a jamais été indexée ne peut se classer pour rien, peu importe la qualité de sa rédaction. C'est pourquoi beaucoup de conseils SEO qui semblent porter sur la rédaction de meilleurs contenus ne sont réellement utiles qu'une fois l'exploration et l'indexation déjà fonctionnelles.
Cela explique aussi pourquoi deux entreprises peuvent suivre les mêmes conseils avec des résultats différents. L'une a peut-être un problème d'exploration caché sous tout le reste, si bien qu'une meilleure rédaction n'a jamais l'occasion de compter. L'autre a une exploration et une indexation qui fonctionnent correctement, si bien que la rédaction est vraiment la prochaine chose à améliorer. Mêmes conseils, point de départ différent.
Exploration : comment les moteurs de recherche trouvent vos pages nouvelles ou modifiées
L'exploration est l'étape de découverte. Avant qu'un moteur de recherche puisse faire quoi que ce soit avec votre site, il faut d'abord qu'il le trouve.
Comment un robot d'exploration trouve une page qu'il n'a jamais vue
Un moteur de recherche utilise des programmes automatisés, souvent appelés robots d'exploration ou araignées, qui passent d'une page à l'autre en suivant des liens. Le robot d'exploration de Google s'appelle Googlebot. Il part des pages qu'il connaît déjà, suit les liens qui s'y trouvent vers de nouvelles pages, et répète ce processus en permanence. Une nouvelle page est généralement découverte de deux façons : grâce à un lien provenant d'un endroit que Googlebot visite déjà, ou grâce à un plan du site (sitemap) qui liste la page directement et indique au robot où la trouver.
Cela signifie qu'une page sans aucun lien qui pointe vers elle et sans mention dans un plan du site peut rester sur votre site indéfiniment sans qu'un robot ne tombe jamais dessus. Elle n'est pas rejetée. Elle n'a tout simplement jamais été trouvée.
Ce qui peut bloquer un robot avant même qu'il ne commence
Quelques problèmes de configuration courants bloquent purement et simplement un robot. Un fichier robots.txt peut explicitement demander à un robot de rester à l'écart d'une page ou de toute une section du site. Une page peut porter une instruction noindex qui demande au moteur de recherche de ne pas la conserver même si elle a été explorée. Une structure de liens internes défaillante, où une page existe mais où rien d'autre sur le site ne la relie, ne laisse au robot aucun chemin à suivre. La documentation de Google sur la façon dont Googlebot explore un site détaille exactement ce qu'il examine et ce qui peut l'empêcher d'avancer.
Vérifier si un robot peut accéder à votre site
Inutile de deviner. Notre Robots.txt Checker gratuit lit le fichier robots.txt de votre site et donne un verdict clair sur le fait que les robots de recherche et d'IA sont réellement autorisés à entrer, sans vous laisser interpréter seul les règles du fichier. Cela prend quelques minutes et répond à la question la plus élémentaire de tout ce processus : quelque chose peut-il seulement franchir la porte ?
Indexation : comment les moteurs de recherche déterminent le sujet d'une page
Une fois une page trouvée, elle doit encore mériter sa place dans l'index. Être explorée et être indexée sont deux résultats différents, et les confondre cause beaucoup d'inquiétudes inutiles.
Pourquoi « exploré » ne veut pas dire « indexé »
Un moteur de recherche peut visiter une page, la lire, et décider malgré tout de ne pas la conserver dans son index. Cela arrive pour toutes sortes de raisons : le contenu est trop mince pour valoir la peine d'être stocké, c'est un quasi-doublon d'une autre page du même site, ou son indexation a été bloquée alors que le robot pouvait techniquement y accéder. Une page dans cet état apparaît dans les journaux du serveur comme explorée, mais elle n'apparaîtra pas du tout dans les résultats de recherche. Notre guide sur l'indexation d'un site web par Google détaille cet écart plus en profondeur, y compris comment vérifier lesquelles de vos pages ont réellement été intégrées.
Ce que les moteurs de recherche lisent réellement sur une page
Lorsqu'une page est indexée, un moteur de recherche conserve bien plus que les mots qui s'y trouvent. Il lit le titre de la page, les intertitres, le texte principal et les balises de données structurées qui décrivent ce que la page représente : un produit, une entreprise locale, une recette, un article. Un plan du site aide aussi ici, en donnant au moteur de recherche une liste directe des pages du site à vérifier, au lieu de s'appuyer uniquement sur les liens pour les trouver. La documentation de Google sur les plans de site explique ce que fait exactement un plan du site et quand il est utile.
C'est aussi là que les contenus minces ou vagues posent un vrai problème. Une page qui ne dit presque rien de précis donne très peu d'éléments au moteur de recherche pour la classer, ce qui rend plus difficile son apparition pour toute autre recherche que la plus générique.
Classement : comment les moteurs de recherche ordonnent les résultats d'une recherche
Le classement est la dernière étape, et c'est celle à laquelle la plupart des gens pensent en premier. Elle ne concerne que les pages qui ont déjà franchi les deux premières étapes.
Ce que signifie la « pertinence » pour un système de classement
Lorsqu'une personne tape une recherche, un système de classement compare cette recherche à tout ce qui figure dans l'index et tente de faire remonter les pages qui y répondent le mieux. La documentation Search Essentials de Google décrit cela comme la prise en compte d'un ensemble de facteurs : la pertinence du contenu de la page par rapport à la recherche, la fiabilité et l'utilité perçues de la page, ainsi que des signaux d'expérience de page comme la vitesse de chargement et l'ergonomie sur mobile. Aucun facteur unique ne détermine la position d'un résultat. C'est une combinaison, appliquée à nouveau pour chaque recherche.
Notre guide sur la façon dont Google décide quels sites classer passe en revue les facteurs documentés en détail. Il vaut la peine d'être lu une fois que l'exploration et l'indexation sont confirmées comme fonctionnelles, car c'est à ce moment-là que les conseils sur le classement commencent réellement à s'appliquer.
Pourquoi votre position peut changer sans que vous touchiez à votre site
La position d'une page dans les résultats peut évoluer même si rien sur cette page ne change. Un concurrent peut publier une page plus solide sur le même sujet. Un moteur de recherche peut modifier la façon dont il pondère un signal particulier. La formulation exacte d'une recherche peut aussi changer ce qui est considéré comme la meilleure réponse, puisque « plombier près de chez moi » et « plombier d'urgence » peuvent faire apparaître un ordre de résultats différent, même pour la même entreprise. Rien de tout cela ne signifie que quelque chose s'est cassé de votre côté. Le classement est relatif à tout ce qui se dispute la même recherche à ce moment précis, et cette concurrence continue d'évoluer d'elle-même, comme le explique la documentation Search Essentials de Google.
Exemple concret : ce qui se passe quand quelqu'un recherche « plombier près de moi »
Les trois étapes sont plus faciles à comprendre quand on suit une recherche réelle du début à la fin. Cet exemple est illustratif, mais il respecte l'ordre décrit plus haut.
Faire correspondre la recherche à ce qui est déjà indexé
Imaginez un plombier à Austin dont le site comprend une page d'accueil, une page de services et quelques pages ciblant la ville, dont une consacrée à la plomberie d'urgence. Des semaines avant qu'une personne ne fasse une recherche, Googlebot a déjà exploré ces pages en suivant les liens internes et le plan du site. Chaque page a ensuite été ajoutée à l'index, classée selon son sujet d'après son titre, ses intertitres et son texte, ainsi que les données structurées de l'entreprise locale présentes sur le site.
Maintenant, quelqu'un à proximité recherche « plombier près de moi » sur son téléphone. Rien de l'exploration ni de l'indexation ne se produit à cet instant. Tout cela a déjà eu lieu plus tôt. Ce qui se passe maintenant, c'est l'étape de classement : Google compare la localisation de la personne et les mots de la recherche avec tout ce qui se trouve déjà dans son index, et décide quelles pages, parmi tous les sites de plomberie qu'il a stockés pour cette zone, correspondent le mieux à cette recherche précise, à cet instant.
Étape | Ce qui se passe dans cet exemple | Ce qu'une entreprise peut vérifier |
|---|---|---|
Exploration | Googlebot suit un lien ou une entrée du plan du site pour trouver la page de services d'urgence du plombier | Si la page est liée depuis d'autres pages du site et figure dans le plan du site |
Indexation | La page est stockée et classée sous « plomberie d'urgence, Austin » selon son titre et son contenu | Si le titre et le texte de la page disent vraiment quel service et quelle zone elle couvre |
Classement | Google compare la localisation et les mots de la personne avec chaque page de plomberie indexée à proximité, puis ordonne les résultats | À quel point la page est complète et précise comparée aux pages des autres plombiers locaux |
Ces chiffres sont illustratifs.
Notre guide sur le référencement local pour les petites entreprises va plus loin sur ce qu'une page de ce type doit faire pour se positionner sur une recherche liée à une zone précise, une fois que l'exploration et l'indexation sont confirmées.
Google, Bing et les autres moteurs de recherche fonctionnent-ils de la même façon ?
Le modèle en trois étapes n'est pas propre à Google. Il décrit ce qu'un moteur de recherche doit faire sur le plan structurel, ce qui explique pourquoi Bing et les autres moteurs suivent la même base, même s'il s'agit de systèmes distincts conçus par différentes entreprises.
Ce qui est documenté comme similaire
Google comme Bing publient des recommandations décrivant une séquence d'exploration, d'indexation et de classement. Tous deux utilisent des robots d'exploration automatisés qui suivent les liens et lisent les plans de site. Tous deux stockent ce qu'ils trouvent dans un index avant de montrer quoi que ce soit à une personne qui recherche. Tous deux appliquent une étape de classement au moment de la recherche, en pesant des signaux de pertinence et de qualité plutôt que d'afficher les résultats dans un ordre fixe. La structure est assez cohérente pour que des conseils visant l'une des trois étapes, comme corriger un blocage d'exploration ou rédiger un titre de page plus clair, aident généralement plusieurs moteurs de recherche à la fois.
Ce que chaque moteur garde pour lui
Là où ils diffèrent, c'est dans le détail qu'aucun des deux ne publie en entier. Le poids exact d'un signal donné, c'est-à-dire l'importance d'un facteur par rapport à un autre pour une recherche donnée, n'est pas public pour Google ni pour Bing. Chaque entreprise documente les catégories de critères qu'elle prend en compte, et non une formule. C'est un choix délibéré de leur part, et non un manque dans cet article.
Étape | Bing | |
|---|---|---|
Exploration | Utilise Googlebot, qui suit les liens et les plans de site, documenté dans ses recommandations d'exploration | Utilise Bingbot, qui suit les liens et les plans de site, documenté dans ses consignes pour les webmasters |
Indexation | Stocke le contenu qu'il juge utile à conserver, en tenant compte de la qualité de la page et des doublons | Stocke le contenu de façon similaire, en écartant aussi les pages minces ou dupliquées |
Classement | Pondère des catégories documentées : pertinence, expérience de page, fiabilité | Pondère ses propres catégories documentées, dont la pertinence et la qualité de la page |
En pratique, une petite entreprise n'a généralement pas besoin d'une stratégie distincte pour chaque moteur de recherche. Corriger un blocage d'exploration ou une page trop mince aide souvent les deux à la fois, car le problème de fond est le même, quel que soit le moteur qui tente de lire la page.
Où se situent les assistants IA comme ChatGPT dans ce tableau
Les assistants IA ajoutent un quatrième acteur à cette discussion, mais ils ne remplacent pas le modèle en trois étapes. Dans la plupart des cas, ils en dépendent.
Ce dont un robot d'exploration IA a besoin pour lire votre site
Certains systèmes d'IA font tourner leurs propres robots d'exploration, distincts de Googlebot ou Bingbot, pour recueillir directement le contenu du web. D'autres s'appuient davantage sur un index de recherche existant pour trouver et résumer l'information lorsqu'ils répondent à une question. Dans les deux cas, l'exigence de base ne change pas : le robot concerné, quel qu'il soit, doit pouvoir atteindre votre page et lire son texte réel. Si une page est bloquée dans robots.txt, ou si son contenu n'apparaît qu'après l'exécution d'un script dans le navigateur, un robot d'exploration IA peut se heurter au même obstacle qu'un robot de moteur de recherche. Notre guide sur la façon dont un robot d'exploration web IA lit et indexe un site détaille davantage ce que cet accès exige réellement.
Pourquoi l'indexation et une mention par l'IA ne sont pas la même chose
Être indexé par Google ne garantit pas une mention dans la réponse d'un assistant IA, et l'inverse est tout aussi vrai. Il s'agit de systèmes distincts, conçus et exploités indépendamment, et aucune documentation officielle ne relie la présence d'une page dans l'index de Google à la question de savoir si tel assistant IA la citera. Ce qui est vrai pour les deux, c'est qu'une page doit être lisible et précise avant que l'un ou l'autre puisse en faire quelque chose d'utile. Une page vague et mince donne peu de matière à un moteur de recherche pour classer, et peu de matière à un assistant IA pour la résumer fidèlement, pour la même raison de fond.
Pourquoi votre site n'apparaît peut-être pas : faire correspondre le symptôme à l'étape
Une fois que vous savez qu'il existe trois étapes distinctes, la plupart des situations du type « pourquoi ça ne marche pas » deviennent plus faciles à démêler. L'astuce consiste à associer ce que vous observez réellement à l'étape la plus probablement en cause, plutôt que de deviner une solution avant de savoir quel problème vous avez.
Lire correctement vos symptômes avant de commencer à corriger quoi que ce soit
Une recherche sur le site comme site:votredomaine.com tapée dans Google offre une première lecture rapide : si une page n'apparaît pas du tout, il vaut mieux vérifier l'exploration et l'indexation avant de se soucier du classement. Une page qui apparaît dans une recherche sur le site, mais n'apparaît jamais pour un terme de recherche pertinent, pointe ailleurs, généralement vers le contenu ou le classement plutôt que vers l'accessibilité.
Ce que vous constatez | Étape probable | Ce qu'il faut vérifier en premier |
|---|---|---|
La page n'apparaît pas, même avec une recherche | Exploration | Robots.txt, liens internes, présence de la page dans le plan du site |
La page a été publiée récemment et n'apparaît toujours pas des semaines plus tard | Exploration ou indexation | Le rapport de couverture de Search Console, l'envoi du plan du site |
La page apparaît avec une recherche | Classement | Le contenu de la page, son titre et sa correspondance avec ce que les internautes tapent réellement |
La page se classait bien et a récemment chuté | Classement | De nouvelles pages concurrentes, une mise à jour de contenu ailleurs sur le site, un changement d'algorithme plus large |
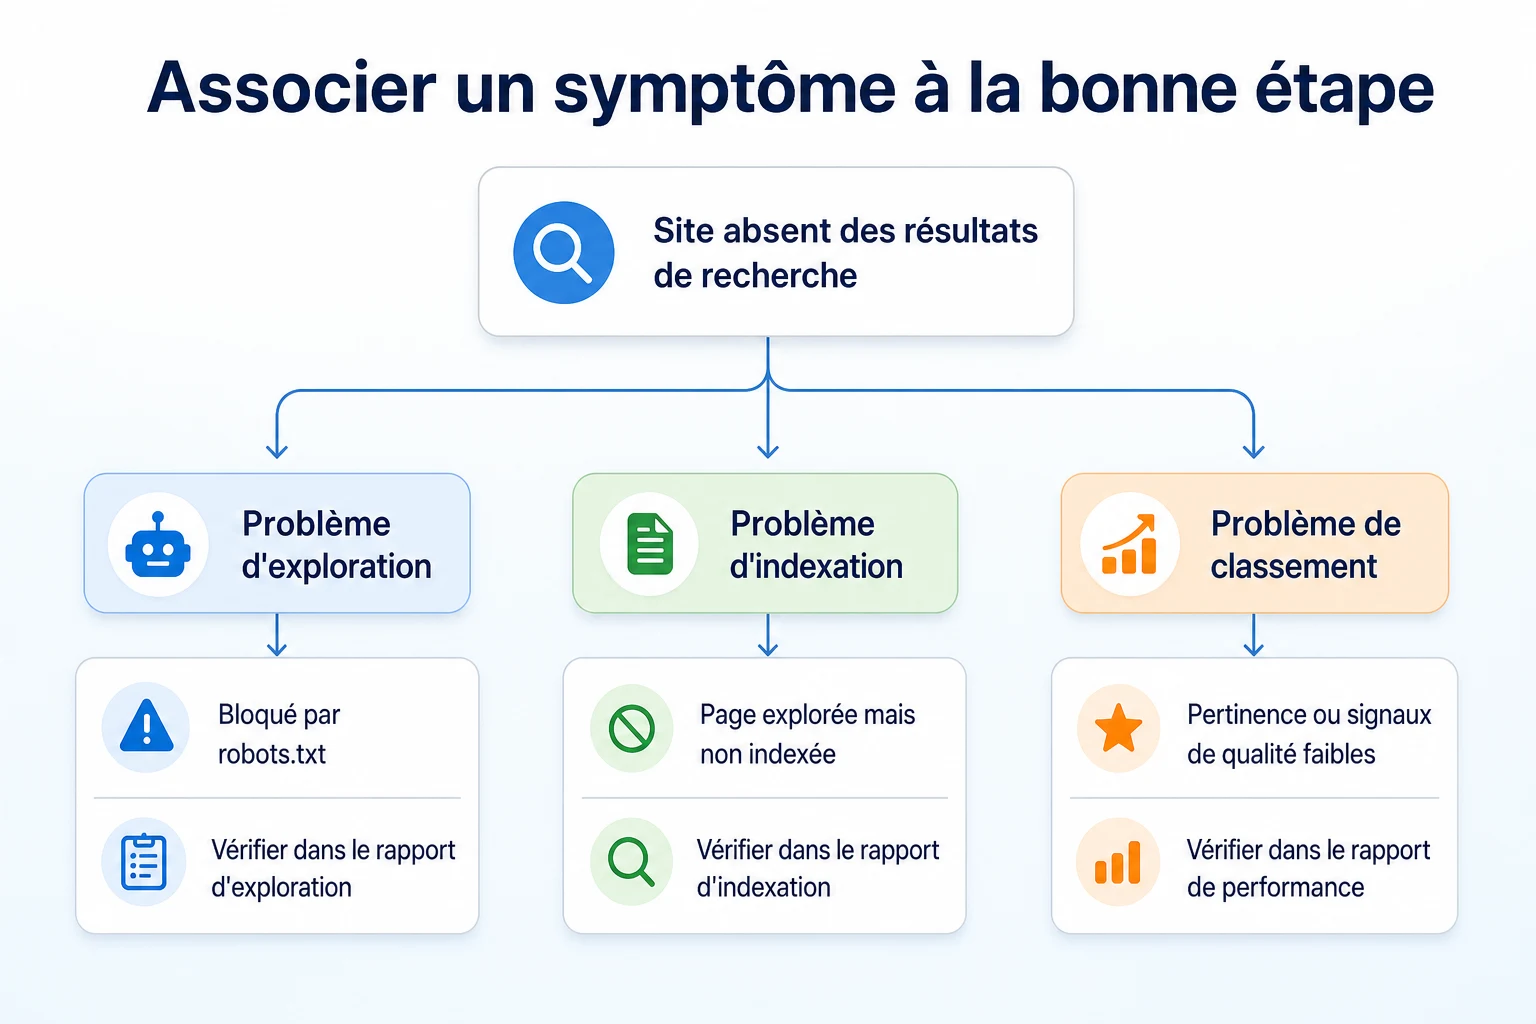
En quelques minutes avec notre Robots.txt Checker gratuit, vous écartez le problème d'exploration le plus basique en moins d'une minute, ce qui vaut la peine avant de supposer que le souci est plus complexe plus loin dans la chaîne.
Un contrôle de 20 minutes pour voir comment les moteurs de recherche perçoivent actuellement votre site
Vous n'avez pas besoin de connaissances techniques pour obtenir une première lecture fiable de la situation de votre site. Vingt minutes et un navigateur suffisent pour vérifier les trois étapes, une par une.
Ce dont vous aurez besoin avant de commencer
Il vous suffit de l'adresse de la page d'accueil de votre site et, si vous en avez déjà un, d'un accès à Google Search Console. Si Search Console n'est pas connectée, vous pouvez tout de même réaliser la plupart de ce contrôle, vous sauterez simplement l'étape qui en a besoin.
Étape | Durée | Ce que cela vous indique |
|---|---|---|
Rechercher | 3 minutes | Si vos pages clés ont bien été intégrées à l'index |
Passer votre site dans le Robots.txt Checker | 5 minutes | Si un blocage d'exploration empêche les robots de recherche ou d'IA de commencer leur travail |
Consulter le rapport Pages ou Couverture dans Search Console | 7 minutes | Quelles pages Google a explorées, indexées ou exclues, et pourquoi |
Rechercher l'expression exacte pour laquelle vous voulez être trouvé | 5 minutes | Si une page indexée se classe réellement pour le terme qui compte pour vous |
Suivre ces quatre étapes dans l'ordre reflète le modèle en trois étapes lui-même. Si les deux premières révèlent un problème, inutile de passer tout de suite à la quatrième, car une correction du classement ne peut rien pour une page qui n'a jamais été indexée.
Idées reçues courantes sur le fonctionnement des moteurs de recherche
Certaines idées sur les moteurs de recherche continuent de circuler bien après avoir cessé d'être exactes, si elles l'ont jamais été. En dissiper quelques-unes permet d'éviter beaucoup d'efforts inutiles.
Lancer des campagnes Google Ads améliore votre classement naturel. Non. Les annonces payantes et les résultats naturels proviennent de systèmes distincts au sein de Google, et les dépenses sur l'un n'ont aucun effet documenté sur l'autre.
Répéter un mot-clé plusieurs fois sur une page l'aide à mieux se classer. Les moteurs de recherche analysent le sujet et la pertinence, et non le nombre de mots. Une page bourrée de la même expression répétée a tendance à être moins agréable à lire pour un visiteur, et elle ne rapporte aucun crédit supplémentaire au moteur de recherche pour cette répétition.
Soumettre un plan du site garantit qu'une page sera indexée. Un plan du site aide seulement un moteur de recherche à trouver une page plus rapidement. Le fait que cette page entre réellement dans l'index dépend toujours de sa capacité à atteindre le niveau de qualité et d'originalité décrit plus haut dans cet article.
Plus de pages signifie toujours plus de visibilité. Un grand nombre de pages peu étoffées et presque identiques peut produire l'effet inverse, puisqu'aucune d'elles ne donne au moteur de recherche de raison particulière de l'indexer ou de la classer plutôt que les autres. Un nombre restreint de pages précises et bien rédigées fonctionne généralement mieux qu'un grand nombre de pages vagues.
Partager une page sur les réseaux sociaux améliore directement son classement. Les partages sociaux peuvent amener des visiteurs et, indirectement, davantage de liens au fil du temps, mais aucun facteur de classement documenté ne considère le nombre de partages comme un élément déterminant de la position d'une page dans les résultats.
Où se situe RepGet
RepGet ne modifie pas le fonctionnement de l'exploration, de l'indexation ou du classement, et son utilisation ne permet de contourner aucune des trois étapes décrites dans cet article. Il vous aide à voir où votre site se situe réellement par rapport à elles, et à résoudre les problèmes qui font obstacle.
L'audit de site gratuit de RepGet explore votre site, lui attribue un score SEO de 0 à 100 et signale les problèmes d'exploration et de contenu qui déterminent si une page franchit les deux premières étapes : par exemple des pages inaccessibles pour un robot d'exploration, un contenu trop mince que le moteur de recherche a peu de matière à indexer, ou des fondamentaux techniques manquants. Aucun compte ni carte bancaire n'est nécessaire.
Au-delà de l'audit, RepGet réunit dans un même flux la recherche de mots-clés, la planification de contenu, la rédaction d'articles, la publication et le suivi des performances de recherche issues de Google Search Console. C'est utile une fois que l'exploration et l'indexation sont confirmées et que le travail se concentre sur les signaux de contenu et de pertinence qui influencent le classement. RepGet ne contrôle l'algorithme d'aucun moteur de recherche et ne garantit ni un classement, ni une position sur Google Maps, ni une mention dans la réponse d'un assistant IA.
En résumé
Le travail d'un moteur de recherche se découpe en trois étapes réalisées dans l'ordre : l'exploration trouve vos pages, l'indexation enregistre et organise leur contenu, et le classement détermine quelles pages indexées répondent le mieux à une recherche précise. Un problème à n'importe laquelle de ces étapes peut rendre un site invisible, quels que soient les efforts consacrés aux étapes suivantes.
Google et Bing documentent tous deux cette même séquence de base, même si aucun des deux ne publie la pondération exacte de ses décisions de classement. Les assistants IA puisent dans une bonne partie du même contenu exploré, ce qui explique pourquoi rester lisible et précis reste essentiel, même si de plus en plus de ce contenu parvient aux internautes via une réponse de chat plutôt que via une page de résultats.
Une fois que vous savez à quelle étape se situe un problème, la suite devient généralement évidente, et beaucoup de conseils qui semblaient contradictoires prennent leur sens à leur place.
Découvrez d'abord ce dont votre site a besoin
Avant de chercher des conseils de classement, vérifiez d'abord si votre site est bien exploré et indexé. Lancez un audit de site gratuit avec RepGet pour voir les problèmes techniques et de contenu à corriger en priorité. Aucun compte ni carte bancaire n'est nécessaire.
Questions fréquentes
Comment fonctionnent les moteurs de recherche, en termes simples ?
Un moteur de recherche trouve des pages en suivant des liens, stocke et organise ce qu'il découvre grâce à l'indexation, puis classe les pages indexées qui correspondent le mieux à une recherche précise lorsqu'un internaute tape une requête.
Quelle est la différence entre exploration et indexation ?
L'exploration consiste pour un moteur de recherche à trouver et visiter une page. L'indexation est une étape distincte où il décide de stocker et de classer cette page, ce qui n'arrive pas toujours même lorsque la page a bien été explorée.
Pourquoi mon site n'apparaît-il pas sur Google ?
Cela tient en général à l'un de ces trois problèmes : un robot d'exploration ne peut pas accéder à la page, la page a été explorée mais pas indexée, ou elle est indexée mais ne se classe pas bien pour les termes que vous vérifiez.
Tous les moteurs de recherche utilisent-ils le même système de classement ?
Non. Google, Bing et les autres font tourner chacun leurs propres systèmes de classement, avec une pondération propre et non divulguée, même si tous documentent la même structure de base : exploration, indexation, classement.
Comment ChatGPT trouve-t-il des informations sur une entreprise ?
Cela dépend du système. Certains assistants IA font tourner leurs propres robots pour collecter directement le contenu du web, tandis que d'autres s'appuient davantage sur les index de recherche existants, mais tous doivent pouvoir lire le texte réel d'une page.
Combien de temps Google met-il pour explorer un nouveau site ?
Il n'existe pas de délai fixe, et Google n'a documenté aucune vitesse garantie. Un plan du site et des liens internes provenant de pages que Google visite déjà peuvent aider une nouvelle page à être découverte plus vite.
Peut-on payer un moteur de recherche pour explorer ou indexer une page plus vite ?
Non. Les annonces payantes passent par un système distinct de l'exploration, de l'indexation et du classement naturels, et il n'existe aucun moyen documenté de payer pour une inclusion plus rapide ou garantie dans l'index naturel.