

Vérificateur de plagiat GPT Zero : votre blog en a-t-il besoin ?
Réponse courte
GPTZero est conçu pour repérer les textes générés par une IA, pas pour détecter le plagiat, donc il ne suffit pas à lui seul comme vérificateur de plagiat. Un vérificateur de plagiat dédié compare votre brouillon aux pages web indexées et signale les correspondances mot pour mot ou presque identiques. Ce contrôle est surtout utile pour les pages modélisées, les contenus rédigés par des pigistes ou les textes assemblés à partir de plusieurs sources, et non pour chaque article de blog que vous publiez.
Un chef d'entreprise fait appel à un rédacteur indépendant pour produire un lot d'articles de blog pour le mois.
Avant publication, il veut être rassuré sur l'originalité du contenu. Quelqu'un dans l'équipe propose de passer chaque article dans GPTZero.
Les résultats affichent un score, mais ce n'est pas un pourcentage de correspondance avec d'autres sites. C'est une probabilité que le texte ait été écrit par une IA.
Ce n'est pas la même question. Une recherche sur vérificateur de plagiat GPT Zero part généralement d'une inquiétude légitime (ce rédacteur a-t-il vraiment écrit ce texte ?), mais GPTZero répond en réalité à une autre question que celle que la plupart des gens ont en tête. Voici ce qu'il vérifie vraiment, ce que le contenu dupliqué fait réellement au classement d'un site, et quand l'étape supplémentaire de vérification vaut votre temps.
Ce que GPTZero vérifie vraiment (et ce qu'il ne vérifie pas)
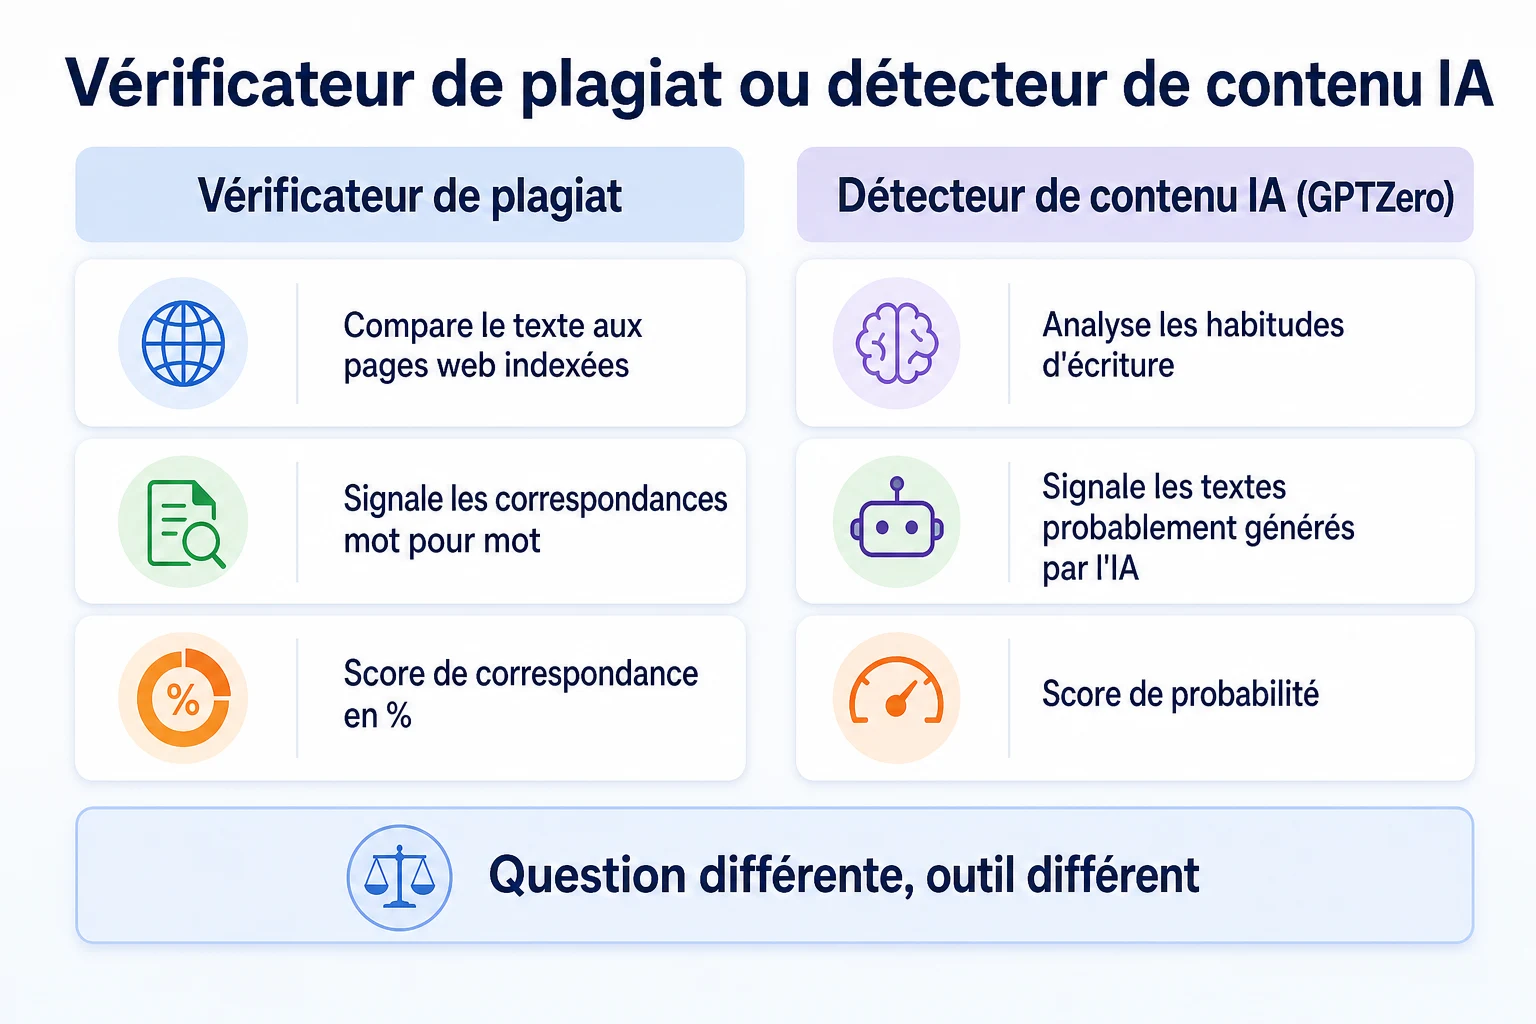
GPTZero est conçu comme un détecteur de contenu IA. Il analyse les schémas d'écriture du texte et estime la probabilité qu'un modèle d'IA l'ait produit. Il ne compare pas votre brouillon aux autres pages du web, et il n'a jamais été conçu pour cela.
Ce que cherche un détecteur de contenu IA comme GPTZero
Les outils de cette catégorie analysent des éléments comme la variation de longueur des phrases, la prévisibilité du choix des mots et d'autres schémas qui tendent à différer entre l'écriture humaine et le texte généré par IA. Le résultat est généralement un score ou un pourcentage de probabilité, et non une liste de sources correspondantes. Notre guide sur les détecteurs de contenu IA explique plus en détail le fonctionnement de ces outils, y compris pourquoi le score est une estimation probabiliste et non un verdict.
Ce que cherche plutôt un vérificateur de plagiat dédié
Un vérificateur de plagiat fait autre chose. Il découpe votre texte en courtes expressions, recherche ces expressions dans un vaste index de pages web publiées, et renvoie un pourcentage indiquant quelle part de votre texte chevauche du contenu existant ailleurs. C'est l'outil dont vous avez besoin si la question est de savoir si un article est trop proche de ce qui est déjà publié, qu'il s'agisse du brouillon d'un rédacteur indépendant ou d'une page de votre propre site.
Type d'outil | Ce qu'il vérifie | Ce que le résultat vous indique | Ce qu'il ne peut pas vous dire |
|---|---|---|---|
Détecteur de contenu IA (GPTZero) | Schémas d'écriture dans le texte lui-même | Une probabilité que le texte ait été généré par IA | Si le texte correspond à quelque chose déjà publié |
Vérificateur de plagiat | Votre texte comparé à un index de pages web | Un pourcentage de correspondance avec du contenu existant | Si le texte a été écrit par une personne ou une IA |
Pourquoi le contenu dupliqué ou similaire inquiète les propriétaires de sites
L'inquiétude sous-jacente à une vérification de plagiat concerne en général le classement, et pas seulement l'originalité en soi. Il est utile de distinguer ce qui est documenté de ce qui est supposé.
Ce que dit Google sur le contenu dupliqué
La documentation de Google sur la consolidation des URL dupliquées décrit le contenu dupliqué comme des pages au contenu identique ou très similaire, et explique que Google essaie d'indexer la version qu'il considère comme canonique, plutôt que de pénaliser systématiquement chaque doublon. Il n'existe pas de pénalité distincte et nommée
Il n'existe pas de « pénalité pour contenu dupliqué » distincte et nommée dans la documentation de Google. Ce qui peut arriver, c'est que Google choisisse une version à afficher dans les résultats de recherche et traite les autres comme des doublons qu'il n'a pas besoin d'indexer séparément, ce qui peut signifier qu'une page pour laquelle vous vouliez être bien classé n'apparaît jamais comme un résultat distinct.
Pourquoi le contenu presque identique est différent d'une copie pure et simple
Deux pages qui traitent du même sujet utiliseront naturellement certains mots en commun. Une page sur la taille d'arbres et une page sur l'abattage d'arbres provenant de la même entreprise pourraient toutes deux mentionner « arboriste certifié » et « devis gratuit » sans que l'une ou l'autre pose problème. Le problème n'est pas le chevauchement en général. Ce sont de grands blocs de texte identiques ou presque identiques sur des pages censées être distinctes, ce qui est une chose différente et plus précise que deux pages qui couvrent simplement des sujets proches.
D'où vient la duplication accidentelle sur un site de petite entreprise
La plupart du contenu dupliqué sur un petit site d'entreprise ne résulte pas de la copie d'un concurrent. Il vient de raccourcis qui semblaient logiques à l'époque.
Duplication entre vos propres pages
Les pages de localisation et les pages de services sont la source la plus courante. Une entreprise qui compte cinq sites crée souvent cinq pages identiques à l'exception d'un nom de ville substitué, avec la description, le processus et les paragraphes sur les avantages copiés mot pour mot sur chacune. Notre guide sur le référencement local pour les petites entreprises et notre guide sur le SEO des pages de services expliquent tous deux pourquoi chaque page a besoin de quelque chose de vraiment spécifique pour exister par elle-même, plutôt que de compter sur un nom de lieu interchangeable pour se différencier.
Duplication provenant de sources externes
Les descriptions de produits copiées directement depuis la fiche technique d'un fabricant sont un autre cas fréquent, surtout sur un site qui vend des articles que des dizaines d'autres revendeurs proposent aussi. Un communiqué de presse ou un article syndiqué depuis une autre source et publié tel quel sur un blog en est un troisième. Aucun de ces cas ne vient d'une volonté de tromper qui que ce soit. C'est généralement le moyen le plus rapide de remplir une page, et le coût de ce raccourci est une page qui n'a rien de distinct à offrir dans les résultats de recherche.
Source de la duplication | Exemple | Pourquoi c'est important |
|---|---|---|
Pages de localisation en modèle | Cinq pages de villes au texte identique sauf le nom de la ville | Google n'affichera peut-être qu'une version, les autres restant invisibles dans la recherche |
Descriptions de produits copiées | Texte de fiche technique du fabricant collé tel quel sur une page produit | Le même texte apparaît souvent déjà sur des dizaines d'autres sites de revendeurs |
Articles syndiqués | Un communiqué de presse ou un article invité publié sans modification | La version de l'éditeur d'origine est généralement celle considérée comme canonique |
Texte standard réutilisé | Un long paragraphe « notre processus » collé sur chaque page de service | Dilue ce qui rend chaque page individuelle digne d'un classement par elle-même |
Comment fonctionne réellement une vérification de plagiat
Derrière le simple score en pourcentage, un vérificateur de plagiat effectue un travail assez mécanique. Il découpe votre texte en courtes expressions qui se chevauchent, généralement quelques mots à la fois, et compare chacune à un vaste index de pages web déjà explorées. Les expressions qui ressortent comme des correspondances exactes ou quasi exactes sont signalées, et l'outil calcule la part du document total que représentent ces expressions.
Ce que vous indique un pourcentage de correspondance
Un pourcentage de correspondance élevé est un signal utile : une part importante de votre brouillon existe déjà ailleurs, mot pour mot ou presque. Cela mérite une vérification, que la source soit un rédacteur indépendant qui a réutilisé un ancien travail, un modèle repris d'un autre site, ou un contenu copié par erreur pendant les recherches. Le pourcentage est un point de départ pour cette enquête, pas sa conclusion.
Ce que le pourcentage de correspondance ne peut pas vous dire
Un vérificateur ne peut pas dire qui a copié qui. Si votre ancienne page et un nouveau brouillon partagent un large bloc de texte, l'outil le signalera comme il signalerait une copie provenant du site d'un inconnu, même si les deux pages viennent de la même entreprise. Il ne peut pas non plus tenir compte des expressions courantes, des citations ou du vocabulaire standard de votre secteur qui se répètent légitimement sur de nombreux sites sans rapport. C'est pourquoi un score très bas ne prouve pas une originalité totale, et qu'un score modéré n'est pas automatiquement un problème. Lire les passages signalés compte davantage que réagir au seul chiffre.
Un contrôle de 15 minutes avant de publier
Un contrôle n'a pas besoin d'être compliqué pour repérer les problèmes qui comptent vraiment. Quinze minutes avant de publier suffisent pour couvrir l'essentiel.
Prenez trois ou quatre phrases distinctives au milieu du brouillon, pas la phrase d'accroche, et recherchez chacune entre guillemets pour voir si elle apparaît ailleurs mot pour mot.
Passez l'ensemble du brouillon dans un vérificateur de plagiat dédié et lisez les passages signalés plutôt que de vous contenter du pourcentage.
Comparez les paragraphes clés du brouillon avec les pages existantes de votre propre site sur un sujet similaire, car un outil conçu pour le web ouvert ne repère pas toujours les chevauchements avec les pages que vous possédez déjà.
Si le brouillon vient d'un freelance, vérifiez si les correspondances signalées renvoient vers ses autres travaux publiés, ce qui peut indiquer un contenu réutilisé pour plusieurs clients plutôt qu'une simple coïncidence.
Avant de passer à la suite, faites passer le titre et la méta description de la page dans les outils SEO gratuits de RepGet, car un titre à modèle répété sur plusieurs pages est un problème de contenu dupliqué SEO voisin, que le vérificateur de plagiat ne signalera jamais.
Inutile de payer un abonnement à un gros outil pour mener ce contrôle. Quelques recherches de phrases exactes et un passage par un vérificateur de plagiat gratuit permettent de repérer l'essentiel avant la mise en ligne.
Un exemple concret : repérer un paragraphe copié avant sa mise en ligne
Imaginez une petite entreprise de nettoyage à domicile qui s'étend dans cinq villes voisines. Cet exemple est illustratif.
Le gérant crée une page pour chaque ville à partir du même modèle : un titre où le nom de la ville est remplacé, une courte introduction, une liste de services et un paragraphe de conclusion sur la demande de devis. Pour gagner du temps, la liste des services et le paragraphe de conclusion sont copiés directement depuis la page d'origine dans les cinq nouvelles pages, seuls le titre et une phrase près du début étant modifiés pour chaque ville.
Avant la publication, le gérant passe chaque nouvelle page dans un vérificateur de plagiat, une habitude héritée de la vérification du travail des freelances. Quatre pages sur cinq affichent un fort taux de correspondance, non pas avec le site d'un inconnu, mais avec la page d'origine de l'entreprise et entre elles.
Les passages signalés sont exactement ceux auxquels on pouvait s'attendre : la liste des services et le paragraphe de conclusion, mot pour mot, répétés cinq fois avec seulement un nom de ville différent. Cette correspondance n'a rien d'un vol. Elle indique surtout que les pages ne disent rien de distinct les unes des autres.
La correction prend une après-midi, pas une réécriture complète. Le gérant conserve la même structure de base pour les cinq pages, mais rédige un paragraphe réellement différent pour chaque ville, décrivant des quartiers précis desservis, un point de repère local près du bureau, ou un détail sur le parc immobilier de la ville qui influe sur le type de nettoyage demandé. La liste des services reste similaire, puisque les services sont bel et bien les mêmes, mais le texte environnant qui faisait de chaque page une copie quasi conforme des autres a disparu.
Personne n'aurait repéré ce problème en lisant une seule page isolément. Il n'est apparu que parce que les pages ont été comparées entre elles, ce que le contrôle de plagiat a permis ici, alors que l'inquiétude initiale du gérant concernait un freelance et non ses propres pages à modèle.
Quand un contrôle de plagiat en vaut vraiment la peine
Un contrôle de plagiat n'est pas nécessaire pour chaque article de blog avant sa publication. Il mérite ses quinze minutes dans certaines situations précises, et savoir les reconnaître est plus utile que de le lancer par réflexe sur tout.
Situation | Un contrôle en vaut la peine ? | Pourquoi |
|---|---|---|
Contenu d'un freelance ou d'une agence avec qui vous n'avez pas encore travaillé | Oui | Aucun historique pour juger si les brouillons sont rédigés à neuf à chaque fois |
Pages à modèle pour plusieurs lieux, services ou produits | Oui | Le modèle lui-même est la source la plus courante de contenu dupliqué SEO involontaire, comme dans l'exemple ci-dessus |
Contenu assemblé à partir de plusieurs documents sources ou de notes de recherche | Oui | Il est facile de copier une phrase d'un document source sans la reformuler pendant une relecture pressée |
Article rédigé rapidement avec l'aide de l'IA et peu relu | Oui | Les outils de rédaction par IA peuvent parfois reprendre des formulations proches de leurs sources d'entraînement, d'où l'intérêt d'un contrôle rapide avant publication |
Rédacteur de longue date avec un travail original établi | Cela dépend | Risque plus faible, mais un contrôle ponctuel permet encore de repérer un écart rare |
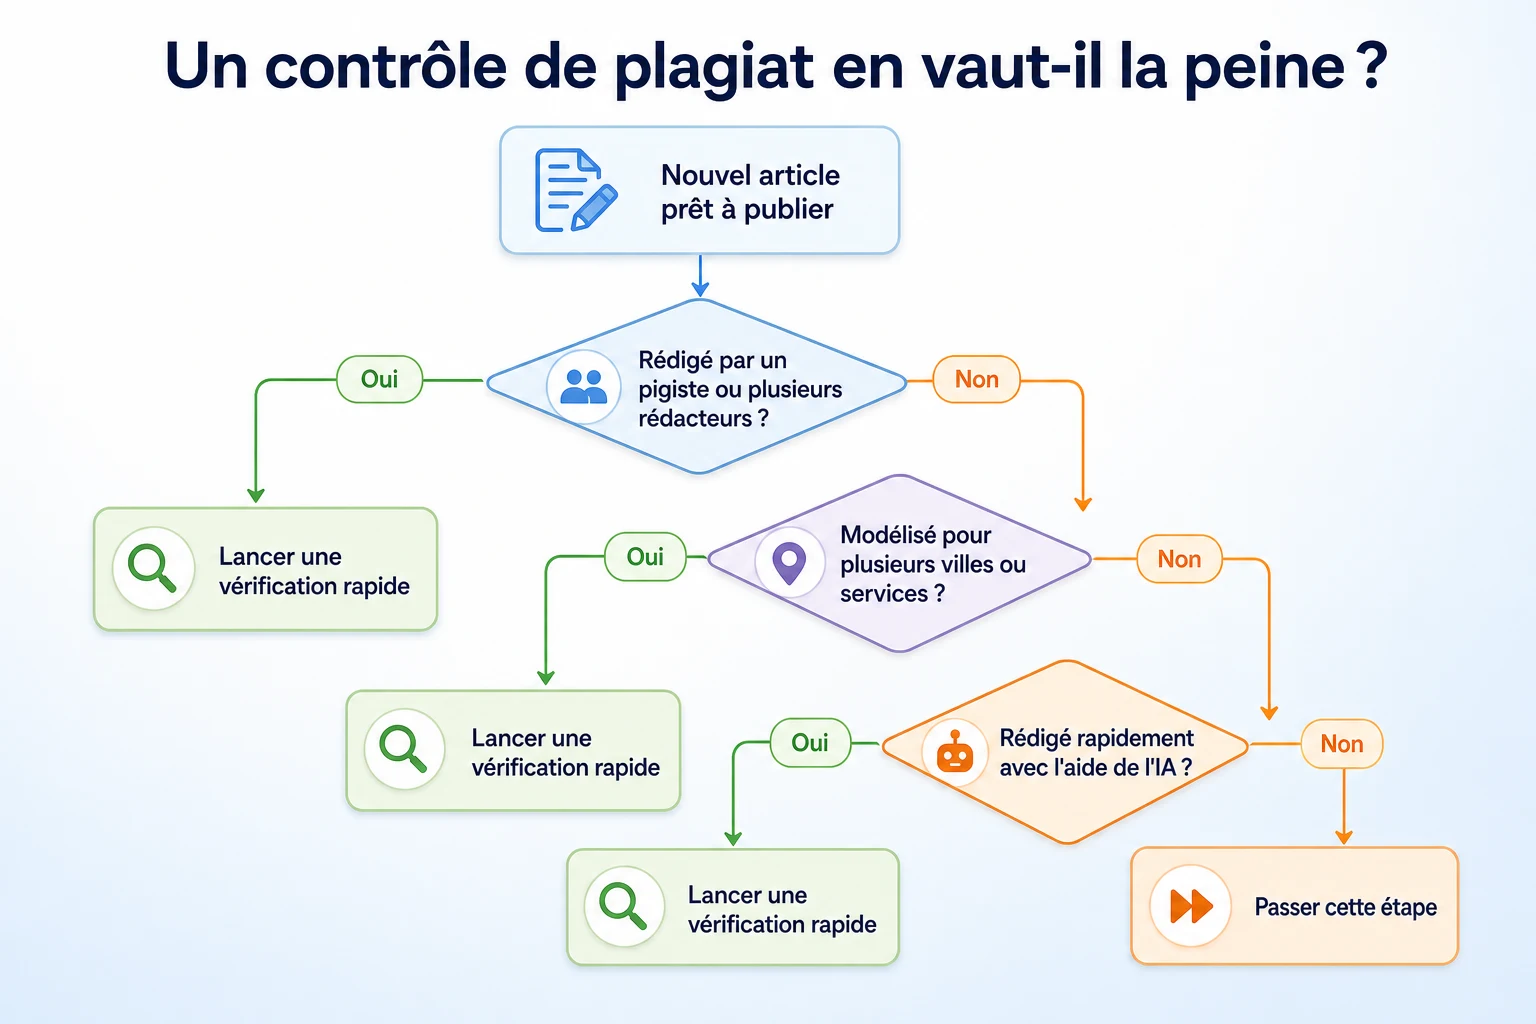
Le point commun des situations qui méritent un contrôle est la distance entre le rédacteur et le texte final. Un freelance avec qui vous n'avez jamais travaillé, un modèle rempli par la personne disponible cette semaine-là, ou un outil d'IA qui produit une première version introduisent tous une étape où le texte peut se retrouver plus proche d'un autre texte que ce que quiconque voulait. Le contrôle sert à repérer cet écart, sans mettre en doute l'honnêteté de qui que ce soit par principe.
Quand vous pouvez vous passer de cette étape
Lancer un contrôle de plagiat sur chaque article, quelle que soit sa méthode de rédaction, transforme une bonne habitude en corvée peu utile. Quelques situations peuvent raisonnablement s'en passer.
Un court article rédigé d'un bout à l'autre par une seule personne de votre équipe, à partir de sa propre connaissance de l'entreprise plutôt que de recherches externes, n'a généralement pas besoin d'un contrôle formel. Le risque de chevauchement involontaire est faible, car aucun modèle n'est copié et aucun document source n'est reformulé à la hâte.
Un contenu qui a déjà fait l'objet d'une relecture éditoriale interne, où quelqu'un a comparé le brouillon au brief et confirmé qu'il dit quelque chose de précis sur votre entreprise, a en pratique déjà vu son originalité vérifiée, simplement sans pourcentage associé.
Les mentions juridiques ou de politique standard, comme une politique de confidentialité ou une clause d'expédition type, gagnent à être exclues d'un contrôle de plagiat. Ce type de texte doit ressembler de près à ce que publient des milliers d'autres sites, car il est souvent adapté des mêmes modèles juridiques pour de bonnes raisons. Un outil le signalera à chaque fois sans rien vous apprendre d'utile.
Renoncer au contrôle dans ces cas n'est pas un raccourci. C'est reconnaître que le contrôle sert à traiter un risque précis, et que le lancer là où ce risque est absent ajoute une étape sans véritable intérêt.
Erreurs courantes lors de la vérification du contenu dupliqué
Un vérificateur de plagiat n'est utile que si l'on sait lire son résultat. Quelques mauvaises habitudes transforment une étape vraiment utile en fausse alerte ou en problème passé inaperçu.
Prendre un pourcentage de correspondance pour une preuve de plagiat est l'erreur la plus fréquente. Un score à lui seul ne dit pas qui a copié qui, ni si la correspondance correspond à une statistique citée, à une expression courante du secteur ou à une véritable reprise du travail d'un autre auteur. Lire ce qui est signalé, et pas seulement le chiffre, est la partie qui vous apprend réellement quelque chose.
Ne vérifier que le web ouvert en oubliant votre propre site est une autre erreur. Comme l'exemple de l'entreprise de nettoyage l'a montré, un outil conçu pour parcourir internet ne compare pas automatiquement un nouveau brouillon aux pages que vous possédez déjà. La source la plus courante de duplication involontaire sur le site d'une petite entreprise peut donc passer inaperçue lors d'une vérification qui semble pourtant complète.
S'alarmer à cause de mentions standard ou de citations est une troisième erreur. Une citation reprise, une statistique citée avec sa formulation d'origine ou un texte juridique standard déclenchent souvent une correspondance, et rien de tout cela ne justifie de tout réécrire. La solution consiste à identifier quelles alertes sont attendues avant de décider si l'une d'elles mérite une action.
Oublier les titres et les balises méta est une quatrième erreur, et elle est facile à commettre, car un vérificateur de plagiat est conçu pour analyser le corps du texte, et non les champs plus courts qui l'entourent. Une balise titre modèle, répétée en changeant seulement le nom d'une ville ou d'un produit, constitue une forme de duplication qui se comporte différemment dans les résultats de recherche. Elle se rapproche de la cannibalisation des mots-clés, abordée dans notre guide, où deux pages de votre propre site finissent par se concurrencer au lieu de voir l'une d'elles clairement se démarquer.
Erreur | Ce que cela entraîne | Solution |
|---|---|---|
Prendre le pourcentage pour un verdict | Réécrire des passages qui n'ont jamais posé de problème | Lire le texte signalé avant de décider qu'il doit être modifié |
Ne vérifier que le web ouvert | Passer à côté de la duplication entre vos propres pages | Comparer directement les nouveaux brouillons à vos pages existantes |
Réagir aux citations ou mentions standard signalées | Perdre du temps à réécrire des textes censés correspondre | S'attendre à des correspondances sur les citations et les textes juridiques standard |
Ignorer les titres et les balises méta | Des pages qui se concurrencent dans les résultats de recherche | Vérifier les titres séparément, car un outil d'analyse du corps du texte ne le détectera pas |
Où se situe RepGet
RepGet n'effectue pas de vérification de plagiat ni d'analyse de détection de contenu IA, et il n'est pas conçu pour comparer un brouillon aux résultats de GPTZero ou à la base de données de tout autre outil spécialisé. Si c'est précisément la vérification dont vous avez besoin avant publication, les étapes présentées plus haut dans ce guide, à savoir les recherches de phrases exactes et un vérificateur spécialisé, restent la bonne méthode.
RepGet couvre en revanche le problème plus large que révèle souvent le contenu dupliqué. Son audit de site web gratuit analyse un site et lui attribue un score SEO de 0 à 100, en signalant les problèmes de contenu à examiner, notamment les signes de pages trop minces, répétitives ou trop similaires entre elles pour exister seules dans les résultats de recherche. Aucun compte ni carte bancaire n'est nécessaire. C'est un moyen raisonnable de repérer un ensemble de pages de localisation ou de services construit sur le même modèle, avant même qu'une vérification de plagiat ne devienne nécessaire, car l'audit examine l'ensemble du site et non un brouillon à la fois.
RepGet ne garantit aucun classement et ne vous dit pas si un paragraphe précis a été copié à partir d'une source précise. C'est un moyen de voir où le contenu d'un site pourrait mériter un examen plus attentif, et non un substitut au jugement décrit tout au long de ce guide.
En résumé
Une recherche sur le vérificateur de plagiat GPT Zero part généralement d'une question légitime : ce contenu est-il réellement original ? GPTZero lui-même ne répond pas à cette question, puisqu'il est conçu pour estimer si un texte a été généré par une IA, et non pour le comparer à d'autres pages publiées. Un vérificateur de plagiat spécialisé remplit cette seconde fonction, et il vaut la peine d'être utilisé lorsque le contenu provient d'un nouveau pigiste, d'un ensemble de pages construit sur un modèle, d'un document assemblé à partir de notes de recherche ou d'un brouillon rapide rédigé avec l'aide d'une IA.
Le contenu dupliqué n'est pas sanctionné de la façon dont beaucoup de propriétaires de sites l'imaginent. La documentation de Google explique qu'il choisit une version à afficher plutôt que d'appliquer une pénalité générale, mais une page que vous souhaitiez positionner peut tout de même devenir invisible si elle est trop proche d'une autre, sur votre site ou sur celui de quelqu'un d'autre. Une vérification de quinze minutes avant publication permet de repérer l'essentiel, et ne pas la faire pour un billet court et original rédigé par votre équipe ne revient pas à faire un raccourci. Il s'agit simplement de proportionner l'effort au risque réel.
Découvrez d'abord ce dont votre site a besoin
Avant de vous inquiéter pour un seul brouillon, il vaut la peine de vérifier si un contenu dupliqué ou mince est déjà un schéma récurrent sur votre site. Lancez un audit de site web gratuit avec RepGet pour vérifier les problèmes de contenu et techniques à corriger. Aucun compte ni carte bancaire n'est nécessaire.
Questions fréquentes
GPTZero est-il un vérificateur de plagiat ?
Pas vraiment. GPTZero est conçu comme un détecteur de contenu IA qui estime la probabilité qu'un texte ait été écrit par un modèle d'IA, et non comme un outil qui compare votre brouillon avec d'autres pages publiées sur le web.
Quelle est la différence entre un vérificateur de plagiat et un détecteur de contenu IA ?
Un vérificateur de plagiat compare votre texte à un index de pages web et signale les correspondances mot pour mot. Un détecteur de contenu IA analyse les habitudes d'écriture et estime si le texte a été généré par une IA, ce qui répond à une tout autre question.
Google pénalise-t-il le contenu dupliqué ?
La documentation de Google ne prévoit aucune pénalité distincte pour le contenu dupliqué. En revanche, Google tend à choisir une seule version des pages presque identiques à afficher dans les résultats de recherche, ce qui peut rendre les autres pratiquement invisibles.
Comment vérifier si mon article de blog est plagié ?
Recherchez entre guillemets quelques phrases caractéristiques du milieu de l'article, passez votre brouillon dans un vérificateur de plagiat dédié et comparez-le aux pages existantes de votre site sur des sujets proches.
Existe-t-il des vérificateurs de plagiat gratuits pour les articles de blog ?
Oui, plusieurs vérificateurs de plagiat gratuits existent en ligne. Ils comparent un brouillon à un index de pages web et affichent un pourcentage de correspondance, mais la plupart limitent la quantité de texte que vous pouvez vérifier à la fois sans abonnement payant.
Deux pages de mon propre site peuvent-elles être considérées comme du contenu dupliqué ?
Oui. Les pages de localisation ou de services modélisées avec un texte identique sont une source fréquente de ce problème, et un vérificateur de plagiat signalera ce chevauchement de la même façon qu'une correspondance avec le site d'un inconnu.
Faut-il vérifier le plagiat des contenus rédigés avec l'IA ?
C'est une bonne habitude, car les outils de rédaction par IA peuvent parfois reprendre des formulations proches de leurs sources d'entraînement. Une vérification rapide avant publication permet de le repérer sans alourdir beaucoup votre processus de relecture.
Quel pourcentage de correspondance est trop élevé pour du plagiat ?
Il n'existe pas de seuil fixe. Un score modéré composé de citations ou d'expressions courantes ne pose pas de problème, alors qu'un score plus faible mérite d'être examiné s'il révèle de grands blocs de texte copiés sans mention de leur source.